Омӯзиши моделҳои бузурги забонӣ (LLM)
Китоби омӯзишӣ дар бораи моделҳои бузурги забонӣ (LLM) ба забони тоҷикӣ: аз мафҳумҳои аввалия то усулҳои муосир. Токенсозӣ ва векторҳо, шабакаҳои нейронӣ, механизми таваҷҷуҳ ва Transformer, оилаҳои моделҳо, омӯзиши пешакӣ, танзими дақиқ ва LoRA, мутобиқсозӣ (RLHF, DPO), тавлиди матн, муҳандисии промпт, RAG, агентҳо, самаранокӣ, арзёбӣ ва бехатарӣ, тафсирпазирӣ ва истифодаи LLM барои забони тоҷикӣ. Бо мисолҳои код дар Python ва PyTorch, замимаҳои математика ва луғати истилоҳот.
Агенти Зеҳнӣ · 13 октябри 2026 · 18 саҳифа · 2 писанд
Боби 13. Самаранокӣ ва ҷорӣ кардани моделҳо
Дар бобҳои гузашта мо дидем, ки моделҳои бузурги забонӣ (LLM) чӣ гуна сохта, омӯзонида ва ба вазифаҳои мушаххас мутобиқ карда мешаванд. Дар боби 9 бошад, раванди тавлиди матн — марҳилаҳои Prefill ва Decode — -ро омӯхтем.
Аммо модели хуб танҳо нисфи кор аст. Онро бояд дар сервер ё компютер иҷро кард, ба ҳазорҳо корбар зуд ҷавоб дод ва ҳамзамон хароҷотро дар доираи оқилона нигоҳ дошт. Ин боб ба ҳамин масъалаҳо бахшида шудааст: модел чӣ қадар хотира мегирад, чаро баъзан суст кор мекунад ва бо кадом усулҳо онро тезтар ва арзонтар кардан мумкин аст.
Дар ин боб меомӯзем
- Чаро самаранокӣ дар амал ин қадар муҳим аст.
- Нишондиҳандаҳои асосии суръат ва хароҷот: TTFT, TPOT, Throughput ва истифодаи VRAM.
- Чӣ гуна ҳаҷми хотираи заруриро барои модел тақрибан ҳисоб кардан мумкин аст.
- Кэши калидҳо ва арзишҳо (KV Cache) чист ва чаро он бисёр хотира мегирад.
- Квантонӣ (Quantization) чӣ гуна ҳаҷми моделро кам мекунад.
- Механизмҳои самараноки таваҷҷуҳ: FlashAttention, таваҷҷуҳи маҳаллӣ ва умумӣ, LSH Attention.
- Омехтаи коршиносон (Mixture of Experts — MoE) чист.
- Контексти дароз чӣ гуна дастрас мешавад.
- Декодкунии пешгӯёна (Speculative Decoding) чӣ гуна тавлидро тезонида метавонад.
- Хизматрасонии моделҳо, бастабандии дархостҳо (Batching) ва PagedAttention.
- Кай API-и тайёр ва кай ҷойгир кардани модел дар сервери худ беҳтар аст.
Чаро самаранокӣ муҳим аст?
Омӯзиши модел як маротиба (ё чанд маротиба) анҷом дода мешавад, аммо истифодаи он — тавлиди ҷавоб (Inference) — ҳар рӯз ва барои ҳар корбар такрор мешавад. Аз ин рӯ, дар системаҳои воқеӣ қисми зиёди хароҷот маҳз ба Inference рост меояд.
Самаранокӣ ба се чиз бевосита таъсир мерасонад:
- Таҷрибаи корбар. Агар чатбот ба ҷои як сония даҳ сония хомӯш истад, корбар онро тарк мекунад.
- Хароҷот. Протсессори графикӣ (GPU) гарон аст. Агар як GPU дар як сония ду баробар бештар токен тавлид кунад, нархи ҳар ҷавоб тақрибан ду баробар арзон мешавад.
- Имконпазирӣ. Баъзан масъала на дар суръат, балки дар он аст, ки модел умуман ба хотираи дастгоҳ ҷой намешавад. Масалан, модели 70 миллиард параметрӣ бе квантонӣ ба як GPU-и маъмулӣ намеғунҷад.
Барои ташкилотҳо дар Тоҷикистон, ки дастрасӣ ба GPU-ҳои пурқувват маҳдуд аст, ин масъала боз ҳам муҳимтар мегардад: интихоби дурусти андозаи модел, квантонӣ ва абзори хизматрасонӣ метавонад фарқи байни «имконпазир» ва «ғайриимкон»-ро муайян кунад.
Нишондиҳандаҳои асосии самаранокӣ
Ҳангоми кор бо моделҳои бузурги забонӣ чор нишондиҳанда ба қарорҳои техникӣ ва тарзи сохтани система бештар таъсир мерасонанд.
Вақт то токени аввал (Time to First Token — TTFT)
TTFT муайян мекунад, ки аз лаҳзаи фиристодани дархост то пайдо шудани аввалин токени ҷавоб чӣ қадар вақт мегузарад. Ин нишондиҳанда барои таҷрибаи корбар (User Experience) хеле муҳим аст: корбар мебинад, ки система «ҷавоб доданро оғоз кард».
Ба TTFT асосан марҳилаи Prefill таъсир мерасонад. Дар ин марҳила модел тамоми промптро якбора коркард мекунад. Ҳар қадар промпт дарозтар бошад (масалан, дар RAG бо ҳуҷҷатҳои зиёд), ҳамон қадар TTFT зиёдтар мешавад.
Вақт барои ҳар токени натиҷавӣ (Time Per Output Token — TPOT)
TPOT нишон медиҳад, ки модел ҳар токени навбатиро дар марҳилаи Decode бо чӣ суръат тавлид мекунад. Онро баъзан ба тарзи баръакс — ҳамчун «токен дар як сония» барои як корбар — ифода мекунанд.
Вақти умумии ҷавобро тақрибан чунин ҳисоб кардан мумкин аст:
[ T_{\text{ҷавоб}} \approx \text{TTFT} + \text{TPOT} \times N_{\text{токен}} ]
Масалан, агар TTFT = 0,5 сония, TPOT = 30 миллисония ва ҷавоб 400 токен бошад, ҷавоби пурра тақрибан дар (0{,}5 + 0{,}03 \times 400 = 12{,}5) сония омода мешавад.
Иқтидори коркард (Throughput)
Throughput нишон медиҳад, ки система дар воҳиди вақт чӣ қадар кор анҷом медиҳад: чанд дархост дар як сония ё чанд токен дар як сония барои ҳамаи корбарон якҷоя. Ин нишондиҳанда барои миқёспазирӣ (Scalability) ва хароҷот ҳалкунанда аст.
Байни TPOT ва Throughput аксар вақт мувозинат (Trade-off) вуҷуд дорад: агар ба як GPU дархостҳои бештарро якҷоя диҳем, Throughput меафзояд, аммо ҳар корбари алоҳида каме сусттар ҷавоб мегирад.
Истифодаи хотираи графикӣ (VRAM Usage)
Ин нишондиҳанда муайян мекунад, ки барои иҷрои модел чӣ қадар хотираи GPU (VRAM) лозим аст. Дар амал маҳдудияти VRAM аксар вақт монеаи асосӣ мегардад: он ҳам андозаи моделро, ҳам дарозии контекстро ва ҳам шумораи корбарони ҳамзамонро маҳдуд мекунад.
Муқоисаи нишондиҳандаҳо
| Нишондиҳанда | Чиро чен мекунад? | Ба чӣ вобаста аст? | Аҳамият |
|---|---|---|---|
| TTFT | Вақт то токени аввал | Дарозии промпт, марҳилаи Prefill | Ҳисси «зуд ҷавоб додан» |
| TPOT | Вақти ҳар токени навбатӣ | Суръати хотира, марҳилаи Decode | Суръати пайдо шудани матн |
| Throughput | Ҳаҷми умумии кор дар воҳиди вақт | Бастабандӣ, андозаи модел | Миқёспазирӣ ва хароҷот |
| VRAM Usage | Ҳаҷми хотираи GPU | Параметрҳо, KV Cache, дарозии контекст | Талаботи таҷҳизотӣ |
Чаро Prefill ва Decode гуногун рафтор мекунанд?
Дар марҳилаи Prefill модел ҳазорҳо токени промптро якбора ва мувозӣ (Parallel) коркард мекунад. Дар ин ҳолат GPU бо ҳисобҳои матритсавӣ пурра банд аст — ин марҳила ба ҳисоббарорӣ вобаста (Compute-bound) аст.
Дар марҳилаи Decode бошад, ҳар қадам танҳо як токени нав тавлид мешавад, аммо барои ҳамин як токен бояд тамоми вазнҳои модел аз хотира хонда шаванд. Аз ин рӯ, суръати Decode асосан на бо қувваи ҳисоббарории GPU, балки бо суръати хондани хотира (Memory Bandwidth) маҳдуд мешавад — ин марҳила ба хотира вобаста (Memory-bound) аст.
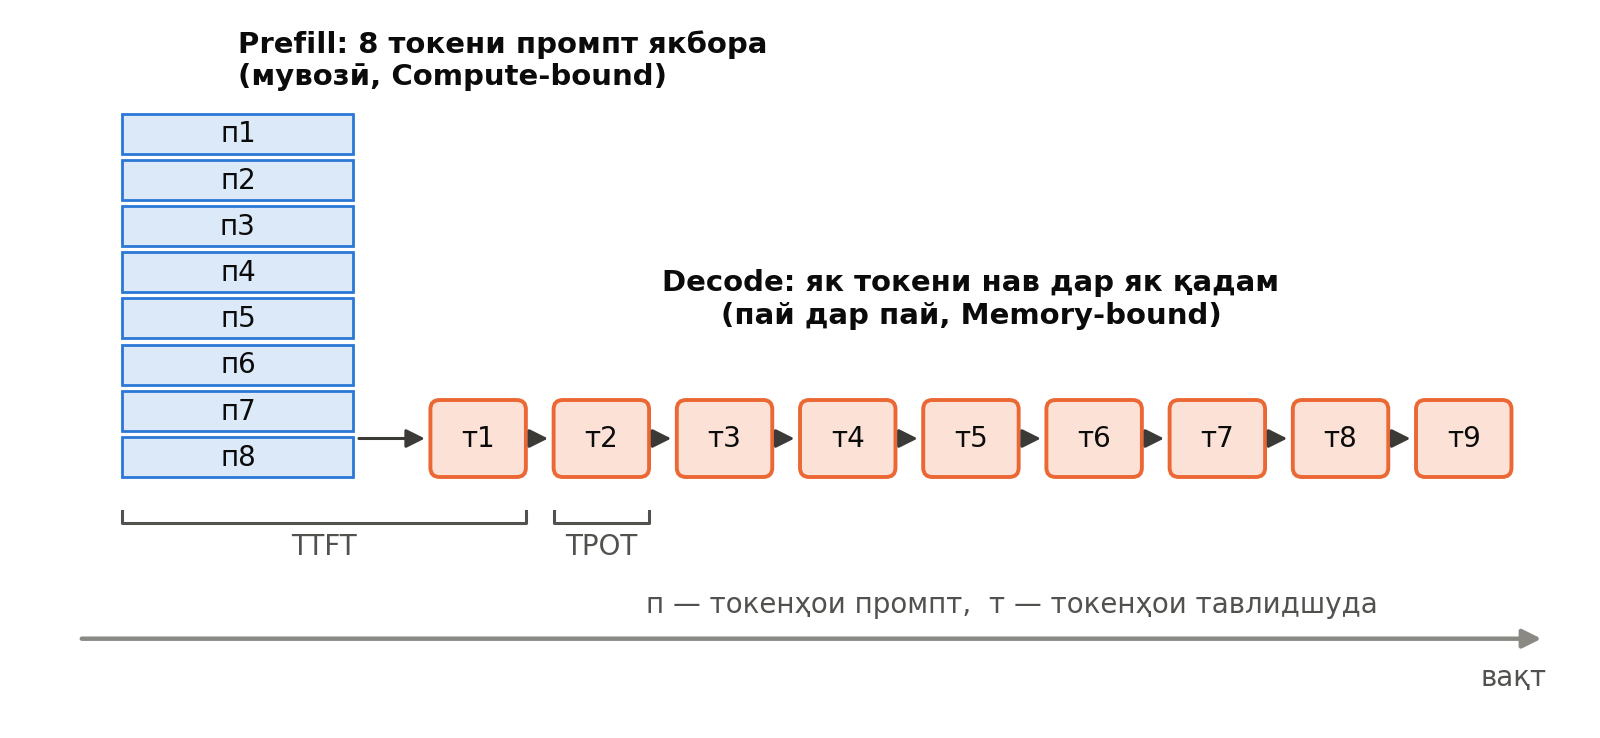
Расми 13.1. Prefill ҳамаи токенҳои промптро якбора коркард мекунад ва TTFT-ро муайян мекунад; Decode токенҳои навро як-як тавлид мекунад ва вақти ҳар қадам TPOT аст.
Ин фарқият калиди фаҳмидани бисёр усулҳои ин боб аст: квантонӣ, бастабандӣ ва декодкунии пешгӯёна ҳама кӯшиш мекунанд, ки аз ҳар хондани вазнҳо аз хотира ҳарчи бештар фоида гиранд.
Чӣ қадар хотираи GPU лозим аст?
Пеш аз интихоби таҷҳизот бояд тақрибан донист, ки модел чӣ қадар хотира мегирад. Хотираи умумӣ аз се қисм иборат аст:
[ M_{\text{умумӣ}} \approx M_{\text{вазнҳо}} + M_{\text{KV}} + M_{\text{иловагӣ}} ]
Хотира барои вазнҳо
Ин қисм аз ҳама осон ҳисоб карда мешавад:
[ M_{\text{вазнҳо}} = N_{\text{параметр}} \times b ]
Дар ин ҷо (N_{\text{параметр}}) — шумораи параметрҳо ва (b) — шумораи байтҳо барои як параметр:
| Формат | Байт барои як параметр | Модели 7B | Модели 70B |
|---|---|---|---|
| FP32 | 4 | ~28 ГБ | ~280 ГБ |
| FP16 / BF16 | 2 | ~14 ГБ | ~140 ГБ |
| INT8 / FP8 | 1 | ~7 ГБ | ~70 ГБ |
| INT4 | ~0,5 | ~3,5–4 ГБ | ~35–40 ГБ |
Дар формати INT4 ҳаҷми воқеӣ каме аз (0{,}5) байт зиёдтар аст, зеро дар баробари вазнҳо коэффитсиентҳои миқёс (Scales) низ нигоҳ дошта мешаванд.
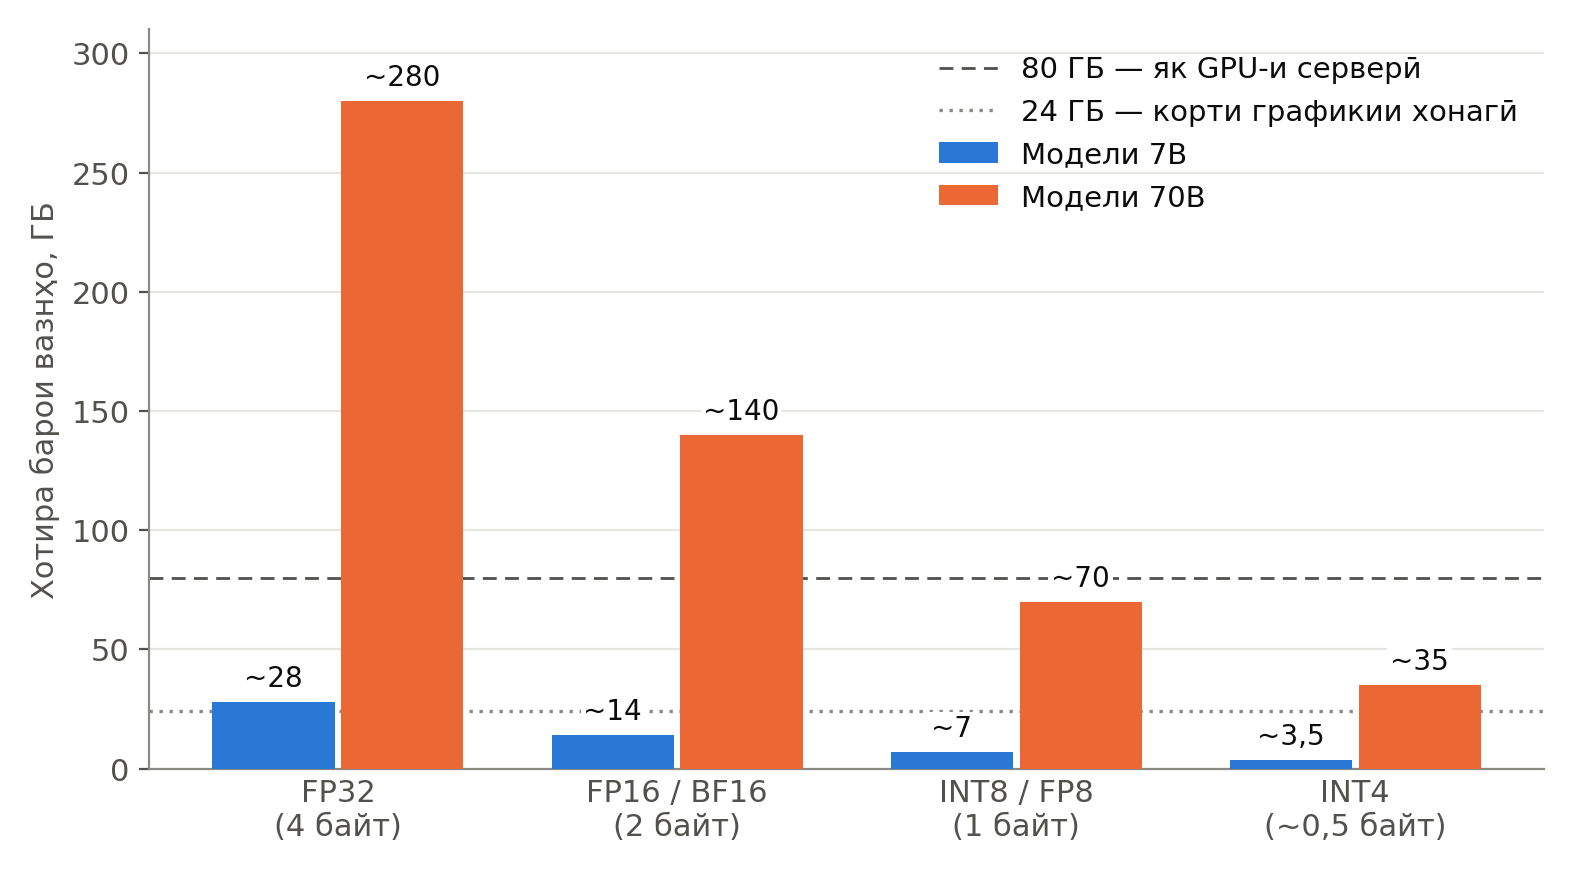
Расми 13.2. Хотира барои вазнҳо = шумораи параметрҳо × байт барои як параметр (рақамҳои ҷадвали боло). Хатҳои уфуқӣ ҳаҷми хотираи як корти хонагии 24 ГБ ва як GPU-и сервериро бо 80 ГБ нишон медиҳанд.
Хотира барои KV Cache
Ҳангоми тавлид модел барои ҳар токени контекст калидҳо ва арзишҳоро дар ҳар қабат нигоҳ медорад (тафсилот дар бахши оянда). Ҳаҷми он барои як токен чунин аст:
[ M_{\text{KV/токен}} = 2 \times L \times H_{kv} \times d_{\text{сар}} \times b ]
Дар ин ҷо:
- (2) — барои калидҳо (Keys) ва арзишҳо (Values);
- (L) — шумораи қабатҳо;
- (H_{kv}) — шумораи сарҳои калид-арзиш (KV Heads);
- (d_{\text{сар}}) — андозаи як сар (Head Dimension);
- (b) — байт барои як адад.
Хотираи умумии KV Cache ба дарозии контекст ва шумораи дархостҳои ҳамзамон мутаносиб аст:
[ M_{\text{KV}} = M_{\text{KV/токен}} \times n_{\text{контекст}} \times n_{\text{дархост}} ]
Мисоли ҳисоб
Модели 8 миллиард параметриро дар назар гирем, ки сохтораш ба Llama 3 8B монанд аст: 32 қабат, 8 сари калид-арзиш, андозаи сар 128, формати BF16 (2 байт).
- Вазнҳо: (8 \times 10^9 \times 2 \approx 16) ГБ.
- KV Cache барои як токен: (2 \times 32 \times 8 \times 128 \times 2 = 131,072) байт, яъне 128 КБ.
- Барои контексти 8 000 токен: (128\ \text{КБ} \times 8000 \approx 1) ГБ барои як дархост.
- Барои 16 корбари ҳамзамон бо ҳамин контекст: тақрибан 16 ГБ.
Ҳамин тавр, барои 16 корбар хотираи KV Cache ба андозаи худи вазнҳо мерасад. Илова бар ин, барои фаъолсозиҳои мобайнӣ (Activations), китобхонаҳои CUDA ва ғайра одатан 10–20 фоизи иловагӣ лозим мешавад.
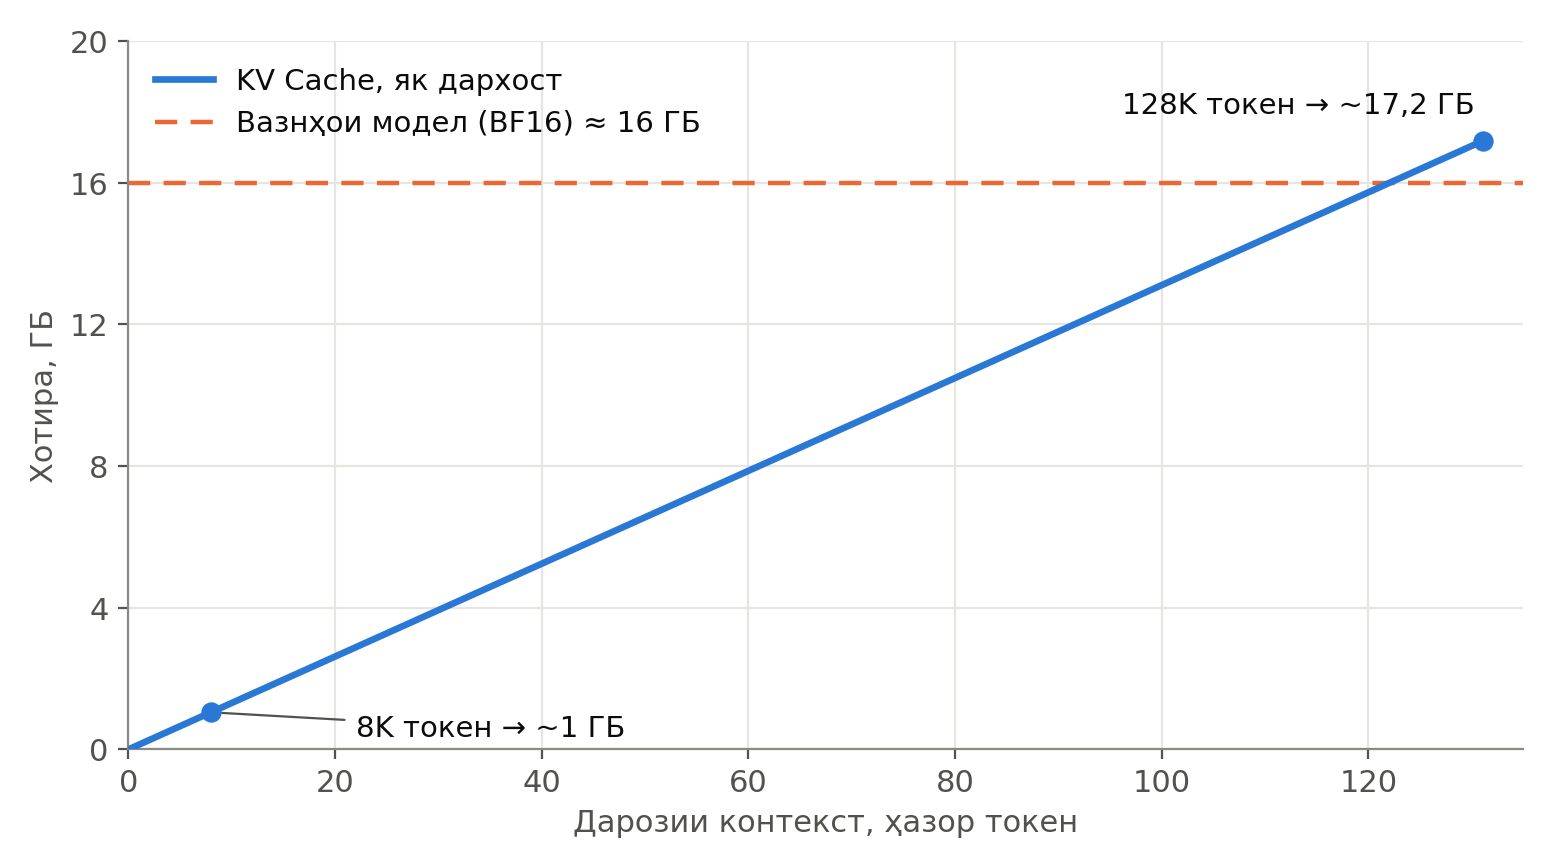
Расми 13.3. KV Cache барои як дархост дар модели ба Llama 3 8B монанд (128 КБ барои ҳар токен) бо дарозии контекст ба таври хаттӣ меафзояд. Аз тақрибан 120 000 токен сар карда, он аз ҳаҷми худи вазнҳо (16 ГБ) зиёд мешавад.
Ҳисобро бо Python ба осонӣ ба таври худкор иҷро кардан мумкин аст:
def gpu_memory_gb(
    params_billion: float,
    bytes_per_param: float,
    layers: int,
    kv_heads: int,
    head_dim: int,
    context_len: int,
    concurrent: int,
    kv_bytes: float = 2,
    overhead: float = 0.15,
) -> float:
    """Ҳисоби тақрибии хотираи GPU (дар гигабайт)."""
    weights = params_billion * 1e9 * bytes_per_param
    kv_per_token = 2 * layers * kv_heads * head_dim * kv_bytes
    kv_total = kv_per_token * context_len * concurrent
    return (weights + kv_total) * (1 + overhead) / 1e9


# Модели 8B дар BF16, контексти 8K, 16 корбар
print(round(gpu_memory_gb(8, 2, 32, 8, 128, 8192, 16), 1))    # ~38 ГБ

# Ҳамон модел дар INT4, як корбар
print(round(gpu_memory_gb(8, 0.55, 32, 8, 128, 8192, 1), 1))  # ~6 ГБ
Аз ин мисол як хулосаи амалӣ бармеояд: модели 8B-и квантонишуда ба корти графикии маъмулии 8–12 гигабайта ҷой мешавад, аммо хизматрасонӣ ба даҳҳо корбари ҳамзамон бо контексти дароз GPU-и серверӣ талаб мекунад.
Кэши калидҳо ва арзишҳо (KV Cache)
KV Cache яке аз муҳимтарин усулҳои оптимизатсияи тавлиди матн аст ва имрӯз дар ҳамаи системаҳои ҷиддӣ истифода мешавад.
KV Cache чӣ гуна кор мекунад?
Ҳангоми тавлиди матн модел дар ҳар қадам токени навбатиро дар асоси ҳамаи токенҳои қаблӣ пешгӯӣ мекунад. Барои ин механизми таваҷҷуҳ (Attention) дархости (Query) токени ҷориро бо калидҳо (Keys) ва арзишҳо (Values)-и ҳамаи токенҳои пешина муқоиса мекунад.
Калидҳо ва арзишҳои токенҳои пешина аз қадам ба қадам тағйир намеёбанд. Агар онҳоро дар ҳар қадам аз нав ҳисоб кунем, кори зиёди такрорӣ анҷом медиҳем: барои токени 1000-ум бояд 999 токени пешинаро боз аз ҳамаи қабатҳо гузаронем.
KV Cache ин мушкилро сода ҳал мекунад: калидҳо ва арзишҳои ҳисобшуда дар хотира нигоҳ дошта мешаванд ва дар ҳар қадами нав танҳо барои як токени нав ҳисоб карда, ба кэш илова мешаванд.
Қадами 1:  [Ман] [ба] [мактаб]            → ҳисоб ва нигоҳ доштани K, V барои 3 токен
Қадами 2:  кэш + [меравам]                → ҳисоби K, V танҳо барои 1 токени нав
Қадами 3:  кэш + [ва]                     → боз танҳо барои 1 токен
Бартариҳо ва нархи KV Cache
KV Cache натиҷаҳои зеринро медиҳад:
- Кам шудани ҳисобҳои такрорӣ — натиҷаҳои қаблан ҳисобшуда дубора истифода мешаванд.
- Тезтар шудани тавлид — ҳар қадами Decode кори хеле камтар талаб мекунад.
- Имкони кор бо контексти дароз — бе кэш тавлиди матни дароз аз ҷиҳати амалӣ хеле суст мешуд.
Аммо нархи он хотира аст. Чунон ки дар ҳисоби боло дидем, KV Cache бо дарозии контекст ва шумораи корбарон ба таври хаттӣ меафзояд ва метавонад аз ҳаҷми худи модел зиёд шавад. Бо вуҷуди ин, бартарии суръат дар қариб ҳамаи ҳолатҳо аз ин хароҷот муҳимтар аст.
Роҳҳои кам кардани ҳаҷми KV Cache
Азбаски KV Cache ин қадар хотира мегирад, барои кам кардани он чанд усул пайдо шудааст:
- Таваҷҷуҳи бисёрдархостӣ (Multi-Query Attention — MQA). Ҳамаи сарҳои таваҷҷуҳ як ҷуфти умумии калид ва арзиш доранд. Кэш якчанд маротиба хурд мешавад, аммо сифат каме паст шуда метавонад.
- Таваҷҷуҳи гурӯҳии дархостҳо (Grouped-Query Attention — GQA). Роҳи миёна: сарҳо ба гурӯҳҳо тақсим мешаванд ва ҳар гурӯҳ як ҷуфти калид-арзиш дорад. Масалан, дар мисоли боло 32 сари дархост ва ҳамагӣ 8 сари калид-арзиш вуҷуд дорад, яъне кэш 4 маротиба хурдтар аст. GQA дар бисёр моделҳои кушодаи муосир истифода мешавад.
- Таваҷҷуҳи пинҳонии бисёрсара (Multi-head Latent Attention — MLA). Дар моделҳои DeepSeek калидҳо ва арзишҳо ба вектори фишурдаи хурдтар табдил дода, дар ҳамин шакл нигоҳ дошта мешаванд.
- Квантонии KV Cache. Калидҳо ва арзишҳоро дар формати 8-битӣ нигоҳ доштан мумкин аст, ки хотираро тақрибан ду баробар кам мекунад.
- Таваҷҷуҳи равзанаи лағжанда (Sliding Window Attention). Агар ҳар токен танҳо ба (w) токени охирин нигоҳ кунад, кэшро низ бо ҳамин андоза маҳдуд кардан мумкин аст (нигаред ба бахши таваҷҷуҳи маҳаллӣ дар поён).
- Кэши префиксҳо (Prefix Caching). Агар бисёр дархостҳо бо як промпти системавии умумӣ оғоз шаванд, KV Cache-и ин қисм як маротиба ҳисоб шуда, байни дархостҳо истифода мешавад. Ин ҳам TTFT ва ҳам хароҷотро кам мекунад. Бисёр провайдерҳои API барои чунин токенҳои «кэшшуда» нархи пасттар мегиранд.
Квантонӣ (Quantization)
Квантонӣ (Quantization) — ин нигоҳ доштани вазнҳои модел (ва баъзан фаъолсозиҳо ва KV Cache) бо дақиқии камтар аст. Ба ҷои 16 бит барои ҳар адад 8 ё 4 бит истифода мешавад.
Ғояи асосӣ
Вазнҳои модел ададҳои касрӣ мебошанд, ки асосан дар доираи хурде ҷойгиранд. Квантонӣ ин доираро ба шумораи маҳдуди сатҳҳо тақсим мекунад ва ҳар вазнро ба сатҳи наздиктарин мегардонад.
Содатарин схемаи квантонии симметрӣ чунин аст:
[ s = \frac{\max |w|}{2^{k-1} - 1}, \qquad q = \operatorname{round}\left(\frac{w}{s}\right), \qquad \hat{w} = q \times s ]
Дар ин ҷо (w) — вазни аслӣ, (k) — шумораи битҳо, (s) — коэффитсиенти миқёс (Scale), (q) — адади бутуни нигоҳдошташаванда ва (\hat{w}) — вазни барқароршуда. Фарқи (w - \hat{w}) хатои квантонӣ аст.
Агар як коэффитсиенти миқёс барои тамоми матритса истифода шавад, якчанд вазни хеле калон (Outliers) метавонад дақиқии ҳамаи вазнҳои дигарро вайрон кунад. Аз ин рӯ, дар амал вазнҳо ба гурӯҳҳои хурд (масалан, 32, 64 ё 128 адад) тақсим мешаванд ва ҳар гурӯҳ коэффитсиенти миқёси худро мегирад.
Чаро квантонӣ тавлидро тезтар мекунад?
Квантонӣ на танҳо хотираро сарфа мекунад. Азбаски марҳилаи Decode ба суръати хондани хотира вобаста аст, вазнҳои 4-битӣ тақрибан чор маротиба камтар аз 16-битӣ хонда мешаванд. Аз ин рӯ, дар бисёр ҳолатҳо тавлиди токенҳо низ тезтар мегардад — ба шарте ки барои формати интихобшуда ядроҳои (Kernels) самаранок мавҷуд бошанд.
Намудҳои асосии квантонӣ
- Квантонии пас аз омӯзиш (Post-Training Quantization — PTQ). Модели тайёр бе омӯзиши нав квантонида мешавад, баъзан бо истифода аз маҷмӯи хурди маълумоти танзимкунанда (Calibration Data). Ин роҳи маъмултарин аст.
- Омӯзиш бо назардошти квантонӣ (Quantization-Aware Training — QAT). Модел ҳангоми омӯзиш «одат мекунад», ки бо дақиқии паст кор кунад. Натиҷа беҳтар аст, аммо хароҷоти омӯзиш лозим мешавад.
Усулҳо ва форматҳои маъмул
| Усул ё формат | Ғояи асосӣ | Истифодаи маъмул |
|---|---|---|
| INT8 (масалан, LLM.int8() дар bitsandbytes) | Вазнҳо дар 8 бит; қиматҳои хеле калон алоҳида бо дақиқии баланд коркард мешаванд | Сарфаи ду баробари хотира бо талафоти хеле кам |
| NF4 (bitsandbytes) | Формати 4-битӣ, ки ба тақсимоти вазнҳо мутобиқ аст | QLoRA (нигаред ба боби 7) |
| GPTQ | Вазнҳо қабат ба қабат квантонида мешаванд ва хатои ҳар қадам бо ислоҳи вазнҳои боқимонда ҷуброн карда мешавад | Моделҳои 4-битӣ барои GPU |
| AWQ (Activation-aware Weight Quantization) | Вазнҳое, ки бо фаъолсозиҳои калон зарб мешаванд ва барои натиҷа муҳиманд, бо миқёси махсус ҳифз карда мешаванд | Моделҳои 4-битӣ барои GPU, масалан дар vLLM |
| GGUF | Формати файл барои llama.cpp, ки модел ва метамаълумотро якҷоя нигоҳ медорад ва намудҳои гуногуни квантониро (масалан, Q8_0, Q5_K_M, Q4_K_M) дастгирӣ мекунад | Иҷро дар CPU, Apple Silicon ва GPU-ҳои хонагӣ; Ollama |
| FP8 | Ададҳои касрии 8-битӣ, ки GPU-ҳои нави серверӣ онҳоро бевосита дастгирӣ мекунанд | Хизматрасонии серверӣ бо сифати қариб бетағйир |
Сифат дар муқобили хотира
Квантонӣ бепул нест. Умуман чунин қонуниятҳо мушоҳида мешаванд:
- 8 бит (INT8 ё FP8) дар аксари вазифаҳо қариб ҳеҷ талафоти сифат намедиҳад.
- 4 бит бо усулҳои хуб (GPTQ, AWQ, Q4_K_M) одатан талафоти хурд, вале чен кардашаванда дорад. Барои бисёр барномаҳо ин мувозинати беҳтарин аст.
- 3 бит ва камтар аксар вақт сифатро ба таври назаррас паст мекунад, хусусан дар моделҳои хурд.
- Моделҳои калон ба квантонӣ устувортаранд. Аз ин рӯ, модели калони 4-битӣ аксар вақт аз модели хурди 16-битӣ бо ҳамон ҳаҷми хотира беҳтар кор мекунад.
- Талафот дар вазифаҳои гуногун гуногун аст. Математика, барномасозӣ ва забонҳои камманбаъ (аз ҷумла тоҷикӣ) метавонанд нисбат ба санҷишҳои умумии англисӣ бештар осеб бинанд. Пас моделро пас аз квантонӣ ҳатман дар вазифаҳои худ санҷед (нигаред ба боби 14).
Механизмҳои самараноки таваҷҷуҳ
Мураккабии ҳисоббарории таваҷҷуҳ
Механизми стандартии таваҷҷуҳи пурра (Full Attention) барои пайдарпайии (n) токен матритсаи холҳои андозаи (n \times n) месозад: ҳар токен бо ҳар токени дигар муқоиса мешавад. Аз ин рӯ, мураккабии ҳисоббарорӣ аз рӯи дарозии пайдарпайӣ чунин аст:
[ O(n^2) ]
Дар ин ҷо (O) тартиби афзоиши ҳисобҳоро нишон медиҳад, (n) — шумораи токенҳо ва (n^2) — афзоиши квадратиро.
Агар шумораи токенҳо ду маротиба зиёд шавад, шумораи унсурҳои матритсаи таваҷҷуҳ чор маротиба меафзояд:
| Дарозии пайдарпайӣ (n) | Шумораи унсурҳо (n^2) |
|---|---|
| 256 | 65 536 |
| 512 | 262 144 |
| 1 024 | ~1 миллион |
| 2 048 | ~4,2 миллион |
| 4 096 | ~16,8 миллион |
| 128 000 | ~16 миллиард |
Ин хусусият ҳангоми коркарди матнҳои хеле дароз ба монеаи асосӣ табдил меёбад. Барои ҳалли он ду равиши асосӣ вуҷуд дорад:
- Ҳамон таваҷҷуҳи пурраро зирактар ҳисоб кардан — масалан, FlashAttention. Натиҷа айнан ҳамон аст, танҳо тезтар ва бо хотираи камтар.
- Таваҷҷуҳро тунук кардан (Sparse Attention) — ҳар токен на ба ҳама, балки танҳо ба қисми интихобшудаи токенҳо нигоҳ мекунад. Моделҳои Longformer ва Reformer, ки дар поён баррасӣ мешаванд, намунаҳои ибтидоии ин равиш мебошанд.
FlashAttention
FlashAttention (2022) як роҳи ҳисоб кардани таваҷҷуҳи стандартӣ аст, ки ба вижагиҳои хотираи GPU мутобиқ карда шудааст (IO-aware).
GPU ду навъи асосии хотира дорад:
- HBM (High Bandwidth Memory) — хотираи асосии калон (даҳҳо гигабайт), вале нисбатан суст;
- SRAM — хотираи хеле хурди дохили чип, вале хеле тез.
Дар иҷрои оддӣ матритсаи пурраи (n \times n) ҳисоб шуда, дар HBM навишта мешавад, сипас барои Softmax аз нав хонда мешавад ва ғайра. Барои матнҳои дароз маҳз ҳамин хондану навиштан вақти асосиро мегирад.
FlashAttention матритсаҳои (Q), (K) ва (V)-ро ба бахшҳои хурд (Tiles) тақсим мекунад, ки ба SRAM ҷой мешаванд, ва натиҷаро бахш ба бахш ҳисоб мекунад. Softmax бо усули «онлайн» ҳисоб карда мешавад: ҳадди аксар ва маҷмӯи экспонентҳо ҳангоми гузаштан аз бахшҳо тадриҷан навсозӣ мешаванд. Ҳамин тавр, матритсаи пурраи (n \times n) ҳеҷ гоҳ дар HBM нигоҳ дошта намешавад.
Натиҷаҳои асосӣ:
- Натиҷа дақиқ аст (Exact) — ин тақрибӣ нест; модел ҳамон ҷавобро медиҳад (то хатоҳои хурди ҳисоби ададҳои касрӣ).
- Хотира бо дарозии пайдарпайӣ хаттӣ меафзояд, на квадратӣ.
- Суръат хеле баланд мешавад, хусусан барои контекстҳои дароз.
Бояд дар хотир дошт, ки шумораи амалҳои ҳисоббарорӣ ҳамчунон (O(n^2)) мемонад — FlashAttention танҳо интиқоли маълумотро кам мекунад. Версияҳои минбаъда (FlashAttention-2 ва -3) тақсими корро байни ядроҳои GPU беҳтар карданд ва ба GPU-ҳои нав мутобиқ шуданд. Имрӯз FlashAttention ё усулҳои ба он монанд дар қариб ҳамаи китобхонаҳои омӯзиш ва хизматрасонӣ ба таври пешфарз истифода мешаванд.
Таваҷҷуҳи маҳаллӣ (Local Attention)
Модели Longformer аз механизми таваҷҷуҳи маҳаллӣ (Local Attention) истифода мебарад. Ғояи асосии он сода аст: дар бисёр ҳолатҳо барои фаҳмидани як токен контексти наздики он кофӣ аст. Масалан, барои муайян кардани нақши калима дар ҷумла баъзан донистани ду калимаи чап ва ду калимаи рост басанда аст.
Ба ҷои он ки ҳар токен ба тамоми пайдарпайӣ нигоҳ кунад, он танҳо ба токенҳои дохили равзанаи муайян (Attention Window) таваҷҷуҳ мекунад. Агар андозаи равзана (w) бошад, мураккабӣ ба (O(n \times w)) кам мешавад, яъне бо дарозии матн хаттӣ меафзояд.
Мисол. Ҷумлаи зеринро дар назар гирем:
«Имрӯз донишҷӯён дар донишгоҳ дарси нав меомӯзанд».
Агар равзана ду токен ба ҳар тараф бошад, ҳангоми коркарди калимаи «донишгоҳ» модел танҳо ба калимаҳои наздик нигоҳ мекунад:
Имрӯз  [донишҷӯён  дар  ДОНИШГОҲ  дарси  нав]  меомӯзанд
        └──────── равзанаи таваҷҷуҳ ────────┘
Модел чӣ гуна тамоми ҷумларо мефаҳмад? Агар танҳо як қабат мавҷуд бошад, ҳар токен фақат қисми маҳдуди матнро мебинад. Аммо дар Transformer қабатҳо пай дар пай ҷойгиранд ва ҳар қабат натиҷаи қабати пешинаро истифода мебарад. Токене, ки дар қабати дуюм ба ҳамсояаш нигоҳ мекунад, аллакай маълумоти ҳамсояҳои ӯро низ дар қабати якум гирифтааст. Ҳамин тавр, майдони қабули иттилоот (Receptive Field) аз қабат ба қабат васеъ мешавад — монанди шабакаҳои конволютсионӣ. Бо (L) қабат ва равзанаи (w) майдони қабул тақрибан ба (L \times w) мерасад.
Ҳамин ғоя дар моделҳои муосир бо номи таваҷҷуҳи равзанаи лағжанда (Sliding Window Attention) истифода мешавад. Масалан, Mistral 7B онро дар ҳамаи қабатҳо истифода мебурд, баъзе моделҳои дигар (масалан, оилаи Gemma) қабатҳои маҳаллӣ ва пурраро омехта мекунанд, то ҳам KV Cache хурд шавад ва ҳам робитаҳои дур гум нашаванд.
Таваҷҷуҳи умумӣ (Global Attention)
Дар Longformer, ба ғайр аз таваҷҷуҳи маҳаллӣ, барои баъзе токенҳои пешакӣ интихобшуда таваҷҷуҳи умумӣ (Global Attention) пешбинӣ шудааст. Ин токенҳо ба ҳамаи токенҳои пайдарпайӣ нигоҳ мекунанд.
Ин робита дусамта аст: ҳамаи токенҳои дигар низ, илова бар равзанаи маҳаллии худ, ба токенҳои умумӣ дастрасӣ доранд. Чунин токенҳо одатан аз рӯи вазифа интихоб мешаванд — масалан, токени махсуси [CLS] барои тасниф ё токенҳои савол дар вазифаи ҷавоб ба савол.
Матритсаи таваҷҷуҳи Longformer-ро чунин тасаввур кардан мумкин аст: тасмаи паҳне дар атрофи диагонал (таваҷҷуҳи маҳаллӣ) ва якчанд сатру сутуни пурра (токенҳои умумӣ). Қисми боқимондаи матритса холӣ аст, ки маҳз ҳамин ҳисобу хотираро сарфа мекунад.
Таваҷҷуҳи LSH (LSH Attention)
Модели Reformer аз механизми LSH Attention истифода мебарад. LSH ихтисораи Locality-Sensitive Hashing — «ҳешкунии ҳассос ба наздикӣ» — мебошад.
Дар таваҷҷуҳи стандартӣ ифодаи зерин ҳисоб карда мешавад:
[ \operatorname{softmax}\left(QK^T\right) ]
Дар ин ҷо (Q) — матритсаи дархостҳо (Queries), (K) — матритсаи калидҳо (Keys) ва (K^T) — транспонентаи он. Softmax холҳоро ба вазнҳои таваҷҷуҳ табдил медиҳад.
Пас аз Softmax асосан унсурҳое саҳми назаррас доранд, ки холҳои калонтар доранд. Пас барои ҳар дархости (q) кофист танҳо калидҳои (k)-ро баррасӣ кунем, ки ба (q) наздиканд. Барои зуд ёфтани чунин калидҳо функсияи ҳеш (Hash Function) истифода мешавад: векторҳои ба ҳам наздик бо эҳтимоли баланд ба як «сабад» (Bucket) меафтанд ва таваҷҷуҳ танҳо дар дохили сабадҳо ҳисоб карда мешавад. Ин мураккабиро тақрибан ба (O(n \log n)) кам мекунад.
Ду ҷузъиёти муҳим:
- Тағйири ниқоби таваҷҷуҳ. Дар Reformer дархостҳо ва калидҳо як хел ҳисоб карда мешаванд, бинобар ин дархости ҳар токен ба калиди худаш аз ҳама наздиктар аст. Барои он ки токен таваҷҷуҳи аз ҳад зиёдро ба худаш равона накунад, ниқоби таваҷҷуҳ (Attention Mask) тағйир дода мешавад, то токен ба худ таваҷҷуҳ накунад. Истисно мавқеи аввал аст, ки дигар токене барои таваҷҷуҳ надорад.
- Якчанд даври ҳешкунӣ. Ҳешкунӣ хусусияти тасодуфӣ дорад ва метавонад ду вектори наздикро ба сабадҳои гуногун ҷудо кунад. Аз ин рӯ, якчанд функсияи ҳеш истифода мешавад ва натиҷаҳо миёна карда мешаванд. Шумораи даврҳо дар китобхонаи Transformers бо параметри
n_roundsтанзим мешавад.
Рамзгузории мавқеии меҳварӣ (Axial Positional Encodings)
Reformer инчунин рамзгузории мавқеии меҳварӣ (Axial Positional Encodings)-ро истифода мебарад, ки на ҳисобро, балки хотираро сарфа мекунад.
Дар Transformer-и анъанавӣ бо мавқеъҳои омӯхташаванда рамзгузории мавқеӣ (E) матритсаи андозаи зерин аст:
[ E \in \mathbb{R}^{l \times d} ]
Дар ин ҷо (l) — дарозии ҳадди аксари пайдарпайӣ ва (d) — андозаи ҳолати ниҳонӣ (Hidden State). Барои пайдарпайиҳои хеле дароз ин матритса бисёр калон мешавад.
Axial Positional Encodings матритсаи (E)-ро ба ду матритсаи хурдтар омилбандӣ мекунад:
[ E_1 \in \mathbb{R}^{l_1 \times d_1}, \qquad E_2 \in \mathbb{R}^{l_2 \times d_2} ]
бо шартҳои
[ l_1 \times l_2 = l, \qquad d_1 + d_2 = d. ]
Вектори мавқеи (j) аз пайваст кардани (Concatenation) ду вектор сохта мешавад:
[ E[j] = \operatorname{concat}\left( E_1[j \bmod l_1],\ E_2[\lfloor j / l_1 \rfloor] \right) ]
Дар ин ҷо (j \bmod l_1) бақияи тақсим (дар Python j % l1) ва (\lfloor j / l_1 \rfloor) қисми бутуни тақсим (дар Python j // l1) аст.
Мисол. Агар (l = 65,536) ва (d = 1024) бошад, матритсаи пурра тақрибан 67 миллион параметр дорад. Бо (l_1 = l_2 = 256) ва (d_1 = d_2 = 512) ду матритса ҳамагӣ (2 \times 256 \times 512 \approx 262) ҳазор параметр доранд — қариб 256 маротиба камтар.
Имрӯз аксари моделҳо ба ҷои мавқеъҳои омӯхташаванда аз рамзгузории мавқеии даврзананда (RoPE) истифода мебаранд, ки умуман параметр надорад (нигаред ба бахши контексти дароз).
Муқоисаи механизмҳо
| Механизм | Мураккабӣ | Дақиқ ё тақрибӣ | Истифода |
|---|---|---|---|
| Таваҷҷуҳи пурра | (O(n^2)) ҳисоб ва хотира | Дақиқ | Transformer-и аслӣ |
| FlashAttention | (O(n^2)) ҳисоб, (O(n)) хотира | Дақиқ | Қариб ҳамаи моделҳои муосир |
| Таваҷҷуҳи маҳаллӣ / равзанаи лағжанда | (O(n \times w)) | Тунук | Longformer, Mistral, моделҳои омехта |
| Таваҷҷуҳи маҳаллӣ + умумӣ | (O(n \times w)) | Тунук | Longformer, BigBird |
| LSH Attention | (O(n \log n)) | Тақрибӣ | Reformer |
Омехтаи коршиносон (Mixture of Experts — MoE)
Дар модели одии «зич» (Dense) ҳар токен аз ҳамаи параметрҳои модел мегузарад. Агар модел 70 миллиард параметр дошта бошад, барои ҳар токен ҳамаи 70 миллиард истифода мешаванд.
Омехтаи коршиносон (Mixture of Experts — MoE) роҳи дигарро пешниҳод мекунад: модел параметрҳои зиёд дорад, аммо барои ҳар токен танҳо қисми хурди онҳо фаъол мешавад.
MoE чӣ гуна кор мекунад?
Дар MoE қабати шабакаи пешравии (Feed-Forward Network — FFN) ҳар блоки Transformer бо якчанд FFN-и мустақил — коршиносон (Experts) — иваз карда мешавад. Илова бар ин, шабакаи хурди масиргузор (Router ё Gate) вуҷуд дорад.
Барои ҳар токен:
- Масиргузор ба ҳар коршинос хол медиҳад.
- Танҳо (k) коршиноси беҳтарин (Top-k, масалан 2 аз 8) интихоб мешаванд.
- Токен аз ҳамин коршиносон мегузарад ва натиҷаҳои онҳо бо вазнҳои масиргузор якҷоя карда мешаванд.
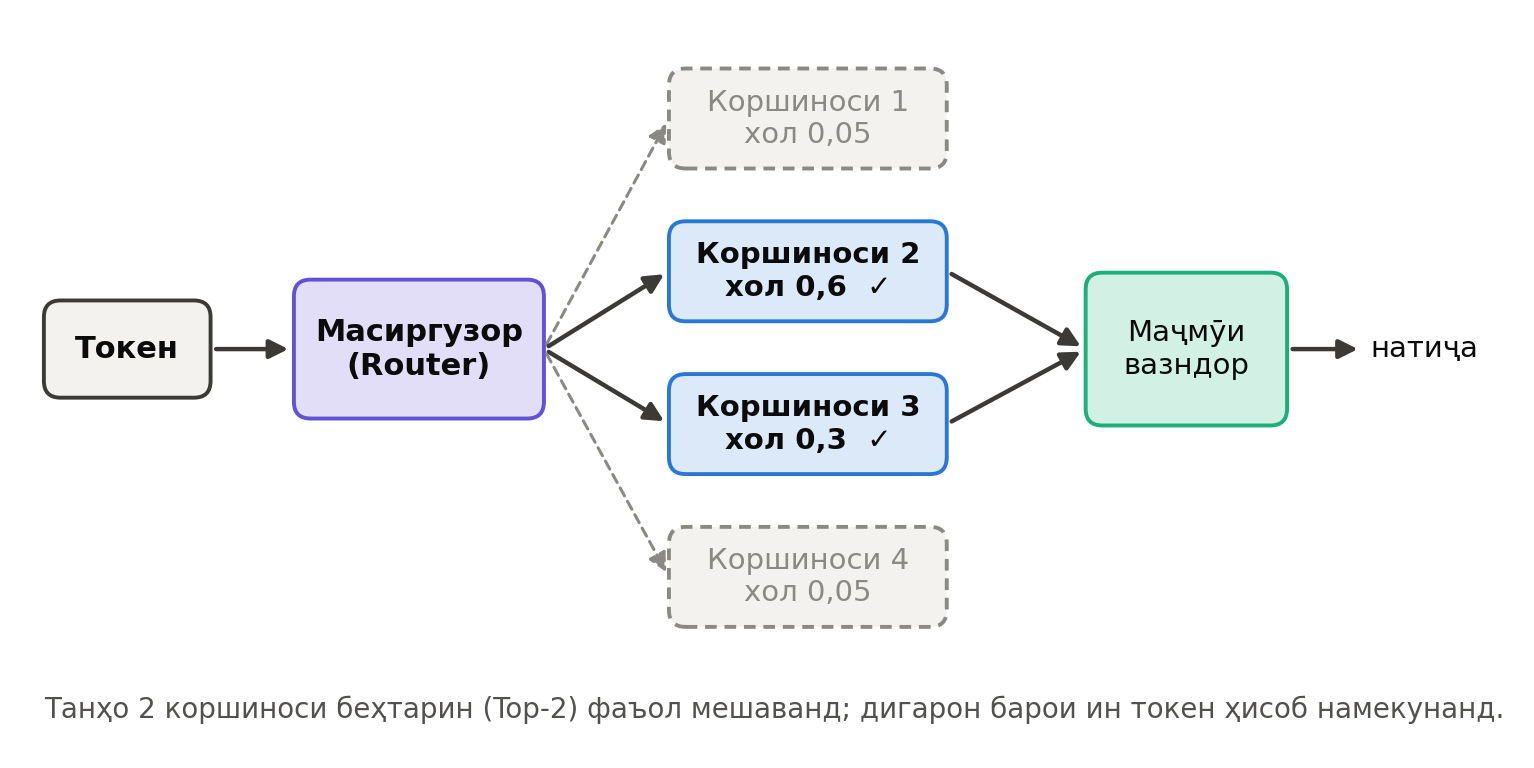
Расми 13.4. Қабати MoE: масиргузор ба ҳар коршинос хол медиҳад, танҳо ду коршиноси беҳтарин (Top-2) фаъол мешаванд ва натиҷаҳои онҳо бо вазнҳои масиргузор якҷоя карда мешаванд.
Қабатҳои таваҷҷуҳ одатан барои ҳамаи токенҳо умумӣ мемонанд.
Параметрҳои умумӣ ва фаъол
Дар бораи модели MoE ду адад гуфта мешавад:
- Параметрҳои умумӣ (Total Parameters) — ҳамаи вазнҳои модел. Онҳо муайян мекунанд, ки модел чӣ қадар хотира мегирад.
- Параметрҳои фаъол (Active Parameters) — вазнҳое, ки барои як токен истифода мешаванд. Онҳо муайян мекунанд, ки ҳар токен чӣ қадар ҳисоб талаб мекунад.
Масалан, Mixtral 8x7B тақрибан 47 миллиард параметри умумӣ ва тақрибан 13 миллиард параметри фаъол дорад. DeepSeek-V3 тақрибан 671 миллиард параметри умумӣ дорад, аммо барои ҳар токен тақрибан 37 миллиард фаъол мешавад.
Бартариҳо ва душвориҳо
Бартариҳо:
- Бо ҳамон ҳаҷми ҳисоб модел дониш ва қобилияти бештар дошта метавонад.
- Омӯзиш ва тавлид нисбат ба модели зичи ҳамон андоза хеле арзонтар аст.
Душвориҳо:
- Хотира. Ҳамаи коршиносон бояд дар хотира бошанд, гарчанде ки ҳар лаҳза танҳо қисме аз онҳо кор мекунад. Модели MoE-и калон бисёр GPU талаб мекунад.
- Мувозинати сарборӣ. Агар масиргузор ҳамеша ҳамон чанд коршиносро интихоб кунад, дигарон беистифода мемонанд. Барои ин ҳангоми омӯзиш функсияҳои иловагии талафот ё усулҳои дигари мувозинат истифода мешаванд.
- Мураккабии хизматрасонӣ. Коршиносон метавонанд дар GPU-ҳои гуногун ҷойгир бошанд (Expert Parallelism) ва токенҳо бояд байни онҳо интиқол дода шаванд.
Бояд таъкид кард, ки «коршиносон» одатан на дар мавзӯъҳои ба одам фаҳмо (масалан, «коршиноси таърих» ё «коршиноси математика»), балки дар қолабҳои сатҳи пасттари токенҳо ихтисос пайдо мекунанд.
Имрӯз бисёр моделҳои калонтарини кушода (масалан, DeepSeek-V3, Qwen3-и калон, Llama 4) меъмории MoE доранд.
Контексти дароз
Равзанаи контекстии моделҳо дар чанд соли охир аз 2–4 ҳазор токен то садҳо ҳазор ва ҳатто як миллион токен расид. Масалан, модели кушодаи Qwen2.5-1M равзанаи то як миллион токенро пешниҳод мекунад.
Контексти дароз чӣ арзиш дорад?
Контексти дароз ба модел имкон медиҳад, ки ҳуҷҷатҳои калон, тамоми лоиҳаи барномавӣ ё таърихи дарози суҳбатро якбора бубинад. Аммо он бо хароҷот алоқаманд аст:
- Ҳисоб. Марҳилаи Prefill бо таваҷҷуҳи пурра ба таври квадратӣ меафзояд; TTFT барои промпти хеле дароз метавонад даҳҳо сония шавад.
- Хотира. KV Cache бо дарозии контекст хаттӣ меафзояд ва барои садҳо ҳазор токен даҳҳо гигабайт мегирад.
- Суръати Decode. Ҳар токени нав бояд ба тамоми кэш нигоҳ кунад, бинобар ин TPOT низ бо дарозии контекст суст мешавад.
- Сифат. Модел на ҳамеша маълумотро аз ҳамаи қисмҳои контекст якхела хуб истифода мебарад. Таҳқиқот нишон доданд, ки баъзе моделҳо маълумоти оғоз ва охири контекстро беҳтар аз маълумоти мобайн истифода мекунанд (падидаи «гум шудан дар мобайн» — Lost in the Middle).
Аз ин рӯ, на ҳамеша беҳтар аст, ки ҳама чизро ба контекст гузорем. Барои бисёр вазифаҳо RAG (боби 11) — интихоби танҳо порчаҳои мувофиқ — ҳам арзонтар ва ҳам дақиқтар аст. Масъалаи асосӣ ёфтани мувозинати дуруст барои ҳолати мушаххаси шумост.
Рамзгузории мавқеии даврзананда (RoPE)
Аксари моделҳои муосир мавқеи токенҳоро бо рамзгузории мавқеии даврзананда (Rotary Position Embedding — RoPE) ифода мекунанд. Ғояи он чунин аст: векторҳои дархост ва калид ба ҷуфтҳои координатаҳо тақсим мешаванд ва ҳар ҷуфт ба кунҷе давр зада мешавад, ки ба мавқеи токен мутаносиб аст. Ҷуфтҳои гуногун бо басомадҳои гуногун давр мезананд — баъзеҳо тез, баъзеҳо суст.
Хусусияти муҳими RoPE дар он аст, ки ҳосили зарби скалярии (q) ва (k) танҳо ба фарқи мавқеъҳои онҳо вобаста мешавад. Яъне модел мавқеи нисбии токенҳоро «эҳсос» мекунад ва барои ин ягон параметри иловагӣ лозим нест.
Васеъ кардани контекст
Агар модел бо контексти 8 ҳазор токен омӯзонида шуда бошад, вай кунҷҳои даврзании мавқеъҳои дуртарро ҳеҷ гоҳ надидааст ва дар онҳо бад кор мекунад. Барои васеъ кардани контекст бе омӯзиши пурра аз нав чанд усул пайдо шудааст:
- Интерполятсияи мавқеъҳо (Position Interpolation) — мавқеъҳо «фишурда» мешаванд, то контексти нав ба доираи кунҷҳои шинос ҷой шавад.
- Тағйири асоси басомадҳо (масалан, NTK-aware Scaling) ва усули YaRN — басомадҳои гуногун ба таври гуногун миқёс дода мешаванд, то ҳам тафсилоти наздик ва ҳам мавқеъҳои дур нигоҳ дошта шаванд.
Пас аз чунин тағйир модел одатан дар маҷмӯи хурди матнҳои дароз каме омӯзиши иловагӣ мегирад. Илова бар ин, барои кор бо контексти хеле дароз FlashAttention, таваҷҷуҳи равзанаи лағжанда, GQA ва квантонии KV Cache, ки дар боло баррасӣ шуданд, якҷоя истифода мешаванд.
Декодкунии пешгӯёна (Speculative Decoding)
Чунон ки дидем, марҳилаи Decode ба хотира вобаста аст: GPU барои тавлиди ҳар токен тамоми вазнҳоро мехонад, аммо қисми зиёди қувваи ҳисоббарориаш бекор мемонад. Декодкунии пешгӯёна аз ҳамин қувваи бекор истифода мебарад.
Ғояи асосӣ
- Модели хурди пешнавискунанда (Draft Model) зуд якчанд токени навбатиро (масалан, 4–5 токен) пешниҳод мекунад.
- Модели асосии калон (Target Model) ҳамаи ин токенҳоро дар як гузариш, ба таври мувозӣ, месанҷад — монанди марҳилаи Prefill.
- Токенҳое, ки модели асосӣ бо онҳо розӣ аст, қабул карда мешаванд. Дар аввалин токени нодуруст модели асосӣ токени худро мегузорад ва раванд аз ҳамон ҷо идома меёбад.
Пешнавискунанда:  «пойтахти»  «Тоҷикистон»  «шаҳри»  «Хуҷанд»
Модели асосӣ:         ✓             ✓           ✓        ✗ → «Душанбе»
Натиҷа: 4 токен дар як гузариши модели калон
Агар пешнавискунанда аксар вақт дуруст тахмин кунад, модели калон дар як гузариш на як, балки якчанд токен тавлид мекунад.
Чаро сифат паст намешавад?
Бо қоидаи махсуси қабул ё рад кардани токенҳо (Rejection Sampling) кафолат дода мешавад, ки тақсимоти токенҳои ниҳоӣ айнан ба тақсимоти модели асосӣ мувофиқ аст. Яъне декодкунии пешгӯёна сифати ҷавобро тағйир намедиҳад — танҳо суръатро.
Вариантҳо
- Модели хурди ҳамон оила ҳамчун пешнавискунанда (масалан, модели 1B барои модели 70B, ки ҳамон токенсозиро дорад).
- Сарҳои иловагӣ дар худи модели асосӣ, ки якчанд токени ояндаро пешгӯӣ мекунанд (масалан, Medusa ва EAGLE).
- Ҷустуҷӯ дар худи промпт (Prompt Lookup) — барои вазифаҳое, ки ҷавоб қисмҳои промптро такрор мекунад (масалан, таҳрири код), пешниҳодҳо аз худи матни вурудӣ гирифта мешаванд.
Самаранокии усул ба вазифа вобаста аст: дар матнҳои пешгӯишаванда (код, ҷавобҳои қолабӣ) тезшавӣ назаррас аст, дар матнҳои эҷодӣ камтар. Ҳангоми сарбории хеле баланди сервер, ки GPU аллакай пурра банд аст, фоидаи он кам мешавад.
Хизматрасонӣ ва бастабандии дархостҳо
Вақте ки модел на ба як корбар, балки ба садҳо корбари ҳамзамон хизмат мекунад, масъалаи асосӣ ин аст, ки GPU-ро чӣ гуна ҳарчи бештар банд нигоҳ дорем.
Бастабандии дархостҳо (Batching)
Азбаски Decode ба хотира вобаста аст, хондани вазнҳо барои як дархост ва барои 32 дархост қариб ҳамон қадар вақт мегирад. Пас агар дархостҳои зиёдро якҷоя — дар як баста (Batch) — коркард кунем, Throughput қариб мутаносибан меафзояд, то даме ки GPU ба ҳадди ҳисоббарорӣ ё хотира нарасад.
Бастабандии статикӣ (Static Batching) — роҳи содатарин: якчанд дархост ҷамъ карда, якҷоя то охир коркард мешаванд. Мушкил ин аст, ки ҷавобҳо дарозии гуногун доранд. Агар як ҷавоб 20 токен ва дигараш 2000 токен бошад, ҷои дархости кӯтоҳ то анҷоми дарозтарин холӣ мемонад ва дархостҳои нав интизор мешаванд.
Бастабандии пайваста (Continuous Batching)
Дар бастабандии пайваста (Continuous Batching ё In-flight Batching) таркиби баста дар ҳар қадами Decode нав карда мешавад:
- дархосте, ки ҷавобаш тамом шуд, фавран аз баста хориҷ мешавад;
- дархости нав дар қадами навбатӣ ба ҷои холӣ дохил мешавад.
Ҳамин тавр, GPU ҳамеша банд аст ва Throughput нисбат ба бастабандии статикӣ хеле меафзояд. Системаҳои муосир инчунин марҳилаи Prefill-и дархостҳои навро ба қисмҳо тақсим карда (Chunked Prefill), бо қадамҳои Decode-и дархостҳои дигар омехта мекунанд, то промпти дароз корбарони дигарро боз надорад.
PagedAttention
Бастабандии пайваста бо KV Cache мушкили нав пеш меорад. Ҳангоми оғози дархост маълум нест, ки ҷавоб чӣ қадар дароз мешавад. Агар барои ҳар дархост пешакӣ хотираи пайваста барои ҳадди аксари дарозӣ ҷудо кунем, қисми зиёди он беистифода мемонад (пароканда шудани хотира — Fragmentation).
PagedAttention, ки дар лоиҳаи vLLM (2023) пешниҳод шуд, ин мушкилро бо ғояи хотираи маҷозии (Virtual Memory) системаҳои амалиётӣ ҳал мекунад:
- KV Cache ба блокҳои хурди андозаи доимӣ (масалан, 16 токен) тақсим мешавад;
- блокҳо дар хотира метавонанд дар ҳар ҷое ҷойгир бошанд, на ҳатман пайваста;
- барои ҳар дархост ҷадвали блокҳо нигоҳ дошта мешавад, ки мавқеъҳои мантиқиро ба блокҳои воқеӣ мепайвандад;
- блокҳои нав танҳо ҳангоми зарурат ҷудо мешаванд.
Натиҷа: талафи хотира хеле кам мешавад, дар ҳамон GPU дархостҳои бештар ҷой мегиранд ва Throughput меафзояд. Илова бар ин, блокҳоро байни дархостҳо тақсим кардан мумкин аст — масалан, барои промпти системавии умумӣ (Prefix Caching) ё барои якчанд варианти ҷавоб ба ҳамон промпт.
Абзорҳои хизматрасонӣ
| Абзор | Барои чӣ | Хусусиятҳо |
|---|---|---|
| vLLM | Хизматрасонӣ дар GPU-ҳои серверӣ | PagedAttention, бастабандии пайваста, кэши префиксҳо, квантонӣ, API-и мувофиқ ба OpenAI |
| SGLang | Хизматрасонӣ дар GPU-ҳои серверӣ | Самаранокии баланд, истифодаи такрории кэш байни дархостҳо, барномаҳои мураккаби LLM |
| TGI (Text Generation Inference) | Хизматрасонӣ аз ҷониби Hugging Face | Ҳамгироӣ бо экосистемаи Hugging Face |
| TensorRT-LLM | GPU-ҳои NVIDIA | Оптимизатсияи амиқ барои таҷҳизоти NVIDIA |
| llama.cpp | CPU, Apple Silicon, GPU-ҳои хонагӣ | Формати GGUF, квантонии гуногун, вобастагиҳои кам |
| Ollama | Иҷрои маҳаллӣ бо як фармон | Дар асоси llama.cpp; боргирӣ ва идораи осони моделҳо |
Мисоли оғози сервери vLLM, ки API-и мувофиқ ба OpenAI пешниҳод мекунад:
pip install vllm
vllm serve Qwen/Qwen2.5-7B-Instruct --max-model-len 8192
Пас аз ин ба сервер бо ҳамон китобхонаи openai муроҷиат кардан мумкин аст:
from openai import OpenAI

client = OpenAI(base_url="http://localhost:8000/v1", api_key="холӣ")

response = client.chat.completions.create(
    model="Qwen/Qwen2.5-7B-Instruct",
    messages=[{"role": "user", "content": "Душанбе дар куҷо ҷойгир аст?"}],
    temperature=0.3,
)
print(response.choices[0].message.content)
Барои озмоиши маҳаллӣ дар компютери шахсӣ Ollama аз ҳама осонтар аст:
ollama run qwen2.5:7b
Ollama низ API-и маҳаллиро (бо нуқтаи мувофиқ ба OpenAI) пешниҳод мекунад, бинобар ин ҳамон коди Python-ро бо тағйири base_url истифода бурдан мумкин аст.
Интихоби роҳи ҷорӣ кардан
Ду роҳи асосӣ вуҷуд дорад: истифодаи API-и тайёри провайдер ё ҷойгир кардани модели кушода дар сервери худ (Self-hosting).
API-и тайёр
Провайдер модел ва серверҳоро идора мекунад; шумо барои токенҳо пардохт мекунед. Нарх одатан барои токенҳои вурудӣ ва баромадӣ алоҳида муқаррар мешавад ва токенҳои баромадӣ гаронтаранд. Токенҳои кэшшуда (Prefix Caching) аксар вақт арзонтар ҳисоб мешаванд.
Бартариҳо:
- оғози фаврӣ, бе харидани таҷҳизот ва бе мутахассисони инфраструктура;
- дастрасӣ ба моделҳои пурқувваттарин, ки вазнҳояшон кушода нестанд;
- пардохт танҳо барои истифодаи воқеӣ — барои сарбории кам ё тағйирёбанда беҳтарин аст.
Камбудиҳо:
- маълумот ба сервери берунӣ фиристода мешавад — барои бонкҳо, тиб ва идораҳои давлатӣ ин метавонад бо қонунгузорӣ ё сиёсати дохилӣ мувофиқ набошад;
- вобастагӣ аз провайдер, нархҳо ва тағйири моделҳои ӯ;
- ҳангоми ҳаҷми хеле калон хароҷот метавонад зиёд шавад.
Ҷойгир кардан дар сервери худ
Бартариҳо:
- маълумот дар дохили ташкилот мемонад;
- назорати пурра бар модел, версия ва танзимот; имкони танзими дақиқ (боби 7);
- ҳангоми сарбории баланд ва доимӣ нархи ҳар токен метавонад пасттар бошад.
Камбудиҳо:
- хароҷоти таҷҳизот ё иҷораи GPU, ки ҳатто ҳангоми бекорӣ пардохт мешавад;
- зарурати мутахассисон барои танзим, мониторинг ва навсозӣ;
- моделҳои кушодаи ба таҷҳизоти шумо ҷойшаванда метавонанд аз моделҳои пешрафтаи API сусттар бошанд.
Ҳисоби тақрибии хароҷот
Нархи як миллион токен ҳангоми ҷойгир кардан дар сервери худ тақрибан чунин аст:
[ C_{\text{1M}} = \frac{P_{\text{соат}}}{T \times 3600} \times 10^6 ]
Дар ин ҷо (P_{\text{соат}}) — нархи як соати GPU ва (T) — Throughput-и воқеӣ (токен дар як сония), яъне бо назардошти он, ки сервер на ҳамеша пурра банд аст.
Хулосаи муҳим: худи нархи GPU не, балки дараҷаи истифода (Utilization) ҳалкунанда аст. GPU-е, ки шабонарӯз 10 фоиз банд аст, ҳар токенро даҳ маротиба гаронтар мекунад. Аз ин рӯ, тавсияи умумӣ чунин аст:
- барои прототип ва сарбории кам ё номуайян — API;
- барои маълумоти махфӣ, ки набояд аз ташкилот берун равад, — модели кушода дар сервери худ ё дар абри хусусӣ;
- барои сарбории калон ва устувор — ҳисоби муқоисавӣ дар асоси Throughput-и воқеӣ, ки дар вазифаҳои худ чен карда шудааст.
Рӯйхати санҷиш пеш аз ҷорӣ кардан
- Талаботро муайян кунед: TTFT ва TPOT-и қобили қабул, шумораи корбарони ҳамзамон, дарозии маъмулии промпт ва ҷавоб.
- Хурдтарин моделеро интихоб кунед, ки дар маҷмӯи санҷишии шумо сифати кофӣ медиҳад (боби 14).
- Квантониро санҷед: аввал 8 бит, сипас 4 бит — ва сифатро дар ҳамон маҷмӯи санҷишӣ чен кунед.
- Хотираро ҳисоб кунед: вазнҳо + KV Cache барои контексти зарурӣ ва шумораи корбарон.
- Абзори хизматрасонӣ бо бастабандии пайваста ва PagedAttention интихоб кунед.
- Санҷиши сарборӣ (Load Testing) гузаронед ва TTFT, TPOT ва Throughput-ро дар сарбории воқеӣ чен кунед.
- Мониторинг ва маҳдудиятҳоро (дарозии ҳадди аксари контекст, шумораи дархостҳо аз як корбар) танзим кунед.
Хулоса
Дар ин боб мо дидем, ки ҷорӣ кардани модели забонӣ на камтар аз омӯзиши он масъалаи муҳандисӣ аст.
Нуктаҳои асосӣ:
- Самаранокӣ бо чор нишондиҳанда чен карда мешавад: TTFT (асосан Prefill), TPOT (асосан Decode), Throughput ва истифодаи VRAM.
- Prefill ба ҳисоббарорӣ вобаста аст, Decode ба суръати хотира. Аксари оптимизатсияҳо аз ҳамин фарқ сарчашма мегиранд.
- Хотираи зарурӣ ≈ параметрҳо × байт барои параметр + KV Cache + 10–20 фоизи иловагӣ.
- KV Cache ҳисобҳои такрориро аз байн мебарад, аммо бо дарозии контекст ва шумораи корбарон меафзояд; GQA, MLA, квантонии кэш ва кэши префиксҳо онро кам мекунанд.
- Квантонӣ то 8 бит қариб бе талафот ва то 4 бит бо талафоти хурд хотираро чандин маротиба кам мекунад ва Decode-ро тезтар месозад; сифатро ҳамеша дар вазифаҳои худ санҷед.
- FlashAttention таваҷҷуҳи дақиқро бо хотираи хаттӣ ҳисоб мекунад; таваҷҷуҳи маҳаллӣ, умумӣ ва LSH бо тунук кардани матритсаи таваҷҷуҳ ҳисобро кам мекунанд; Axial Positional Encodings хотираи рамзгузории мавқеиро сарфа мекунад.
- MoE параметрҳои умумии зиёд, вале параметрҳои фаъоли кам дорад: ҳисоб арзон, хотира гарон.
- Контексти дароз бо RoPE ва усулҳои васеъкунии он дастрас мешавад, аммо гарон аст ва на ҳамеша аз RAG беҳтар аст.
- Декодкунии пешгӯёна бо модели хурди пешнавискунанда тавлидро бе тағйири сифат тезтар мекунад.
- Бастабандии пайваста ва PagedAttention (vLLM) асоси хизматрасонии самараноки муосир мебошанд.
- Интихоби байни API ва сервери худ ба махфияти маълумот, ҳаҷм ва дараҷаи истифодаи GPU вобаста аст.
Соҳаи самаранокии LLM хеле босуръат рушд мекунад ва усулҳои нав мунтазам пайдо мешаванд. Аммо принсипҳои асосии ин боб — ҳисоби хотира, фарқи Prefill ва Decode ва мувозинати сифат, суръат ва хароҷот — барои баҳо додан ба ҳар усули нав асос хоҳанд буд.
Саволҳо барои санҷиши худ
- Фарқи TTFT ва TPOT дар чист? Ба ҳар кадоми онҳо кадом марҳилаи тавлид бештар таъсир мерасонад?
- Чаро марҳилаи Decode ба суръати хотира вобаста аст, на ба қувваи ҳисоббарории GPU?
- Модели 13 миллиард параметрӣ дар форматҳои BF16 ва INT4 тақрибан чӣ қадар хотира мегирад?
- KV Cache чиро нигоҳ медорад ва чаро ҳаҷми он бо шумораи корбарони ҳамзамон меафзояд? GQA онро чӣ гуна кам мекунад?
- Чаро модели калони 4-битӣ аксар вақт аз модели хурди 16-битӣ бо ҳамон ҳаҷми хотира беҳтар аст? Пас аз квантонӣ чиро бояд ҳатман санҷид?
- FlashAttention натиҷаи дақиқ медиҳад ё тақрибӣ? Он маҳз чиро кам мекунад?
- Таваҷҷуҳи маҳаллӣ чӣ гуна ба модел имкон медиҳад, ки бо вуҷуди равзанаи хурд тамоми матнро фаҳмад?
- Фарқи параметрҳои умумӣ ва фаъол дар модели MoE дар чист ва ҳар кадом ба чӣ таъсир мерасонад?
- Чаро декодкунии пешгӯёна сифати ҷавобро паст намекунад?
- Бастабандии пайваста аз бастабандии статикӣ чӣ бартарӣ дорад? PagedAttention кадом мушкилро ҳал мекунад?
- Бонки тоҷике мехоҳад чатботи дохилӣ барои 200 корманд созад, ки бо ҳуҷҷатҳои махфӣ кор мекунад. Шумо API-ро тавсия медиҳед ё сервери худро? Чаро?
Манбаъҳо
Ин боб қисман дар асоси манбаъҳои зерин таҳия шудааст:
- Курси LLM-и Hugging Face (Hugging Face LLM Course). https://huggingface.co/learn/llm-course — механизмҳои самараноки таваҷҷуҳ (LSH, таваҷҷуҳи маҳаллӣ, рамзгузории мавқеии меҳварӣ).
 Барномасозӣ
 Олами Афсонаҳо
 Ахбор
 Саломатӣ
 Дунё