Омӯзиши моделҳои бузурги забонӣ (LLM)
Китоби омӯзишӣ дар бораи моделҳои бузурги забонӣ (LLM) ба забони тоҷикӣ: аз мафҳумҳои аввалия то усулҳои муосир. Токенсозӣ ва векторҳо, шабакаҳои нейронӣ, механизми таваҷҷуҳ ва Transformer, оилаҳои моделҳо, омӯзиши пешакӣ, танзими дақиқ ва LoRA, мутобиқсозӣ (RLHF, DPO), тавлиди матн, муҳандисии промпт, RAG, агентҳо, самаранокӣ, арзёбӣ ва бехатарӣ, тафсирпазирӣ ва истифодаи LLM барои забони тоҷикӣ. Бо мисолҳои код дар Python ва PyTorch, замимаҳои математика ва луғати истилоҳот.
Агенти Зеҳнӣ · 13 октябри 2026 · 18 саҳифа · 2 писанд
Боби 16. Моделҳои бузурги забонӣ барои забони тоҷикӣ
Дар бобҳои гузашта мо дидем, ки моделҳои бузурги забонӣ чӣ гуна сохта, омӯзонида, танзим ва арзёбӣ мешаванд. Қариб ҳамаи мисолҳои маъмул дар ин соҳа ба забони англисӣ тааллуқ доранд, зеро бештари маълумоти омӯзишӣ, санҷишҳо ва абзорҳо барои ҳамин забон сохта шудаанд.
Дар ин боб ҳамаи он чиро, ки омӯхтем, ба забони тоҷикӣ татбиқ мекунем. Мебинем, ки чаро модел бо матни тоҷикӣ бадтар ва гаронтар кор мекунад, барои беҳтар кардани он чӣ кор кардан мумкин аст ва натиҷаро чӣ гуна бояд санҷид.
Дар ин боб меомӯзем
- Чаро забони тоҷикӣ барои моделҳо забони «камманбаъ» ба ҳисоб меравад ва ин чӣ оқибатҳо дорад.
- Токенсозҳо матни тоҷикиро чӣ гуна тақсим мекунанд ва ин барои нарх ва дарозии контекст чӣ маъно дорад.
- Кадом моделҳо бо забони тоҷикӣ кор карда метавонанд ва онҳоро чӣ гуна дар вазифаи худ санҷидан мумкин аст.
- Маҷмӯаи додаҳои тоҷикӣ чӣ гуна ҷамъ ва тоза карда мешавад: OCR, ҳарфҳои махсус, омехтагӣ бо русӣ ва лотинӣ.
- Моделро ба забони тоҷикӣ чӣ гуна мутобиқ мекунанд: аз промпт то омӯзиши пешакии давомдор бо LoRA.
- Ҷавобҳои тоҷикии модел чӣ гуна арзёбӣ мешаванд.
- Нутқи тоҷикиро бо Whisper чӣ гуна ба матн табдил медиҳанд ва сифати онро чӣ гуна чен мекунанд.
Забони тоҷикӣ барои модел: забони камманбаъ
Забонеро камманбаъ (Low-resource Language) меноманд, ки барои он матнҳои рақамӣ, маҷмӯаҳои тамғагузоришуда, санҷишҳо ва абзорҳо кам мавҷуданд. Ин ба шумораи гӯяндагони забон вобаста нест: бо забони тоҷикӣ миллионҳо нафар ҳарф мезананд, вале ҳиссаи матни тоҷикӣ дар интернет ва дар маҷмӯаҳои омӯзишии моделҳо хеле ночиз аст.
Аз ин ҷо се мушкили асосӣ пайдо мешавад:
- Модел забонро сусттар медонад. Модел дар вақти омӯзиши пешакӣ матни тоҷикиро нисбат ба англисӣ ё русӣ ҳазорҳо маротиба камтар дидааст. Аз ин рӯ, ҷавобҳои тоҷикӣ аксар вақт хатоҳои грамматикӣ, ибораҳои сунъӣ ва калимаҳои русӣ доранд.
- Модел дар бораи Тоҷикистон камтар медонад. Таърих, адабиёт, ҷуғрофия, қонунҳо ва шахсиятҳои тоҷик дар маълумоти омӯзишӣ кам инъикос ёфтаанд. Хатари галлюсинатсия (ниг. боби 14) дар ин мавзӯъҳо баландтар аст.
- Абзорҳо ва санҷишҳо кам ҳастанд. Барои англисӣ садҳо маҷмӯаи санҷишӣ мавҷуданд, вале барои тоҷикӣ шумораи онҳо хеле кам аст (ниг. боби 14). Бисёр вақт маҷмӯаи санҷиширо худатон бояд созед.
Хусусиятҳои забон, ки ба кори модел таъсир мерасонанд
Пеш аз он ки ба масъалаҳои техникӣ гузарем, якчанд хусусияти забони тоҷикиро ба ёд меорем, ки дар ин боб борҳо ба онҳо дучор мешавем.
Алифбо. Забони тоҷикӣ аз соли 1940 бо алифбои кириллӣ навишта мешавад. Дар алифбо шаш ҳарфе ҳаст, ки дар алифбои русӣ нестанд: ғ, ӣ, қ, ӯ, ҳ, ҷ. Ҳамин шаш ҳарф сарчашмаи бисёр мушкилот дар додаҳо мебошанд (ниг. қисми «Сохтани маҷмӯаи додаҳо»).
Эзоҳ: Ҳарфи «й» низ дар алифбои тоҷикӣ ҳаст ва бо «ӣ» якхела нест: «пайдо», «қайд», «ҷой», «рӯй» бо «й» навишта мешаванд, «иҷтимоӣ», «ҳарбӣ», «тоҷикӣ» — бо «ӣ». Барои ҳамин «й»-ро ба таври кӯр-кӯрона ба «ӣ» иваз кардан мумкин нест, ҳарчанд дар матнҳои сканшуда ин ду ҳарф зуд-зуд омехта мешаванд.
Хати дигар — забони наздик. Забони форсии Эрон ва дарии Афғонистон бо тоҷикӣ хеле наздиканд, вале бо хатти арабӣ-форсӣ навишта мешаванд. Ин наздикӣ ҳам фоида дорад ва ҳам зарар. Фоидааш дар он аст, ки модел дониши аз матнҳои форсӣ гирифтаашро қисман барои тоҷикӣ истифода мебарад (ниг. боби 15). Зарараш дар он аст, ки модел баъзан ба ҷои тоҷикӣ бо хатти форсӣ менависад ё калимаҳо ва ибораҳои хоси форсии Эронро истифода мебарад.
Морфологияи бой. Ба реша пасвандҳо ва бандакҳо пай дар пай ҳамроҳ мешаванд: «китоб» → «китобҳо» → «китобҳоям» → «китобҳоямон». Изофат («китоби нав»), пасоянди «-ро» ва бандакҳои феълӣ шумораи шаклҳои калимаро боз ҳам зиёд мекунанд (ниг. боби 2).
Омехтагӣ бо русӣ ва лотинӣ. Дар забони гуфтугӯӣ ва дар интернет калимаҳо ва ҷумлаҳои русӣ зиёд вомехӯранд. Корбарон аксар вақт ҳарфҳои махсусро бо ҳарфҳои русӣ иваз мекунанд («хисоб» ба ҷои «ҳисоб») ё тоҷикиро бо ҳарфҳои лотинӣ менависанд («hisobi man»).
Токенсозӣ: матни тоҷикӣ чанд токен аст?
Дар боби 2 дидем, ки токенсози зерикалимавӣ калимаҳои забони каммаълумотро ба пораҳои зиёд тақсим мекунад. Акнун инро бо рақамҳо месанҷем.
Як матни кӯтоҳро (тақрибан 30 калима) ба се забон — тоҷикӣ, русӣ ва англисӣ — бо як маъно навиштем ва бо панҷ токенсози маъмул шумораи токенҳоро ҳисоб кардем:
| Токенсоз | Тоҷикӣ | Русӣ | Англисӣ | Тоҷикӣ / Англисӣ |
|---|---|---|---|---|
GPT-4 (cl100k_base) | 134 | 84 | 37 | ×3,6 |
GPT-4o (o200k_base) | 62 | 47 | 37 | ×1,7 |
| mBERT | 80 | 49 | 41 | ×2,0 |
| multilingual-e5 (XLM-R) | 89 | 45 | 41 | ×2,2 |
| Qwen2.5 | 108 | 61 | 37 | ×2,9 |
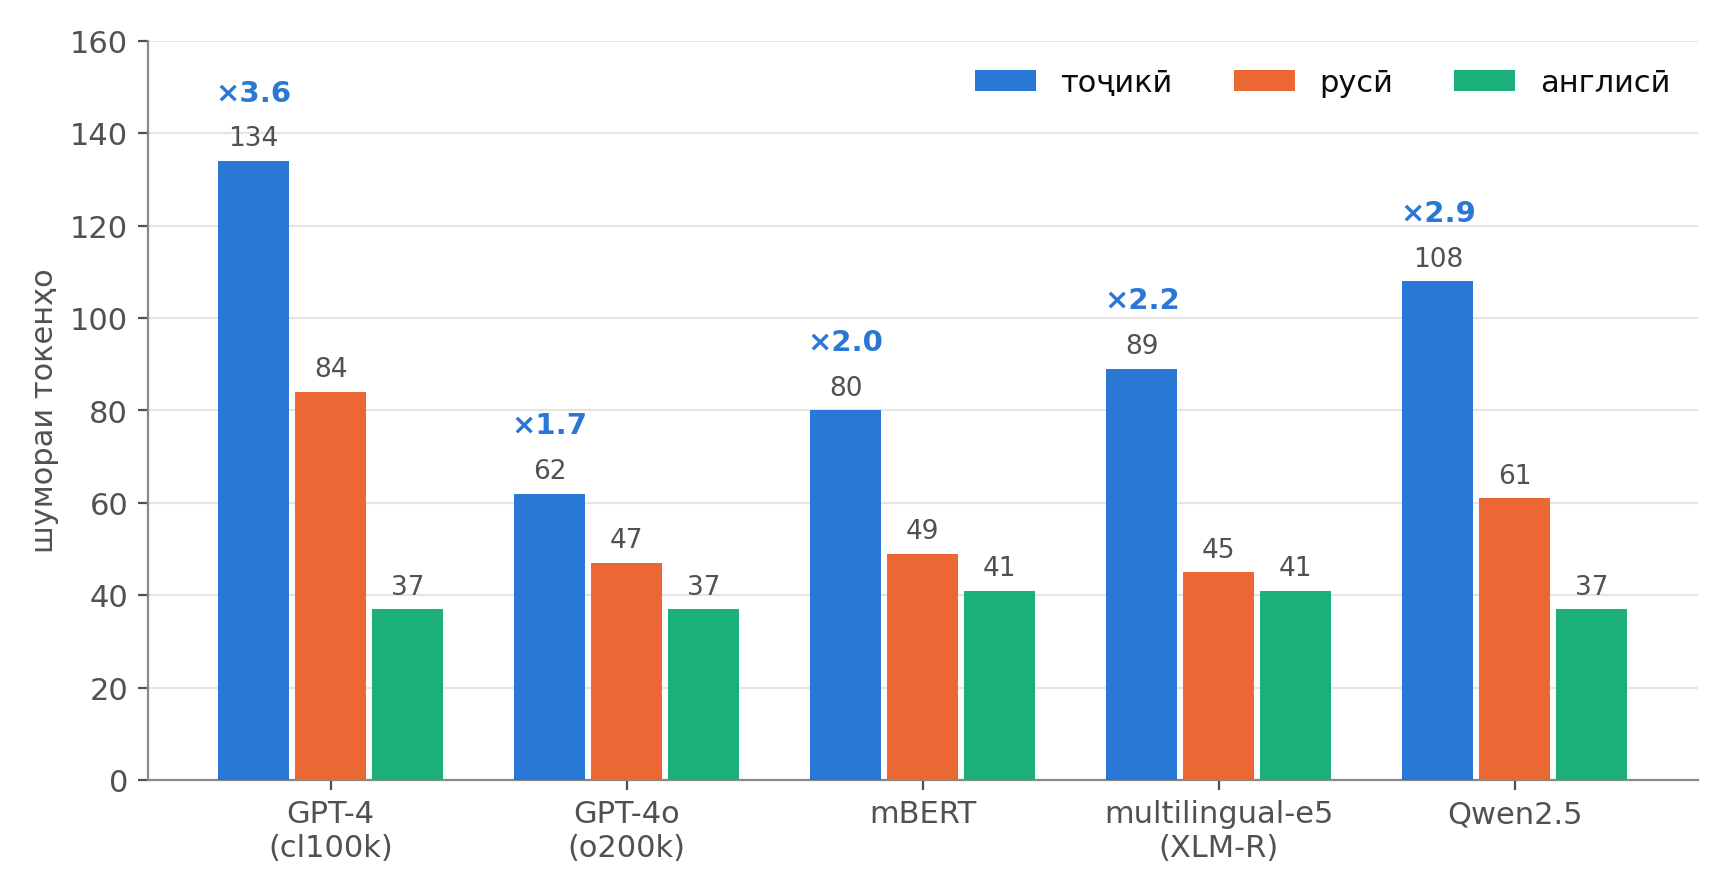
Расми 16.1. Шумораи токенҳо барои як матни ҳаммаъно ба тоҷикӣ, русӣ ва англисӣ. Рақами кабуд нишон медиҳад, ки матни тоҷикӣ аз англисӣ чанд маротиба зиёдтар токен мегирад. Ин натиҷаи як матни кӯтоҳ аст; дар додаҳои худ ин нисбат метавонад дигар бошад.
Аз ҷадвал якчанд хулоса мебарояд:
- Матни тоҷикӣ дар ҳамаи токенсозҳо аз англисӣ ва ҳатто аз русӣ қиматтар аст. Русӣ ҳам бо кириллӣ навишта мешавад, вале токенсозҳо матни русиро бисёр дидаанд ва пораҳои калонтари русиро ҳамчун як токен медонанд.
- Токенсози нав метавонад фарқи калон кунад. Токенсози
o200k_baseлуғати калонтар дорад ва ҳамон матни тоҷикиро нисбат баcl100k_baseбо 2 маротиба камтар токен рамзгузорӣ мекунад. - Модели «бисёрзабона» маънои «барои тоҷикӣ хуб»-ро надорад. Ҳар токенсоз бояд бо матни худи шумо санҷида шавад.
Ба тақсимоти калимаҳои алоҳида бо токенсози o200k_base нигаред:
"information"  → ["information"]                       (1 токен)
"тоҷикӣ"       → ["то", "ҷик", "ӣ"]                     (3 токен)
"Тоҷикистон"   → ["То", "ҷики", "стон"]                 (3 токен)
"китобҳоямон"  → ["к", "ит", "об", "ҳ", "оя", "мон"]    (6 токен)
Сарҳадҳои токенҳо бо сарҳадҳои морфемаҳо («китоб» + «ҳо» + «ям» + «он») қариб мувофиқат намекунанд. Модел маънои калимаро бояд аз пораҳое барқарор кунад, ки худашон маъно надоранд.
Оқибатҳои амалӣ
Зиёд будани токенҳо чор оқибат дорад:
- Нарх. Хизматрасониҳои API барои ҳар токен пул мегиранд. Агар матни тоҷикӣ 2–3 маротиба зиёдтар токен гирад, ҳамон кор ба тоҷикӣ 2–3 маротиба гаронтар меафтад.
- Контекст. Равзанаи контексти модел бо токен чен карда мешавад. Ба равзанаи 8 ҳазор токен матни англисии тақрибан 6 ҳазор калимагӣ ҷой мегирад, вале матни тоҷикӣ хеле камтар. Ин барои RAG (боби 11) ва агентҳо (боби 12) муҳим аст.
- Суръат. Модел ҳар токенро алоҳида тавлид мекунад (боби 9). Ҷавоби тоҷикӣ бо ҳамон дарозӣ ба вақти бештар ниёз дорад.
- Сифат. Модел бояд маъноро аз пораҳои майда ҷамъ кунад ва ин кори ӯро душвортар мекунад.
Токенҳоро худатон ҳисоб кунед
Пеш аз интихоби модел ё ҳисоб кардани хароҷот, шумораи токенҳоро дар матнҳои худ чен кунед. Нишондиҳандаи маъмул — миқдори токен ба ҳар калима (Fertility): ҳар қадар хурдтар бошад, ҳамон қадар токенсоз барои забон беҳтар аст.
import tiktoken
from tokenizers import Tokenizer

text = open("namuna_tj.txt", encoding="utf-8").read()
words = len(text.split())

tokenizers = {
    "cl100k_base": tiktoken.get_encoding("cl100k_base").encode,
    "o200k_base": tiktoken.get_encoding("o200k_base").encode,
}
for repo in ["intfloat/multilingual-e5-base", "Qwen/Qwen2.5-7B-Instruct"]:
    tok = Tokenizer.from_pretrained(repo)
    tokenizers[repo] = lambda s, t=tok: t.encode(s, add_special_tokens=False).ids

for name, encode in tokenizers.items():
    n = len(encode(text))
    print(f"{name:35} {n:6} токен  {n / words:.2f} токен/калима")
Барои матни англисӣ ин нишондиҳанда одатан ба 1,1–1,3 наздик аст. Дар мисоли болоӣ барои тоҷикӣ он аз 2 то 4,5 буд.
Як ҳарф — ду шакл
Ҳарфҳои «ӣ» ва «ӯ» дар Unicode ду шакл доранд:
- шакли якҷоя (Precomposed): «ӣ» — як аломати
U+04E3; - шакли таркибӣ (Combining): «и» + аломати болонависи
U+0304.
Дар экран ҳарду якхела менамоянд, вале барои компютер ду сатри гуногунанд. Бо токенсози o200k_base калимаи «иҷтимоӣ» дар шакли якҷоя 4 токен ва дар шакли таркибӣ 6 токен мегирад. Ғайр аз ин, ҷустуҷӯи «иҷтимоӣ» матнеро, ки бо шакли таркибӣ навишта шудааст, намеёбад.
Роҳи ҳал — мӯътадилсозии Unicode бо шакли NFC:
import unicodedata

word = "иҷтимои\u0304"                 # «и» + аломати болонавис
fixed = unicodedata.normalize("NFC", word)
print(len(word), len(fixed))           # 8 7
print(fixed == "иҷтимоӣ")              # True
Дар хотир доред, ки NFC танҳо «ӣ» ва «ӯ»-ро ислоҳ мекунад. Ҳарфҳои «ҳ, қ, ҷ, ғ» шакли таркибӣ надоранд ва хатоҳои онҳо (масалан, «х» ба ҷои «ҳ») бо NFC ислоҳ намешаванд.
Васеъ кардани луғати токенсоз
Агар токенсоз матни тоҷикиро бад тақсим кунад, метавон ба луғати он токенҳои нави тоҷикӣ илова кард. Ин усулро васеъ кардани луғат (Vocabulary Extension) меноманд. Қадамҳои асосӣ:
- Дар корпуси калони тоҷикӣ токенсози нав (масалан, BPE ё SentencePiece) меомӯзонанд.
- Токенҳои наверо, ки дар луғати кӯҳна нестанд, ба токенсози модел илова мекунанд.
- Матритсаи эмбеддингҳо (ва қабати баромад) -ро барои токенҳои нав калон мекунанд.
- Эмбеддинги ҳар токени навро бо миёнаи эмбеддингҳои пораҳои кӯҳнаи ҳамон матн оғоз мекунанд.
- Моделро бо омӯзиши пешакии давомдор (дар поён) бо матни тоҷикӣ меомӯзонанд, то токенҳои навро «фаҳмад».
Коди зер ғояи қадамҳои 2–4-ро нишон медиҳад:
import torch
from transformers import AutoModelForCausalLM, AutoTokenizer

name = "номи-модели-асосӣ"
tokenizer = AutoTokenizer.from_pretrained(name)
model = AutoModelForCausalLM.from_pretrained(name)

# Калимаҳо ё пораҳои серистеъмоли тоҷикӣ аз корпуси худ
new_tokens = ["тоҷикӣ", "Тоҷикистон", "маълумот", "ҳамчунин", "мебошад"]

# Пораҳои кӯҳнаи ҳар токенро пеш аз илова кардан нигоҳ медорем
old_ids = {t: tokenizer(t, add_special_tokens=False).input_ids for t in new_tokens}

tokenizer.add_tokens(new_tokens)
model.resize_token_embeddings(len(tokenizer))

inp = model.get_input_embeddings().weight
out = model.get_output_embeddings().weight
with torch.no_grad():
    for t in new_tokens:
        new_id = tokenizer.convert_tokens_to_ids(t)
        inp[new_id] = inp[old_ids[t]].mean(dim=0)
        out[new_id] = out[old_ids[t]].mean(dim=0)
Эзоҳ:
add_tokensтокенҳоро ҳамчун «токенҳои иловагӣ» илова мекунад, ки бо қоидаҳои муттаҳидсозии BPE кор намекунанд. Ин барои нишон додани ғоя кофӣ аст. Дар лоиҳаи воқеӣ одатан токенсози нави тоҷикиро меомӯзонанд ва бо токенсози кӯҳна якҷоя мекунанд.
Васеъ кардани луғат танҳо ҳамроҳ бо омӯзиши иловагӣ фоида медиҳад. Бе он модел эмбеддингҳои навро намедонад ва сифат ҳатто метавонад паст шавад. Барои ҳамин аввал санҷед, ки оё модели дорои токенсози беҳтар (масалан, бо луғати калонтар) аллакай вуҷуд надорад.
Кадом моделҳо забони тоҷикиро медонанд?
Рӯйхати моделҳо зуд-зуд иваз мешавад: ҳар чанд моҳ моделҳои нав бо дастгирии беҳтари забонҳои гуногун пайдо мешаванд. Барои ҳамин дар ин ҷо на рейтинги моделҳо, балки гурӯҳҳои асосӣ ва тарзи интихобро меорем.
Моделҳои калони тиҷоратӣ (тавассути API). Моделҳои калонтарини тиҷоратӣ одатан тоҷикиро аз ҳама беҳтар медонанд, зеро бо миқдори бузурги матни бисёрзабона омӯзонида шудаанд. Камбудиҳояшон — нарх (бо назардошти токенҳои зиёди тоҷикӣ) ва фиристодани маълумот ба сервери берунӣ (ниг. боби 13).
Моделҳои кушодаи бисёрзабона. Моделҳои кушодаи маъмул (масалан, оилаҳои Qwen, Llama, Gemma, Mistral) бо андозаҳои гуногун дастрасанд ва онҳоро дар сервери худ кор андохтан мумкин аст. Сифати тоҷикии онҳо аз модел ба модел хеле фарқ мекунад: моделҳои хурд (то тақрибан 10 миллиард параметр) аксар вақт тоҷикиро бад менависанд ё ба русӣ ва форсӣ мегузаранд. Ин моделҳо барои танзими дақиқ (ниг. поёнтар) мувофиқанд.
Моделҳои тарҷума. Моделҳои махсуси тарҷума, масалан NLLB-200, тоҷикиро (бо рамзи tgk_Cyrl) дар рӯйхати забонҳои худ доранд. Онҳо барои тарҷумаи ҳуҷҷатҳо ва сохтани додаҳои омӯзишӣ муфиданд, вале барои суҳбат ва иҷрои дастурҳо пешбинӣ нашудаанд.
Моделҳои эмбеддинг. Барои ҷустуҷӯ ва RAG моделҳои бисёрзабонаи эмбеддинг (масалан, multilingual-e5, bge-m3, LaBSE) истифода мешаванд. Чӣ тавре ки дар боби 11 гуфтем, онҳоро бо саволҳо ва ҳуҷҷатҳои воқеии тоҷикии худ санҷед.
Моделҳои нутқ. Whisper ва моделҳои MMS (Massively Multilingual Speech) тоҷикиро дар рӯйхати забонҳои худ доранд. Дар ин бора дар охири боб сухан меравад.
Эзоҳ: Дар корти модел (Model Card) рӯйхати забонҳо ва додаҳои омӯзиширо бинед. Агар тоҷикӣ дар рӯйхат набошад, ин маънои онро надорад, ки модел тоҷикиро тамоман намедонад. Агар бошад, ин кафолати сифат нест. Ягона роҳи боэътимод — санҷиш дар вазифаи худ.
Чӣ гуна моделро барои вазифаи худ интихоб кунем
Ба рейтингҳои умумӣ такя накунед: модели беҳтарин барои англисӣ метавонад барои тоҷикӣ миёна бошад. Ба ҷои ин, маҷмӯаи хурди санҷишии худро созед (ниг. боби 14):
- 50–100 вазифаи воқеӣ ҷамъ кунед — ҳамон саволҳо ва матнҳое, ки корбарони шумо медиҳанд: бо хатоҳои имлоӣ, бе ҳарфҳои махсус, бо омехтаи русӣ.
- Ҳар моделро бо як промпт ва як танзимоти тавлид иҷро кунед.
- Ҷавобҳоро аз рӯи меъёрҳои дар қисми «Арзёбӣ» овардашуда баҳо диҳед.
- Нархро бо назардошти шумораи воқеии токенҳои тоҷикӣ ҳисоб кунед.
Модели хурдтаре, ки баъд аз танзими дақиқ дар вазифаи шумо хуб кор мекунад, аксар вақт аз модели калони умумӣ арзонтар ва зудтар аст.
Сохтани маҷмӯаи додаҳои тоҷикӣ
Барои танзими дақиқ, омӯзиши пешакии давомдор, RAG ва арзёбӣ ба матни тоҷикӣ ниёз дорем. Сифати модел аз сифати ин матн вобаста аст: «ахлот медиҳӣ — ахлот мегирӣ» (Garbage In, Garbage Out).
Манбаъҳо
- Википедияи тоҷикӣ — матни нисбатан тоза ва сохторёфта, вале ҳаҷмаш маҳдуд ва баъзе мақолаҳо тарҷумаи мошинӣ ё хеле кӯтоҳанд.
- Корпусҳои бисёрзабонаи веб. Маҷмӯаҳои калони кушода, ки аз Common Crawl сохта шудаанд (масалан, CC-100, mC4, OSCAR, MADLAD-400, FineWeb-2), қисми тоҷикӣ доранд. Андоза ва сифати қисми тоҷикиро пеш аз истифода худатон санҷед: дар он матнҳои русӣ, ахлоти саҳифаҳои веб ва тарҷумаҳои бесифат кам нестанд.
- Сомонаҳои хабарӣ ва расмӣ. Матни адабӣ ва имлои нисбатан дуруст доранд. Пеш аз ҷамъоварӣ шартҳои истифодаи сомонаро бинед.
- Китобҳо ва ҳуҷҷатҳои сканшуда. Бисёре аз беҳтарин матнҳои тоҷикӣ — адабиёт, китобҳои дарсӣ, илмӣ — танҳо дар шакли PDF-и сканшуда мавҷуданд. Барои онҳо OCR лозим аст.
- Матнҳои мувозӣ (Parallel Corpora) — ҷуфти ҷумлаҳо ба ду забон, масалан, дар маҷмӯаи OPUS. Барои тарҷума ва барои сохтани додаҳои бисёрзабона истифода мешаванд.
- Матнҳои худи ташкилот — ҳуҷҷатҳо, саволу ҷавобҳои мизоҷон, мукотиба. Онҳо барои вазифаи шумо аз ҳама муҳиманд, вале бояд аз маълумоти шахсӣ тоза карда шаванд.
Эзоҳ: Ҳуқуқи муаллиф ба матнҳои тоҷикӣ ҳам дахл дорад. Барои китобҳо ва мақолаҳо иҷозати муаллиф ё ноширро гиред, ё танҳо матнҳои озодро истифода баред. Ба корпуси омӯзишӣ рақами телефон, суроға, рақами шиноснома ва дигар маълумоти шахсиро ворид накунед.
Марҳилаҳои коркард
Матни хом аз ҳар манбае, ки бошад, пеш аз истифода бояд аз чанд марҳила гузарад.
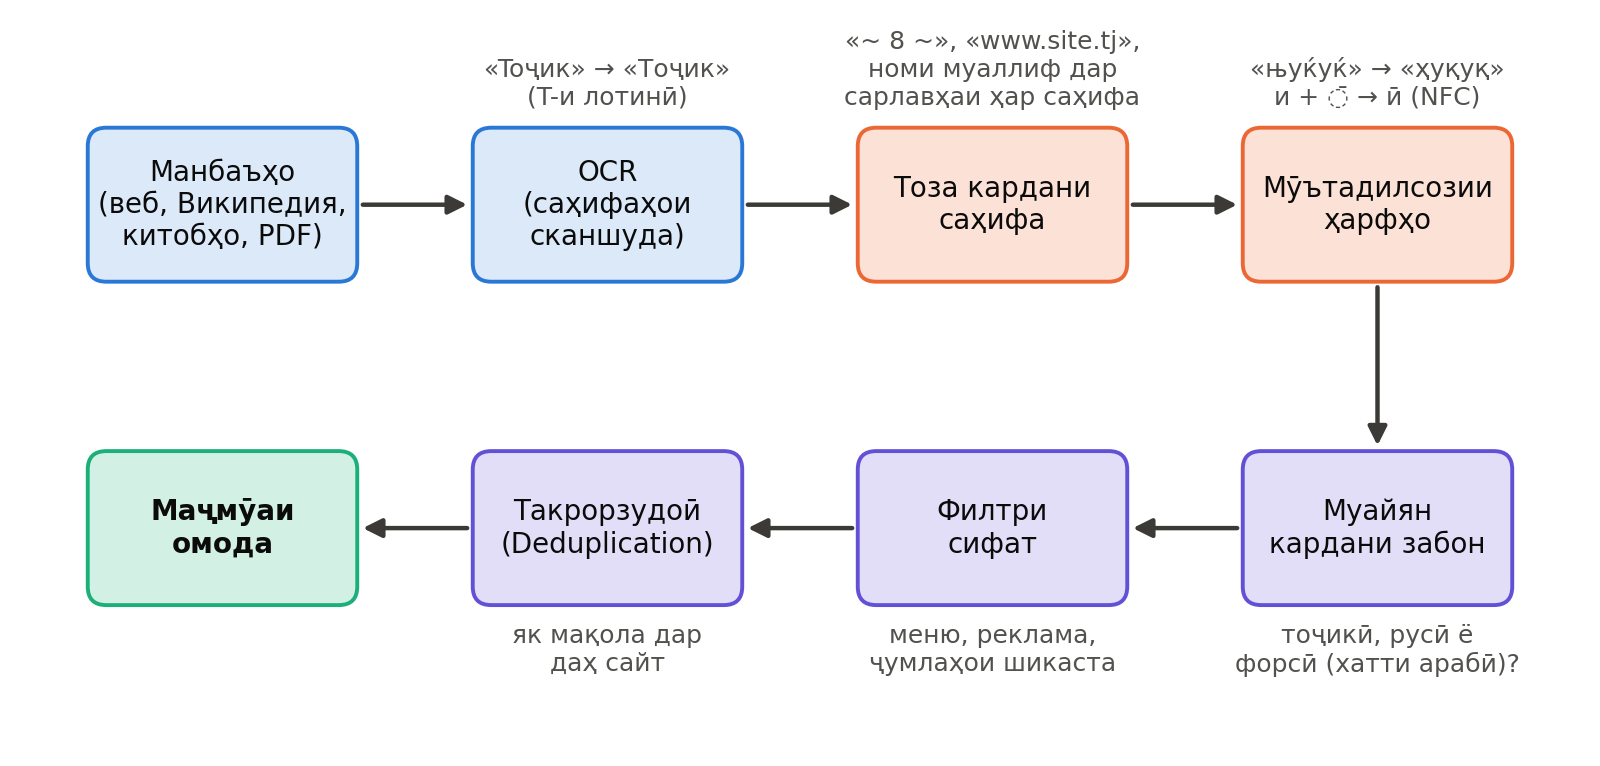
Расми 16.2. Марҳилаҳои сохтани маҷмӯаи додаҳои тоҷикӣ. Дар болои ҳар қадам мисоли хатое оварда шудааст, ки дар он ислоҳ мешавад.
Ҳар марҳиларо алоҳида баррасӣ мекунем.
Матнҳои сканшуда ва OCR
Барномаҳои OCR (Optical Character Recognition — шинохти оптикии аломатҳо) аксаран бо забонҳои калон омӯзонида шудаанд ва бо тоҷикӣ хатоҳои хоси худро мекунанд. Дар коркарди китобҳои тоҷикӣ мо бо ин хатоҳо зиёд дучор шудем:
Ҳарфҳои «ҳамшакл» аз шрифтҳои кӯҳна. Пеш аз паҳн шудани Unicode шрифтҳои тоҷикӣ ҳарфҳои махсусро бо истифода аз ҷойи ҳарфҳои дигари кириллӣ, ки ба онҳо монанд буданд, нишон медоданд. Дар матнҳое, ки бо чунин шрифтҳо чоп шудаанд, ҳоло ҳам ин ҳарфҳо вомехӯранд:
| Дар матн | Бояд бошад | Ҳарфи аслӣ аз куҷо |
|---|---|---|
| қ | қ | мақдунӣ |
| ғ | ғ | мақдунӣ |
| ҷ | ҷ | сербӣ / мақдунӣ |
| ҳ | ҳ | сербӣ / мақдунӣ |
| ӣ | ӣ | украинӣ |
Ин хатоҳо муайян ҳастанд: ҳарфи «қ» дар матни тоҷикӣ ҳамеша «қ» аст. Барои ҳамин онҳоро бо ҷадвали оддӣ бехатар ислоҳ кардан мумкин аст.
Ҳарфҳои лотинӣ дар дохили калимаи кириллӣ. Ҳарфҳои «А, В, Е, К, М, Н, О, Р, С, Т, Х» дар кириллӣ ва лотинӣ якхела менамоянд. OCR баъзан «Тоҷикистон»-ро бо «T»-и лотинӣ мехонад. Чунин калима ба чашм дуруст аст, вале барои токенсоз ва ҷустуҷӯ калимаи дигар аст. Ислоҳ бояд танҳо дар дохили калимаҳое бошад, ки ҳарфҳои кириллӣ доранд, то калимаҳои воқеии лотинӣ («Facebook», «www.site.tj») вайрон нашаванд. Дар ин ҷо як доми пинҳон ҳаст: дар тоҷикӣ ба номҳои англисӣ пасванд бо тире ҳамроҳ мешавад («Python-ро», «API-и»). Агар «Python-ро»-ро як калима ҳисоб кунем, пасванди кириллии «-ро» боиси иваз шудани ҳарфҳои «Python» мегардад ва «Руthоn» ҳосил мешавад. Барои ҳамин қисмҳои байни тиреҳо алоҳида санҷида мешаванд.
«ӣ» ва «й». OCR ин ду ҳарфро зуд-зуд омехта мекунад: «иҷтимой» ба ҷои «иҷтимоӣ», «ҳарбй» ба ҷои «ҳарбӣ». Аммо, чӣ тавре ки дар боло гуфтем, «й» ҳарфи дурусти тоҷикӣ аст («пайдо», «ҷой», «қайд»). Қоидаи бехатар чунин аст: «й» баъд аз ҳамсадо («ҳарбй», «чй», «ҷамъиятй») қариб ҳамеша хато аст, вале «й» баъд аз садонок («ҷой», «рӯй», «қулай») аксар вақт дуруст аст. Ҳолатҳои баҳсталабро шахси забондон бояд бинад.
Сарлавҳа ва пойнавис. Дар ҳар саҳифаи китоб номи муаллиф, номи китоб, суроғаи сомона ё рақами саҳифа такрор мешавад. Пас аз OCR ин сатрҳо ба мобайни матн меафтанд ва ҷумлаҳоро мешикананд. Баъзан пойнавис ба сатри охири саҳифа часпида мемонад: «…Ҳар сол тиwww.site.tj». Рақами саҳифа низ метавонад шаклҳои гуногун дошта бошад: «8», «~ 8 ~», «— 8 —» ё ҳатто рақам дар байни аломатҳои ноаён аз шрифти махсус.
Тире дар охири сатр. Калимаҳое, ки дар охири сатр бо тире ба ду қисм тақсим шудаанд («маълу-» / «мот»), бояд дубора якҷоя карда шаванд. Аммо тиреҳои дурусти тоҷикӣ («оҳиста-оҳиста», «ҷамъиятӣ-сиёсӣ») бояд боқӣ монанд.
Коди зер сатрҳоеро меёбад, ки дар аввал ё охири бисёр саҳифаҳо такрор мешаванд, ва онҳоро ҳамроҳи рақамҳои саҳифа нест мекунад. Ҳар ду қоида танҳо ба ду сатри аввал ва ду сатри охири ҳар саҳифа татбиқ мешаванд:
import re
from collections import Counter

def repeated_edge_lines(pages, edge=2, min_share=0.3):
    """Сатрҳое, ки дар аввал ё охири бисёр саҳифаҳо такрор мешаванд."""
    counts = Counter()
    for page in pages:
        lines = [l.strip() for l in page.splitlines() if l.strip()]
        counts.update(set(lines[:edge] + lines[-edge:]))
    limit = max(2, int(len(pages) * min_share))
    return {line for line, n in counts.items() if n >= limit}

# Танҳо 1–3 рақам: соли «1986» дар сатри алоҳида рақами саҳифа нест
PAGE_NUMBER = re.compile(r"^\W*\d{1,3}\W*$")

def clean_pages(pages, edge=2):
    junk = repeated_edge_lines(pages, edge)
    result = []
    for page in pages:
        lines = page.splitlines()
        filled = [i for i, l in enumerate(lines) if l.strip()]
        edges = set(filled[:edge] + filled[-edge:])   # 2 сатри аввал ва 2 сатри охир
        keep = [l for i, l in enumerate(lines)
                if i not in edges
                or (l.strip() not in junk and not PAGE_NUMBER.match(l.strip()))]
        result.append("\n".join(keep))
    return result
Ба ду нукта диққат диҳед. Якум, ифодаи PAGE_NUMBER танҳо 1–3 рақамро мегирад: дар китобҳо соли навиштани мақола ё шеър («1986») аксар вақт дар сатри алоҳида меояд ва набояд нест карда шавад. Дуюм, номи муаллиф дар сатри аввали саҳифа сарлавҳа аст, вале ҳамон ном дар имзои мактуб ё дар иқтибос қисми матн аст. Барои ҳамин код ба мобайни саҳифа даст намезанад: рақами «100» ё имзо дар мобайни матн боқӣ мемонанд. Аммо агар мактуб маҳз дар охири саҳифа ба поён расад, имзои он бо пойнавис омехта шуда метавонад. Пас аз тоза кардан натиҷаро бо чашм санҷед.
Мӯътадилсозии ҳарфҳо
Пас аз тоза кардани саҳифаҳо матнро ба як шакли ягона меоварем:
import re
import unicodedata

LEGACY = str.maketrans({
    "қ": "қ", "Қ": "Қ", "ғ": "ғ", "Ғ": "Ғ", "ҷ": "ҷ", "Ҷ": "Ҷ",
    "ҳ": "ҳ", "Ҳ": "Ҳ", "ӣ": "ӣ", "Ӣ": "Ӣ",
})
LATIN_TWINS = str.maketrans("AaBCcEeHKMOoPpTXxy", "АаВСсЕеНКМОоРрТХху")
CYRILLIC = re.compile(r"[\u0400-\u04FF]")
LATIN = re.compile(r"[A-Za-z]")

def fix_part(part):
    # Ҳарфҳои лотиниро танҳо дар қисме иваз мекунем, ки ҳам кириллӣ ва ҳам лотинӣ дорад
    if CYRILLIC.search(part) and LATIN.search(part):
        return part.translate(LATIN_TWINS)
    return part

def fix_word(word):
    # «Python-ро» ду қисм дорад: «Python» ва «ро». Ҳар кадомро алоҳида месанҷем,
    # то пасванди тоҷикӣ номи англисиро вайрон накунад.
    return "".join(fix_part(p) for p in re.split(r"([-‐–'’])", word))

def normalize(text):
    text = unicodedata.normalize("NFC", text)       # и + ◌̄ → ӣ
    text = text.translate(LEGACY)                   # қ → қ, ҳ → ҳ ...
    text = re.sub(r"\S+", lambda m: fix_word(m.group()), text)
    text = text.replace("\u00a0", " ")             # фосилаи ноаён
    return re.sub(r"[ \t]+", " ", text).strip()

print(normalize("Дар Toҷикистон ҳуқуқ ва иҷтимои\u0304; API-и Python-ро"))
# Дар Тоҷикистон ҳуқуқ ва иҷтимоӣ; API-и Python-ро
Ба коди боло ислоҳҳои эҳтимолӣ (масалан, «й» → «ӣ» ё «х» → «ҳ») ворид накардем. Онҳо ба контекст вобастаанд ва бояд алоҳида, бо санҷиши натиҷа иҷро шаванд. Қоидаи муҳим: дар марҳилаи мӯътадилсозӣ танҳо он чиро ислоҳ кунед, ки ҳамеша хато аст.
Эзоҳ: Матнҳоеро, ки ҳарфҳои махсус надоранд («хисоб», «чахон»), ба шакли дуруст овардан душвор аст: «х» метавонад «х» ё «ҳ» бошад, «к» — «к» ё «қ». Барои ин луғат ё модели махсус лозим аст. Агар чунин матн кам бошад, онро беҳтар аст аз маҷмӯаи омӯзишӣ хориҷ кунед. Аммо барои ҷустуҷӯ ва арзёбӣ нусхаи соддашудаи матн (бе ҳарфҳои махсус) муфид аст, зеро корбарон аксар вақт ҳамин тавр менависанд (ниг. боби 11).
Муайян кардани забон
Дар корпусҳои веб матнҳои русӣ, ӯзбекӣ, форсӣ ва англисӣ бо матни тоҷикӣ омехтаанд. Барои ҷудо кардани онҳо моделҳои муайянкунии забон (Language Identification) истифода мешаванд, масалан, моделҳои fastText ё GlotLID, ки тоҷикиро мешиносанд.
Дар баробари онҳо санҷишҳои оддии хат ва ҳарфҳо низ хеле муфиданд:
import re

TAJIK_ONLY = set("ӣӯҳқҷғӢӮҲҚҶҒ")
RUSSIAN_ONLY = set("цщыьЦЩЫЬ")
ARABIC = re.compile(r"[\u0600-\u06FF]")
LATIN = re.compile(r"[A-Za-z]")
CYRILLIC = re.compile(r"[\u0400-\u04FF]")

def script_report(text):
    letters = [c for c in text if c.isalpha()]
    n = max(1, len(letters))
    words = re.findall(r"\w+", text)
    return {
        "кириллӣ": sum(bool(CYRILLIC.match(c)) for c in letters) / n,
        "арабӣ": sum(bool(ARABIC.match(c)) for c in letters) / n,
        "лотинӣ": sum(bool(LATIN.match(c)) for c in letters) / n,
        "ҳарфҳои тоҷикӣ": sum(c in TAJIK_ONLY for c in letters) / n,
        "калимаҳо бо ц/щ/ы/ь": sum(any(c in RUSSIAN_ONLY for c in w) for w in words),
    }

print(script_report("Душанбе пойтахти Ҷумҳурии Тоҷикистон аст."))
# {'кириллӣ': 1.0, 'арабӣ': 0.0, 'лотинӣ': 0.0, 'ҳарфҳои тоҷикӣ': 0.0833..., ...}
Дар матни муқаррарии тоҷикӣ ҳиссаи ҳарфҳои махсус одатан чанд фоизро ташкил медиҳад. Агар матни дароз ин ҳарфҳоро тамоман надошта бошад, он ё русӣ аст, ё тоҷикии бе ҳарфҳои махсус. Ҳарфҳои «ц, щ, ы, ь» дар алифбои имрӯзаи тоҷикӣ нестанд ва аломати калимаҳои русиянд.
Филтри сифат ва такрорзудоӣ
Матни веб пур аз ахлот аст: менюҳо, рекламаҳо, сатрҳои «Ҳамаи ҳуқуқҳо ҳифз шудаанд», рӯйхати калимаҳои калидӣ. Филтрҳои оддӣ ин гуна матнҳоро хориҷ мекунанд:
- ҳуҷҷатҳои хеле кӯтоҳ;
- сатрҳое, ки бештар аз рақам ва аломатҳо иборатанд;
- ҳуҷҷатҳое, ки дар онҳо ҳиссаи калимаҳои такроршаванда хеле баланд аст;
- ҳуҷҷатҳое, ки ҳиссаи матни тоҷикиашон паст аст (бо
script_reportё модели муайянкунии забон).
Такрорзудоӣ (Deduplication) низ хеле муҳим аст. Як хабар метавонад дар даҳ сомона нашр шавад; модел онро даҳ маротиба мебинад ва аз ёд мекунад. Такрорҳои пурраро бо ҳисоб кардани хеши (Hash) ҳар ҳуҷҷат меёбанд. Барои ёфтани ҳуҷҷатҳои қариб якхела усулҳои махсус, масалан MinHash, истифода мешаванд.
Омехтагӣ бо русӣ ва матни лотинӣ
Ду қарорро бояд пешакӣ қабул кард:
- Матнҳои омехта бо русӣ. Агар модел бояд ба корбароне ҷавоб диҳад, ки омехта менависанд, чунин матнҳоро дар маҷмӯаи санҷишӣ нигоҳ доред. Аммо дар маҷмӯаи омӯзишӣ барои ҷавобҳо матни адабии тоҷикиро афзалтар донед, то модел ҳам омехта навиштанро наомӯзад.
- Тоҷикӣ бо ҳарфҳои лотинӣ. Табдили автоматии «hisobi man» ба «ҳисоби ман» душвор аст: «h» метавонад «ҳ» ё «х» бошад. Чунин матнҳоро ё алоҳида нигоҳ доред, ё фақат пас аз санҷиш табдил диҳед.
Мутобиқ кардани модел ба забони тоҷикӣ
Барои беҳтар кардани кори модел бо забони тоҷикӣ якчанд роҳ ҳаст. Онҳо аз ҷиҳати хароҷот, вақт ва додаҳои лозимӣ хеле фарқ мекунанд.
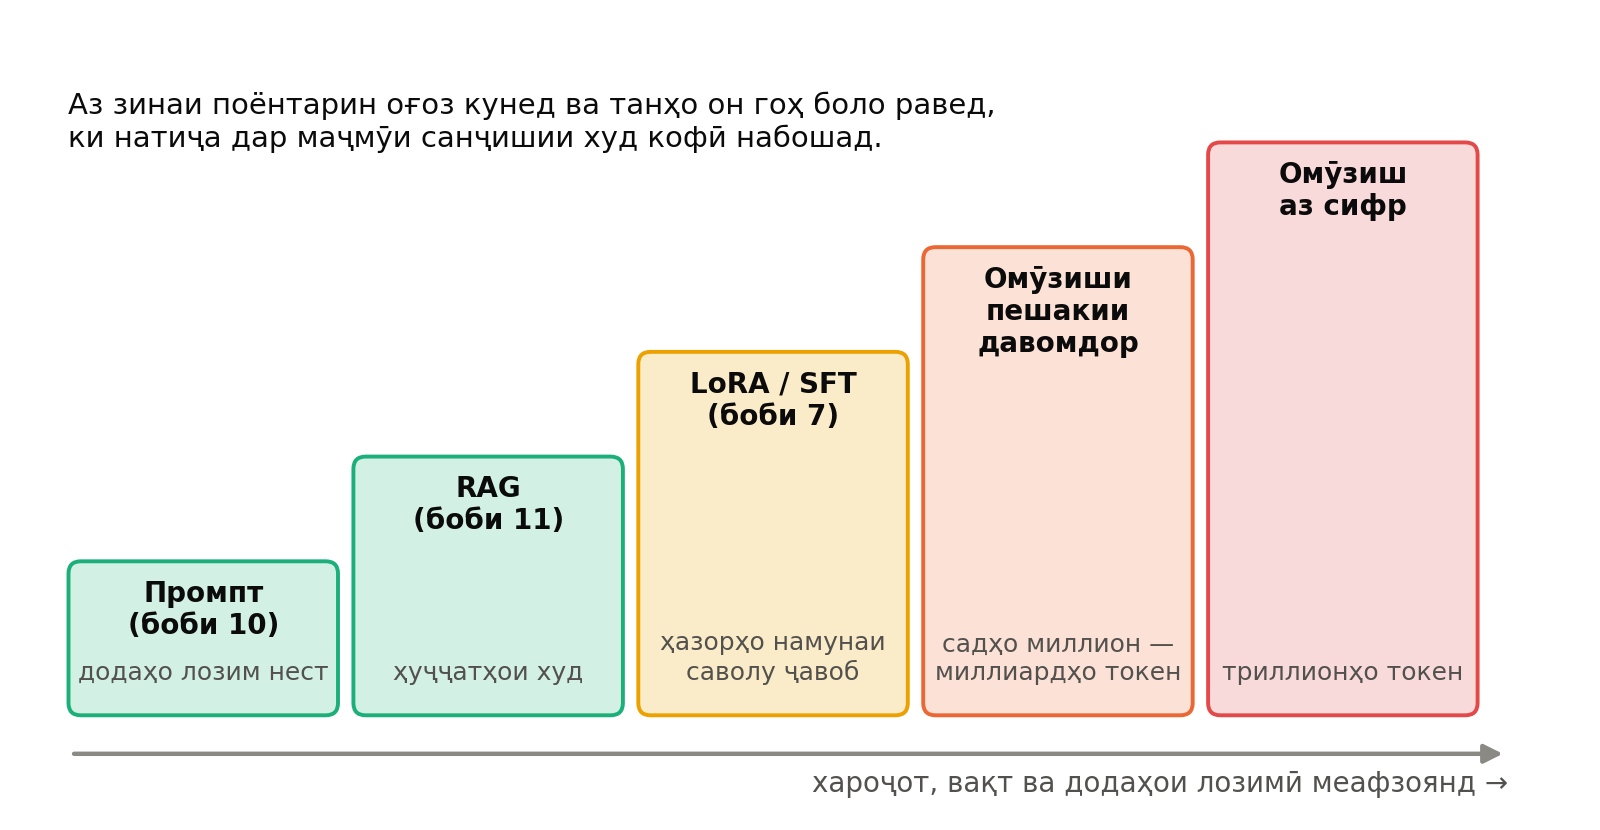
Расми 16.3. Роҳҳои мутобиқсозии модел ба забони тоҷикӣ. Ҳар зинаи болотар қавитар, вале гаронтар аст. Аз зинаи поён оғоз кунед.
Зинаи 1: промпт
Дар боби 10 тавсияҳоро барои навиштани промпти тоҷикӣ дидем: забон ва алифборо ошкоро нишон диҳед, мисолҳои тоҷикӣ оред, ба омехтагӣ бо русӣ диққат диҳед. Ин роҳ ҳеҷ додае талаб намекунад ва бояд аввалин қадам бошад.
Зинаи 2: RAG
Агар модел дар бораи мавзӯи шумо маълумот надошта бошад (қонунҳои Тоҷикистон, қоидаҳои ширкат), RAG (боби 11) ин маълумотро ба промпт илова мекунад. RAG забони моделро беҳтар намекунад, вале фактҳоро дуруст мекунад.
Зинаи 3: танзими дақиқ бо дастурҳои тоҷикӣ
Агар модел забонро умуман донад, вале услуб ва шакли ҷавобҳояш ба шумо мувофиқ набошад, танзими дақиқ бо дастурҳо (SFT, боби 7) кӯмак мекунад. Барои ин чанд ҳазор ҷуфти «дастур — ҷавоби хуб» ба тоҷикӣ лозим аст. Се роҳи сохтани чунин додаҳо ҳаст:
- Навиштани дастӣ. Беҳтарин сифат, вале гаронтарин роҳ. Ҳатто чандсад намунаи хуби дастӣ хеле арзишманданд.
- Тарҷумаи маҷмӯаҳои англисӣ. Зуд ва арзон, вале натиҷа аксар вақт «бӯи тарҷума» дорад (Translationese): ибораҳои сунъӣ ва мавзӯъҳое, ки ба ҳаёти тоҷикон дахл надоранд.
- Тавлид бо модели қавӣ. Модели калон аз рӯи матнҳои тоҷикӣ савол ва ҷавоб месозад. Ин роҳ серҳосил аст, вале бе санҷиши шахси забондон хатоҳои модел ба маҷмӯаи шумо ворид мешаванд.
Дар амал ин роҳҳоро омехта мекунанд: як қисми хурди намунаҳоро дастӣ менависанд ва онҳоро ҳамчун намуна барои тавлиди қисми боқимонда истифода мебаранд. Барои арзёбӣ бошад, танҳо намунаҳоеро истифода баред, ки аз ҷониби инсон санҷида шудаанд.
Зинаи 4: омӯзиши пешакии давомдор
Агар модел забони тоҷикиро суст донад — грамматикаро вайрон кунад, калимаҳоро набошад, ба русӣ гузарад — танзими дақиқ бо чанд ҳазор намуна кофӣ нест. Дар ин ҳолат омӯзиши пешакии давомдор (Continued Pre-training, ниг. боби 7) лозим аст: моделро бо ҳамон вазифаи пешгӯии токени навбатӣ (боби 6), вале ин дафъа бо матни калони тоҷикӣ, меомӯзонанд.
Барои ин садҳо миллион то миллиардҳо токени матни тоза лозим аст. Се хатарро дар назар доред:
- Фаромӯшии фалокатбор (Catastrophic Forgetting). Модел ҳангоми омӯзиш танҳо бо тоҷикӣ малакаҳои дигарашро (англисӣ, математика, барномасозӣ) қисман аз даст медиҳад. Барои пешгирӣ ба додаҳо як қисми матнҳои забонҳои дигарро илова мекунанд ва суръати омӯзиш (Learning Rate)-ро паст нигоҳ медоранд.
- Гум шудани малакаи иҷрои дастурҳо. Модели «Instruct» пас аз омӯзиш бо матни оддӣ дастурҳоро бадтар иҷро мекунад. Барои ҳамин пас аз омӯзиши пешакии давомдор боз танзими дақиқ бо дастурҳо (зинаи 3) лозим мешавад.
- Сифати додаҳо. Ҳамаи хатоҳои корпус — ҳарфҳои нодуруст, пойнависҳо, ҷумлаҳои шикаста — ба модел мегузаранд. Барои ҳамин қисми пешинаи ин боб дар бораи тоза кардани додаҳо ин қадар муфассал аст.
Омӯзиши пешакии давомдорро бо LoRA (боби 7) низ гузарондан мумкин аст. Дар ин ҳолат адаптерҳоро ба ҳамаи қабатҳои хаттӣ илова мекунанд ва, агар луғат васеъ шуда бошад, эмбеддингҳо ва қабати баромадро пурра меомӯзонанд:
import math

from datasets import Dataset, load_dataset
from peft import LoraConfig, get_peft_model
from transformers import (AutoModelForCausalLM, AutoTokenizer,
                          DataCollatorForLanguageModeling, Trainer, TrainingArguments)

name = "номи-модели-асосӣ"
tokenizer = AutoTokenizer.from_pretrained(name)
model = AutoModelForCausalLM.from_pretrained(name)

config = LoraConfig(
    r=64,
    lora_alpha=128,
    target_modules=["q_proj", "k_proj", "v_proj", "o_proj",
                    "gate_proj", "up_proj", "down_proj"],
    modules_to_save=["embed_tokens", "lm_head"],  # агар луғат васеъ шуда бошад
    lora_dropout=0.05,
    task_type="CAUSAL_LM",
)
model = get_peft_model(model, config)

if tokenizer.pad_token is None:
    tokenizer.pad_token = tokenizer.eos_token

# Корпуси тозашуда: як ҳуҷҷат дар ҳар сатр. 2% барои санҷиш ҷудо мешавад.
raw = load_dataset("text", data_files={"train": "corpus_tj.txt"})["train"]
split = raw.train_test_split(test_size=0.02, seed=0)

block = 1024
def blocks(dataset):
    """Ҳуҷҷатҳоро бо токени EOS байни онҳо пай дар пай пайваст карда,
    ба қисмҳои 1024-токенӣ тақсим мекунад. Боқимонда гум намешавад:
    он ба аввали қисми навбатӣ мегузарад."""
    buffer = []
    for example in dataset:
        buffer += tokenizer(example["text"])["input_ids"] + [tokenizer.eos_token_id]
        while len(buffer) >= block:
            yield {"input_ids": buffer[:block]}
            buffer = buffer[block:]

train_data = Dataset.from_generator(blocks, gen_kwargs={"dataset": split["train"]})
eval_data = Dataset.from_generator(blocks, gen_kwargs={"dataset": split["test"]})

trainer = Trainer(
    model=model,
    args=TrainingArguments(output_dir="model-tj", per_device_train_batch_size=4,
                           gradient_accumulation_steps=8, learning_rate=1e-4,
                           num_train_epochs=1, logging_steps=50, bf16=True,
                           eval_strategy="steps", eval_steps=500),
    train_dataset=train_data,
    eval_dataset=eval_data,
    data_collator=DataCollatorForLanguageModeling(tokenizer, mlm=False),
)

before = trainer.evaluate()["eval_loss"]
trainer.train()
after = trainer.evaluate()["eval_loss"]
print(f"Печидагӣ: пеш аз омӯзиш {math.exp(before):.1f}, баъд {math.exp(after):.1f}")
Ба ду ҷузъиёти код диққат диҳед. Токени EOS байни ҳуҷҷатҳо ба модел нишон медиҳад, ки як ҳуҷҷат тамом шуду дигаре оғоз ёфт; бе он охири як мақола ба аввали мақолаи дигар мечаспад. Ду фоизи корпус дар омӯзиш иштирок намекунад: печидагӣ (Perplexity, боби 14) дар ҳамин қисм пеш аз омӯзиш ва баъд аз он чен карда мешавад ва нишон медиҳад, ки модел матни тоҷикиро воқеан беҳтар пешгӯӣ мекунад. Дар баробари он печидагиро дар матни англисӣ низ чен кунед: агар он хеле боло равад, модел забонҳои дигарро фаромӯш мекунад.
Зинаи 5: омӯзиш аз сифр
Сохтани модели нави тоҷикӣ аз сифр миқдори бузурги матн ва ҳисоббарорӣ талаб мекунад (боби 6). Матни тоҷикии дастрас барои омӯзонидани модели муосир аз сифр кофӣ нест. Барои ҳамин қариб ҳамеша беҳтар аст, ки модели бисёрзабонаи мавҷударо мутобиқ кунем.
Арзёбии натиҷаҳои тоҷикӣ
Дар боби 14 усулҳои умумии арзёбиро дидем. Барои тоҷикӣ чанд нуктаи иловагӣ ҳаст.
Санҷишҳои мавҷуда
Барои тоҷикӣ шумораи ками санҷишҳои кушода мавҷуданд, масалан:
- FLORES-200 — ҷумлаҳои мувозӣ ба 200 забон (тоҷикӣ:
tgk_Cyrl) барои арзёбии тарҷума; - Belebele — саволҳои фаҳмиши матн ба забонҳои зиёд, ки дар асоси ҳамон ҷумлаҳои FLORES сохта шудаанд;
- SIB-200 — гурӯҳбандии мавзӯии ҷумлаҳо дар асоси FLORES.
Ин санҷишҳо барои муқоисаи моделҳо муфиданд, вале ду камбудӣ доранд. Якум, онҳо тарҷума аз англисӣ мебошанд ва забони табиии тоҷикиро пурра инъикос намекунанд. Дуюм, онҳо кушодаанд ва метавонанд ба маълумоти омӯзишии модел ворид шуда бошанд (олудашавӣ, ниг. боби 14).
Меъёрҳо барои ҷавобҳои тоҷикӣ
Ҷавоби тоҷикии модел метавонад аз рӯи мазмун дуруст, вале аз рӯи забон бад бошад. Барои ҳамин ҷавобҳоро аз рӯи якчанд меъёр баҳо медиҳанд:
| Меъёр | Савол | Мисоли хато |
|---|---|---|
| Забон | Ҷавоб ба тоҷикӣ аст? | Модел ба русӣ ё англисӣ гузаштааст |
| Хат | Бо кириллӣ навишта шудааст? | Ҷавоб бо хатти форсӣ (арабӣ) |
| Ҳарфҳо | Ҳарфҳои махсус дурустанд? | «хисоб», «чахон» |
| Омехтагӣ | Калимаҳои русии нолозим ҳастанд? | «Ин масъала очень муҳим аст» |
| Равонӣ | Ҷумлаҳо табиӣ ҳастанд? | Сохтори ҷумлаи англисӣ бо калимаҳои тоҷикӣ |
| Дурустӣ | Фактҳо дурустанд? | Санаҳо ва номҳои бофташуда |
| Иҷрои дастур | Вазифа иҷро шудааст? | Ба ҷои хулоса тарҷума кардааст |
Се меъёри аввалро метавон автоматӣ санҷид, масалан, бо функсияи script_report. Меъёрҳои боқимонда ба шахси забондон ё ба модели довар ниёз доранд.
Нишондиҳандаҳои автоматӣ барои тарҷума
Барои тарҷума нишондиҳандаи chrF нисбат ба BLEU беҳтар аст. chrF на калимаҳо, балки пайдарпайии ҳарфҳоро муқоиса мекунад. Барои забони тоҷикӣ, ки дар он калима шаклҳои зиёд дорад, ин муҳим аст: «китобҳоям» ва «китобҳоямон» барои BLEU ду калимаи комилан гуногунанд, вале барои chrF қариб якхелаанд.
from sacrebleu.metrics import CHRF

hyps = ["Ман ба мактаб меравам."]          # тарҷумаи модел
refs = [["Ман ба мактаб рафта истодаам."]]  # тарҷумаи инсон
print(CHRF().corpus_score(hyps, refs).score)
Пеш аз ҳисоб кардани нишондиҳанда ҳам ҷавоби модел ва ҳам матни истинодиро бо ҳамон normalize мӯътадил кунед. Вагарна фарқи «ӣ»-и якҷоя ва таркибӣ ҳамчун хато ҳисоб мешавад.
Модел ҳамчун довар барои тоҷикӣ
Усули «модел ҳамчун довар» (LLM-as-a-Judge, боби 14) барои тоҷикӣ бо эҳтиёт истифода мешавад: агар модели довар худаш тоҷикиро хуб надонад, хатоҳои забониро намебинад ва ҷавобҳои равони русиро аз ҷавобҳои тоҷикӣ беҳтар баҳо медиҳад. Пеш аз истифода:
- 50–100 ҷавобро ба шахси забондон диҳед, то баҳо гузорад.
- Ҳамон ҷавобҳоро ба модели довар диҳед.
- Санҷед, ки баҳоҳо то чӣ андоза мувофиқат мекунанд. Агар мувофиқат паст бошад, ба модели довар бовар накунед.
Нутқи тоҷикӣ: Whisper
Барои бисёр барномаҳо — ёрдамчиҳои овозӣ, сабти ҷаласаҳо, марказҳои занг — табдили нутқ ба матн (Automatic Speech Recognition, ASR) лозим аст. Модели Whisper (ниг. боби 5) тоҷикиро дар рӯйхати забонҳои худ дорад, вале сифаташ барои тоҷикӣ нисбат ба забонҳои калон хеле пасттар аст.
Санҷиши Whisper бо сабти тоҷикӣ:
from transformers import pipeline

asr = pipeline("automatic-speech-recognition", model="openai/whisper-large-v3")
result = asr("sabt.wav", generate_kwargs={"language": "tajik", "task": "transcribe"})
print(result["text"])
Забонро ҳатман нишон диҳед: бе он Whisper метавонад тоҷикиро ҳамчун форсӣ шиносад ва матнро бо хатти арабӣ нависад.
Чен кардани сифати ASR
Сифати ASR-ро бо ҳиссаи хатои калимаҳо (Word Error Rate, WER) чен мекунанд: шумораи калимаҳои ивазшуда, партофташуда ва иловашуда, тақсим ба шумораи калимаҳои матни дуруст. Барои тоҷикӣ ҳиссаи хатои ҳарфҳо (Character Error Rate, CER) низ муфид аст, зеро як хатои хурд дар пасванд тамоми калимаро «хато» мекунад.
import jiwer

refs = ["ман имрӯз ба бозор рафтам"]
hyps = ["ман имруз ба бозор рафтам"]
print("WER:", jiwer.wer(refs, hyps))   # 0.2 — як калима аз панҷ
print("CER:", jiwer.cer(refs, hyps))   # 0.04 — як ҳарф аз 25
Дар мисоли боло модел танҳо «ӯ»-ро бо «у» иваз кардааст, вале WER 20 фоиз шуд. Пеш аз ҳисоб матнҳоро мӯътадил кунед ва қарор диҳед, ки оё хатоҳои ҳарфҳои махсусро ҷудо ҳисоб мекунед. Ин ҳам як хатои воқеист, ки корбар мебинад.
Беҳтар кардани Whisper
Барои беҳтар кардани Whisper барои тоҷикӣ онро бо сабтҳои тоҷикӣ ва матни дурусти онҳо танзими дақиқ мекунанд (дастури «Automatic speech recognition» дар ҳуҷҷатҳои Hugging Face, ниг. боби 5). Маҷмӯаҳои кушодаи нутқи тоҷикӣ кам ҳастанд; яке аз онҳо қисми тоҷикии маҷмӯаи FLEURS аст. Аксар вақт сабтҳоро худатон бояд ҷамъ кунед. Барои ин нуктаҳо муҳиманд:
- Гуногунии гӯяндагон — мард ва зан, синну соли гуногун, лаҳҷаҳои шимол ва ҷануб.
- Шароити воқеӣ — садои кӯча, телефон, микрофони арзон, на танҳо сабти тозаи студия.
- Матни дақиқ — бо ҳарфҳои дурусти тоҷикӣ ва бо як қоидаи ягона барои рақамҳо, номҳо ва калимаҳои русӣ.
- Розигии гӯяндагон — овоз маълумоти шахсист; барои сабт ва истифодаи он розигии хаттӣ гиред.
Моделҳои MMS-и Meta низ барои тоҷикӣ ҳам ASR ва ҳам табдили матн ба нутқ (Text-to-Speech) пешниҳод мекунанд. Онҳоро бо ҳамон сабтҳо ва ҳамон нишондиҳандаҳо бо Whisper муқоиса кунед.
Хулоса
Дар ин боб мо дидем, ки чаро забони тоҷикӣ барои моделҳои бузурги забонӣ мушкилоти махсус дорад ва онҳоро чӣ гуна ҳал кардан мумкин аст.
Нуктаҳои асосӣ:
- Забони тоҷикӣ камманбаъ аст: модел онро сусттар медонад, дар бораи Тоҷикистон камтар медонад ва санҷишҳо кам ҳастанд.
- Матни тоҷикӣ, вобаста ба токенсоз, аз матни англисии ҳаммаъно 1,7–3,6 маротиба зиёдтар токен мегирад. Ин ба нарх, контекст, суръат ва сифат таъсир мерасонад. Токенҳоро дар матни худ чен кунед.
- Ҳарфҳои ӣ ва ӯ ду шакли Unicode доранд; матнро ҳамеша бо NFC мӯътадил кунед.
- Сифати маҷмӯаи додаҳо муҳимтарин омил аст. Матнҳои сканшуда хатоҳои хос доранд: ҳарфҳо аз шрифтҳои кӯҳна, ҳарфҳои лотинии ҳамшакл, «й»/«ӣ», сарлавҳа, пойнавис ва рақами саҳифа.
- Дар мӯътадилсозӣ танҳо он чиро ислоҳ кунед, ки ҳамеша хато аст; ислоҳҳои эҳтимолиро алоҳида ва бо санҷиш иҷро кунед.
- Мутобиқсозиро аз зинаи арзонтарин оғоз кунед: промпт, RAG, танзими дақиқ бо дастурҳо ва танҳо баъд омӯзиши пешакии давомдор.
- Ҷавобҳои тоҷикиро на танҳо аз рӯи мазмун, балки аз рӯи забон, хат ва ҳарфҳо низ арзёбӣ кунед. Ба модели довар танҳо пас аз муқоиса бо баҳои инсон бовар кунед.
- Whisper тоҷикиро дастгирӣ мекунад, вале бояд бо сабтҳои воқеӣ санҷида ва, агар лозим бошад, танзими дақиқ карда шавад.
Саволҳо барои санҷиши худ
- Чаро забони тоҷикӣ бо вуҷуди миллионҳо гӯянда забони камманбаъ ҳисоб мешавад?
- Чаро матни тоҷикӣ нисбат ба матни русии ҳаммаъно токенҳои бештар мегирад, ҳарчанд ҳарду бо кириллӣ навишта мешаванд?
- Зиёд будани токенҳо ба кадом чор ҷанбаи кори модел таъсир мерасонад?
- Фарқи шакли якҷоя ва таркибии ҳарфи «ӣ» дар чист? Мӯътадилсозии NFC кадом ҳарфҳои тоҷикиро ислоҳ мекунад ва кадомҳоро не?
- Чаро «й»-ро дар матни тоҷикӣ ба таври худкор ба «ӣ» иваз кардан мумкин нест?
- Кадом хатоҳои OCR-ро бо ҷадвали оддӣ бехатар ислоҳ кардан мумкин аст ва кадомҳо ба санҷиши инсон ниёз доранд?
- Омӯзиши пешакии давомдор аз танзими дақиқ бо дастурҳо чӣ фарқ дорад? Ҳар кадом кай лозим аст?
- Фаромӯшии фалокатбор чист ва онро чӣ гуна пешгирӣ мекунанд?
- Чаро барои арзёбии тарҷумаи тоҷикӣ chrF нисбат ба BLEU беҳтар аст?
- Чаро ба модели довар барои баҳо додани ҷавобҳои тоҷикӣ бояд бо эҳтиёт бовар кард?
Машқи амалӣ
- Як матни тоҷикиро (500–1000 калима) бо тарҷумаи англисӣ ва русии он гиред. Бо коди ин боб миқдори токен ба ҳар калимаро барои се токенсоз ҳисоб кунед. Натиҷаро бо ҷадвали ин боб муқоиса кунед.
- Ҳамон матнро бе ҳарфҳои махсус нависед («ҳ» → «х», «ҷ» → «ч» ва ғайра). Шумораи токенҳо чӣ гуна тағйир ёфт?
- Як PDF-и сканшудаи китоби тоҷикиро бо OCR ба матн табдил диҳед. Хатоҳои онро ба гурӯҳҳои ин боб тақсим кунед: ҳарфҳои шрифти кӯҳна, ҳарфҳои лотинӣ, «й»/«ӣ», сарлавҳа ва пойнавис, рақами саҳифа, тире дар охири сатр. Барои гурӯҳҳое, ки муайян ҳастанд, коди ислоҳ нависед.
- 30 савол ба тоҷикӣ нависед ва ба се модел диҳед. Ҷавобҳоро аз рӯи ҷадвали меъёрҳои ин боб баҳо диҳед. Кадом модел барои вазифаи шумо беҳтар аст ва чаро?
- Як дақиқа нутқи тоҷикиро сабт кунед ва бо Whisper ба матн табдил диҳед. Матни дурустро худатон нависед ва WER ва CER-ро ҳисоб кунед. Кадом хатоҳо бештар вомехӯранд?
 Барномасозӣ
 Олами Афсонаҳо
 Ахбор
 Саломатӣ
 Дунё