Омӯзиши моделҳои бузурги забонӣ (LLM)
Китоби омӯзишӣ дар бораи моделҳои бузурги забонӣ (LLM) ба забони тоҷикӣ: аз мафҳумҳои аввалия то усулҳои муосир. Токенсозӣ ва векторҳо, шабакаҳои нейронӣ, механизми таваҷҷуҳ ва Transformer, оилаҳои моделҳо, омӯзиши пешакӣ, танзими дақиқ ва LoRA, мутобиқсозӣ (RLHF, DPO), тавлиди матн, муҳандисии промпт, RAG, агентҳо, самаранокӣ, арзёбӣ ва бехатарӣ, тафсирпазирӣ ва истифодаи LLM барои забони тоҷикӣ. Бо мисолҳои код дар Python ва PyTorch, замимаҳои математика ва луғати истилоҳот.
Агенти Зеҳнӣ · 13 октябри 2026 · 18 саҳифа · 2 писанд
Боби 3. Шабакаҳои нейронӣ ва моделҳои пайдарпайӣ (RNN, LSTM, Seq2Seq)
Имрӯзҳо моделҳои омӯзиши амиқ (Deep Learning) нисбат ба пеш бо суръати бештар муаррифӣ мешаванд ва ҳар кадоми онҳо ба пешрафти ин соҳа саҳм мегузоранд. Бешубҳа, яке аз таъсиргузортарин моделҳое, ки то имрӯз пешниҳод шудаанд, моделҳои трансформерӣ (Transformer) мебошанд. Ҳамаи моделҳои бузурги забонии муосир (LLM) ба ин меъморӣ асос ёфтаанд.
Аммо трансформер аз осмон наафтодааст. Он ҷавоб ба мушкилоте буд, ки моделҳои пешина бо онҳо рӯ ба рӯ мешуданд. Барои он ки дар боби 4 механизми таваҷҷуҳ (Attention) ва трансформерро хуб фаҳмем, дар ин боб аввал асосҳоро меомӯзем: нейрон чист, шабака чӣ гуна меомӯзад ва моделҳои пайдарпайӣ (RNN, LSTM, Seq2Seq) матнро чӣ гуна коркард мекардаанд.
Дар ин боб меомӯзем
- Пеш аз шабакаҳои нейронӣ матнро чӣ гуна коркард мекарданд: «халтаи калимаҳо», n-граммаҳо ва TF-IDF.
- Нейрони сунъӣ чист ва функсияҳои фаъолсозӣ барои чӣ лозиманд.
- Шабака аз қабатҳо чӣ гуна сохта мешавад.
- Шабака чӣ гуна меомӯзад: функсияи хато, фуромади градиентӣ ва паҳншавии баръакси хато.
- Шабакаҳои нейронии такроршаванда (RNN) чӣ гуна матнро калима ба калима мехонанд.
- Мушкили нестшавии градиент чист ва LSTM ва GRU онро чӣ гуна сабук мекунанд.
- Моделҳои «пайдарпайӣ ба пайдарпайӣ» (Seq2Seq) ва сохтори рамзгузор–рамзкушо (Encoder–Decoder).
- Чаро вектори контексти андозаи собит ба «гулӯгоҳ» табдил ёфт ва ин чӣ гуна ба пайдоиши механизми таваҷҷуҳ овард.
Коркарди забон пеш аз шабакаҳои нейронӣ
Пеш аз он ки шабакаҳои нейронӣ дар коркарди забони табиӣ (NLP) ҳукмрон шаванд, олимон матнро бо усулҳои оморӣ (Statistical Methods) коркард мекарданд. Ин усулҳо содаанд, вале барои фаҳмидани он ки чаро шабакаҳои нейронӣ лозим шуданд, хеле муфиданд.
«Халтаи калимаҳо» (Bag of Words)
Дар ин усул ҳуҷҷат ҳамчун «халта»-е тасаввур мешавад, ки калимаҳо дар он бетартиб рехта шудаанд. Мо танҳо ҳисоб мекунем, ки ҳар калима чанд маротиба омадааст.
Масалан, ду ҷумла:
1. Ман китоб мехонам.
2. Ман мактуб менависам.
Луғат: {ман, китоб, мехонам, мактуб, менависам}. Акнун ҳар ҷумла ба вектор табдил меёбад:
| Ҷумла | ман | китоб | мехонам | мактуб | менависам |
|---|---|---|---|---|---|
| 1 | 1 | 1 | 1 | 0 | 0 |
| 2 | 1 | 0 | 0 | 1 | 1 |
Камбудии асосӣ: тартиби калимаҳо гум мешавад. Ҷумлаҳои «Саг гурбаро газид» ва «Гурба сагро газид» тақрибан як вектор мегиранд, гарчанде ки маънояшон баръакс аст.
N-граммаҳо (N-grams)
Барои он ки каме аз тартиб нигоҳ дошта шавад, ба ҷои калимаҳои алоҳида пайдарпайиҳои (n) калимаро ҳисоб мекунанд. Масалан, дар ҷумлаи «ман ба мактаб меравам» биграммаҳо ((n=2)) инҳоянд: «ман ба», «ба мактаб», «мактаб меравам».
Модели забонии n-граммӣ эҳтимоли калимаи навбатиро аз рӯи (n-1) калимаи пешина ҳисоб мекунад:
[
P(\text{меравам} \mid \text{ба мактаб}) = \frac{\text{шумораи «ба мактаб меравам»}}{\text{шумораи «ба мактаб»}}
]
Ин аллакай модели забонӣ аст: он калимаи навбатиро пешгӯӣ мекунад. Аммо ду мушкили ҷиддӣ дорад:
- Контексти кӯтоҳ. Модел танҳо чанд калимаи охиринро мебинад. Агар (n)-ро калон кунем, шумораи омезишҳои имконпазир ба таври экспоненсиалӣ меафзояд.
- Камёбии маълумот (Data Sparsity). Бисёр омезишҳои дуруст ҳеҷ гоҳ дар маълумоти омӯзишӣ дида нашудаанд ва эҳтимоли онҳо сифр мешавад.
TF-IDF
TF-IDF (Term Frequency – Inverse Document Frequency) вазни калимаро дар ҳуҷҷат бо ду омил муайян мекунад:
- TF — калима дар ин ҳуҷҷат чанд маротиба омадааст;
- IDF — калима дар чанд ҳуҷҷати дигар вомехӯрад. Калимаҳои хеле маъмул, монанди «ва», «дар», «ин», вазни кам мегиранд.
[
\text{TF-IDF}(t, d) = \text{TF}(t, d) \cdot \log \frac{N}{\text{DF}(t)}
]
Ин ҷо (N) — шумораи умумии ҳуҷҷатҳо, (\text{DF}(t)) — шумораи ҳуҷҷатҳое, ки калимаи (t)-ро доранд.
TF-IDF ва хеши наздики он BM25 то ҳол дар ҷустуҷӯ истифода мешаванд (дар боби 11 дар бораи ҷустуҷӯи омехта мебинем).
Маҳдудиятҳои усулҳои оморӣ
| Мушкил | Шарҳ |
|---|---|
| Тартиб гум мешавад | «Халтаи калимаҳо» намедонад, ки кадом калима аввал омад |
| Маъно фаҳмида намешавад | «Мошин» ва «автомобил» ду калимаи комилан ҷудо ҳисоб мешаванд |
| Контексти кӯтоҳ | N-граммаҳо танҳо чанд калимаи наздикро мебинанд |
| Векторҳои калон ва холӣ | Андозаи вектор ба андозаи луғат баробар аст ва аксари қиматҳо сифранд |
Дар боби 2 дидем, ки векторҳои калима (Word Embeddings) мушкили дуюмро ҳал мекунанд: калимаҳои ҳаммаъно векторҳои наздик мегиранд. Барои ҳалли мушкилоти дигар ба моделҳое ниёз доштем, ки метавонанд худашон аз маълумот қонуниятҳои мураккабро ёд гиранд. Ин моделҳо шабакаҳои нейронӣ (Neural Networks) мебошанд.
Нейрони сунъӣ
Нейрони сунъӣ (Artificial Neuron) воҳиди хурдтарини шабакаи нейронӣ аст. Номаш аз нейронҳои мағзи сар гирифта шудааст, вале дар асл он як амали оддии риёзӣ мебошад.
Нейрон чанд адад (вурудҳо) мегирад ва як адад (баромад) медиҳад:
- Ҳар вуруд (x_i) ба вазн (Weight) (w_i) зарб карда мешавад.
- Ҳосилҳо ҷамъ карда мешаванд ва ба онҳо ғараз (Bias) (b) илова мегардад.
- Натиҷа аз функсияи фаъолсозӣ (Activation Function) (f) мегузарад.
[
y = f\left(\sum_{i=1}^{n} w_i x_i + b\right) = f(\mathbf{w} \cdot \mathbf{x} + b)
]
Мисоли ҳаётӣ
Фарз кунед, нейрон бояд қарор диҳад, ки оё имрӯз ба сайругашт рафтан арзад:
| Вуруд | Қимат | Вазн | Маъно |
|---|---|---|---|
| (x_1) — ҳаво офтобӣ аст | 1 | 2.0 | Хеле муҳим |
| (x_2) — вақти холӣ ҳаст | 1 | 1.5 | Муҳим |
| (x_3) — борон меборад | 0 | −3.0 | Таъсири манфии калон |
Ҳисоб: (2.0 \cdot 1 + 1.5 \cdot 1 + (-3.0) \cdot 0 + b). Агар (b = -1) бошад, натиҷа (2.5) мешавад, ки мусбат аст — «биравем».
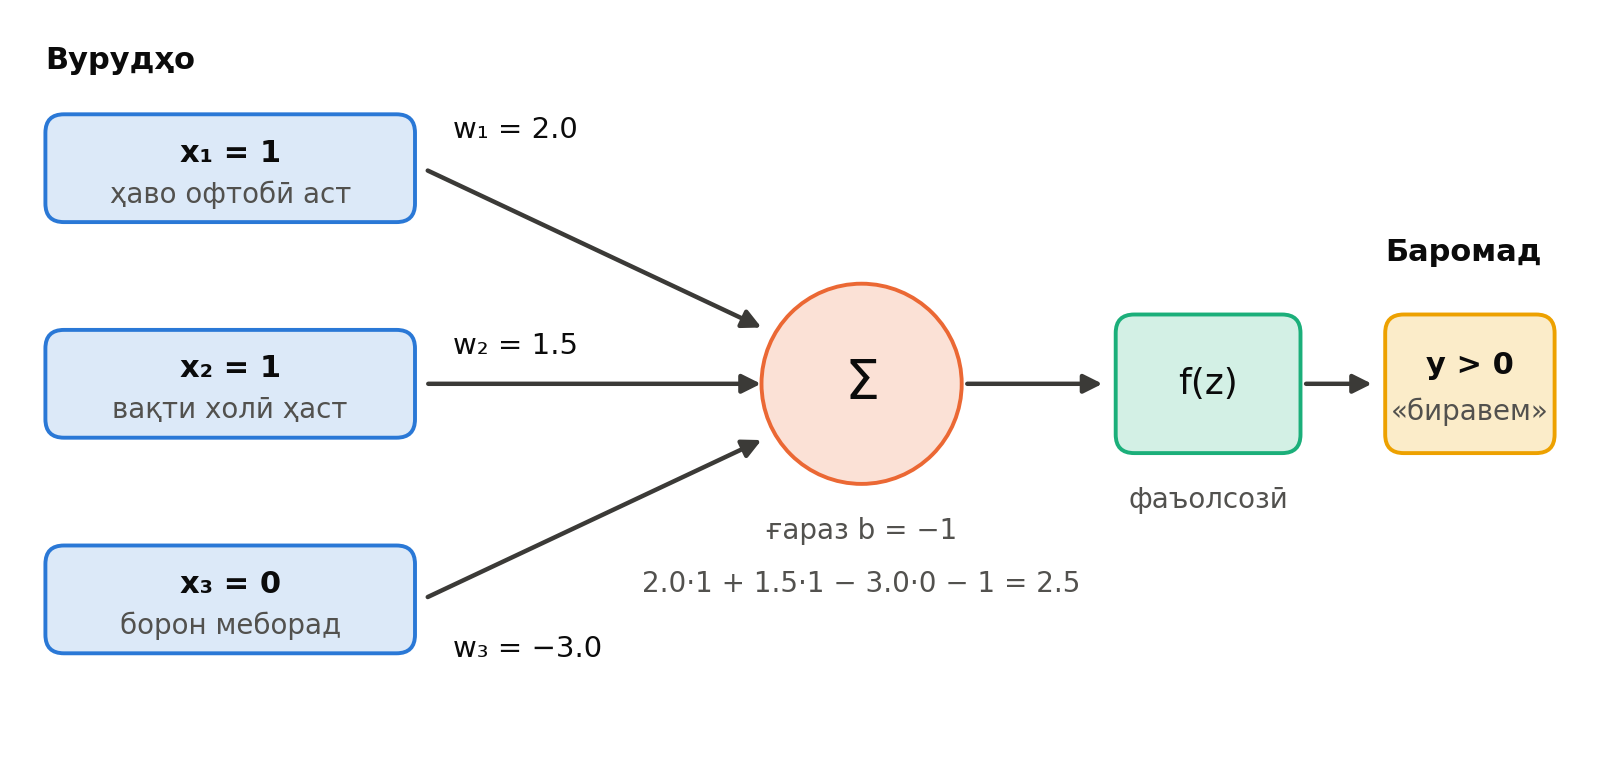
Расми 3.1. Нейрони сунъӣ дар мисоли «оё ба сайругашт равем?»: ҳар вуруд ба вазни худ зарб мешавад, ҳосилҳо бо ғараз ҷамъ мешаванд ва натиҷа аз функсияи фаъолсозӣ мегузарад.
Аҳамияти асосӣ дар он аст, ки вазнҳоро мо дастӣ намегузорем. Шабака онҳоро худаш аз мисолҳо ёд мегирад.
Функсияҳои фаъолсозӣ
Агар функсияи фаъолсозӣ набошад, ҳар қадар қабат илова кунем ҳам, шабака танҳо як функсияи хаттӣ (Linear Function) боқӣ мемонад. Функсияи фаъолсозӣ ба шабака ғайрихаттӣ (Non-linearity) илова мекунад ва ба он имкон медиҳад, ки вобастагиҳои мураккабро тасвир кунад.
| Функсия | Формула | Диапазони қимат | Истифода |
|---|---|---|---|
| Сигмоид (Sigmoid) | (\sigma(z) = \frac{1}{1 + e^{-z}}) | ((0, 1)) | Дарвозаҳои LSTM, эҳтимоли «ҳа/не» |
| Тангенси гиперболӣ (tanh) | (\tanh(z)) | ((-1, 1)) | Ҳолати ниҳонии RNN |
| ReLU | (\max(0, z)) | ([0, \infty)) | Шабакаҳои амиқи муосир |
| GELU, SwiGLU | Вариантҳои ҳамвори ReLU | — | Қабатҳои трансформер |
| Softmax | (\frac{e^{z_i}}{\sum_j e^{z_j}}) | ((0, 1)), ҷамъ = 1 | Тақсимоти эҳтимолият байни токенҳо |
Функсияи Softmax барои моделҳои забонӣ махсусан муҳим аст: дар қабати охир он баҳоҳои хоми модел (логитҳо) -ро ба эҳтимоли ҳар токени луғат табдил медиҳад (ниг. боби 9).
Аз нейрон ба шабака: қабатҳо
Як нейрон қобилияти кам дорад. Қувваи асосӣ вақте пайдо мешавад, ки нейронҳо ба қабатҳо (Layers) муттаҳид мешаванд:
- Қабати вурудӣ (Input Layer) — маълумоти аввалия, масалан, вектори калима.
- Қабатҳои ниҳонӣ (Hidden Layers) — қабатҳои мобайнӣ, ки хусусиятҳои муфидро ҷудо мекунанд.
- Қабати баромадӣ (Output Layer) — натиҷаи ниҳоӣ, масалан, эҳтимоли синфҳо.
Шабакае, ки дар он ҳар нейрони як қабат ба ҳамаи нейронҳои қабати навбатӣ пайваст аст, шабакаи пешрав (Feed-Forward Network) ё персептрони бисёрқабата (MLP — Multi-Layer Perceptron) ном дорад. Ин ҳамон шабакаест, ки баъдтар дар дохили ҳар блоки трансформер вомехӯрем.
Калимаи «амиқ» дар ибораи «омӯзиши амиқ» маҳз ба шумораи зиёди қабатҳо ишора мекунад. Ҳар қабат намояндагии маълумотро каме абстрактитар мекунад.
Дар PyTorch шабакаи хурд чунин навишта мешавад:
import torch
import torch.nn as nn

# Шабака: 300 вуруд (вектори калима) → 128 нейрони ниҳонӣ → 3 синф
model = nn.Sequential(
    nn.Linear(300, 128),  # қабати пурра пайвастшуда: W·x + b
    nn.ReLU(),            # функсияи фаъолсозӣ
    nn.Linear(128, 3),    # қабати баромадӣ: 3 синф (мусбат, манфӣ, бетараф)
)

x = torch.randn(1, 300)   # як вектори тасодуфӣ
logits = model(x)
probs = torch.softmax(logits, dim=-1)
print(probs)  # масалан: tensor([[0.31, 0.42, 0.27]])
Шабака чӣ гуна меомӯзад?
Дар аввал вазнҳои шабака тасодуфӣ мебошанд ва ҷавобҳояш бемаъноянд. Омӯзиш (Training) — ин раванди тадриҷан тағйир додани вазнҳост, то ҷавобҳо беҳтар шаванд. Ин раванд се ҷузъи асосӣ дорад.
1. Функсияи хато (Loss Function)
Аввал бояд чен кунем, ки модел чӣ қадар хато мекунад. Функсияи хато ба мо як адад медиҳад: ҳар қадар хурдтар — ҳамон қадар беҳтар.
Барои масъалаҳои гурӯҳбандӣ ва моделҳои забонӣ одатан энтропияи салибӣ (Cross-Entropy) истифода мешавад:
[
\mathcal{L} = -\log P_\theta(y_{\text{дуруст}})
]
Агар модел ба ҷавоби дуруст эҳтимоли баланд (масалан, 0.9) диҳад, хато хурд аст ((-\log 0.9 \approx 0.1)). Агар эҳтимоли паст (0.01) диҳад, хато калон мешавад ((-\log 0.01 \approx 4.6)).
Дар моделҳои забонӣ «ҷавоби дуруст» токени навбатии воқеӣ дар матн аст. Ҳамин тавр, тамоми омӯзиши пешакии LLM (боби 6) дар асл кам кардани ҳамин хато барои триллионҳо токен мебошад.
2. Фуромади градиентӣ (Gradient Descent)
Тасаввур кунед, ки шумо дар кӯҳ ҳастед, ҳаво туман аст ва бояд ба водӣ фуроед. Шумо роҳро намебинед, вале зери пойҳоятон нишебиро ҳис мекунед. Оқилона аст, ки ҳар дафъа як қадам ба самти нишебтарин гузоред.
Градиент (Gradient) ҳамин «нишебӣ» аст: он нишон медиҳад, ки агар ҳар вазнро каме тағйир диҳем, хато чӣ қадар ва ба кадом самт тағйир меёбад. Мо вазнҳоро ба самти муқобили градиент тағйир медиҳем:
[
w \leftarrow w - \eta \cdot \frac{\partial \mathcal{L}}{\partial w}
]
Ин ҷо (\eta) — суръати омӯзиш (Learning Rate), яъне андозаи қадам аст:
- агар хеле калон бошад, модел аз водӣ «мепарад» ва ноустувор мешавад;
- агар хеле хурд бошад, омӯзиш бениҳоят суст мегузарад.
Дар амал градиентро на барои ҳамаи маълумот, балки барои гурӯҳҳои хурд — бастаҳо (Mini-batches) ҳисоб мекунанд. Ин усулро фуромади градиентии стохастикӣ (SGD) меноманд. Дар моделҳои муосир одатан варианти такмилёфтаи он — Adam ё AdamW истифода мешавад. Як гузариши пурра аз тамоми маълумот давра (Epoch) ном дорад.
3. Паҳншавии баръакси хато (Backpropagation)
Дар шабакае, ки миллионҳо ё миллиардҳо вазн дорад, чӣ гуна бифаҳмем, ки ҳар вазн ба хато чӣ қадар таъсир расонидааст?
Ҷавоб — алгоритми паҳншавии баръакси хато (Backpropagation). Ғояи он чунин аст:
- Гузариши мустақим (Forward Pass): маълумот аз қабати аввал то охир мегузарад ва хато ҳисоб мешавад.
- Гузариши баръакс (Backward Pass): хато аз қабати охир ба қабати аввал «баргардонида» мешавад. Бо истифода аз қоидаи занҷирӣ (Chain Rule)-и ҳосилагирӣ барои ҳар вазн градиент ҳисоб карда мешавад.
- Навсозӣ: ҳамаи вазнҳо бо фуромади градиентӣ тағйир дода мешаванд.
Ташбеҳ: дар як корхона маҳсулоти нуқсондор баромад. Мудир аз охири хатти истеҳсолот оғоз карда, қадам ба қадам мефаҳмад, ки ҳар шӯъба ба ин нуқсон чӣ қадар саҳм гузоштааст ва ба ҳар шӯъба мувофиқи саҳмаш дастур медиҳад.
Тафсилоти риёзии Backpropagation бо мисоли ададӣ дар Замимаи А (қисми А.9) оварда шудааст. Хушбахтона, китобхонаҳои муосир градиентҳоро худкор ҳисоб мекунанд.
Давраи омӯзиш дар PyTorch
import torch
import torch.nn as nn

model = nn.Sequential(nn.Linear(300, 128), nn.ReLU(), nn.Linear(128, 3))
loss_fn = nn.CrossEntropyLoss()
optimizer = torch.optim.AdamW(model.parameters(), lr=1e-3)

# Маълумоти сохта: 64 мисол, ҳар кадом бо нишонаи синф
X = torch.randn(64, 300)
y = torch.randint(0, 3, (64,))

for epoch in range(10):
    logits = model(X)            # 1. гузариши мустақим
    loss = loss_fn(logits, y)    #    ҳисоби хато
    optimizer.zero_grad()
    loss.backward()              # 2. паҳншавии баръакс: ҳисоби градиентҳо
    optimizer.step()             # 3. навсозии вазнҳо
    print(epoch, loss.item())
Ин панҷ сатр — model(X), loss_fn, zero_grad, backward, step — дили омӯзиши ҳамаи шабакаҳои нейронӣ, аз шабакаи хурди боло то моделҳои бузурги забонӣ мебошанд.
Чаро барои матн шабакаи оддӣ кифоя нест?
Шабакаи пешрав вуруди андозаи собит мегирад. Аммо матн чунин хусусиятҳо дорад:
- Дарозии гуногун. Ҷумла метавонад 3 ё 50 калима дошта бошад.
- Тартиб муҳим аст. «Ман туро дӯст медорам» ва «Ту маро дӯст медорӣ» калимаҳои қариб якхела, вале маънои гуногун доранд.
- Вобастагиҳои дур. Дар ҷумлаи «Китоберо, ки дирӯз аз китобхона гирифта будам ва ба дӯстам нишон додам, гум кардам» феъли «гум кардам» ба «китоб», ки дар аввали ҷумла аст, вобаста мебошад.
Барои ин масъалаҳо шабакаҳое лозим буданд, ки матнро пайдарпай — калима ба калима — бихонанд ва чизеро, ки то ин дам хондаанд, дар хотир нигоҳ доранд.
Шабакаҳои нейронии такроршаванда (RNN)
Шабакаи нейронии такроршаванда (Recurrent Neural Network — RNN) матнро мисли инсон аз чап ба рост мехонад. Дар ҳар қадам он ду чизро мегирад:
- вектори калимаи ҷорӣ (x_t);
- ҳолати ниҳонӣ (Hidden State) (h_{t-1}) — «хотира»-и худаш аз қадами пешина.
Ва ҳолати ниҳонии навро ҳисоб мекунад:
[
h_t = \tanh\left(W_{xh} x_t + W_{hh} h_{t-1} + b\right)
]
Нуктаи муҳим: вазнҳои (W_{xh}) ва (W_{hh}) дар ҳамаи қадамҳо якхелаанд. Шабака як «ҳуҷайра»-ро такроран истифода мебарад — аз ҳамин сабаб онро «такроршаванда» меноманд. Бинобар ин RNN метавонад ҷумлаҳои дарозии дилхоҳро коркард кунад.
Кушодани RNN дар вақт
Агар RNN-ро барои ҷумлаи «ман ба мактаб меравам» «кушоем» (Unrolling), чунин занҷир ҳосил мешавад:
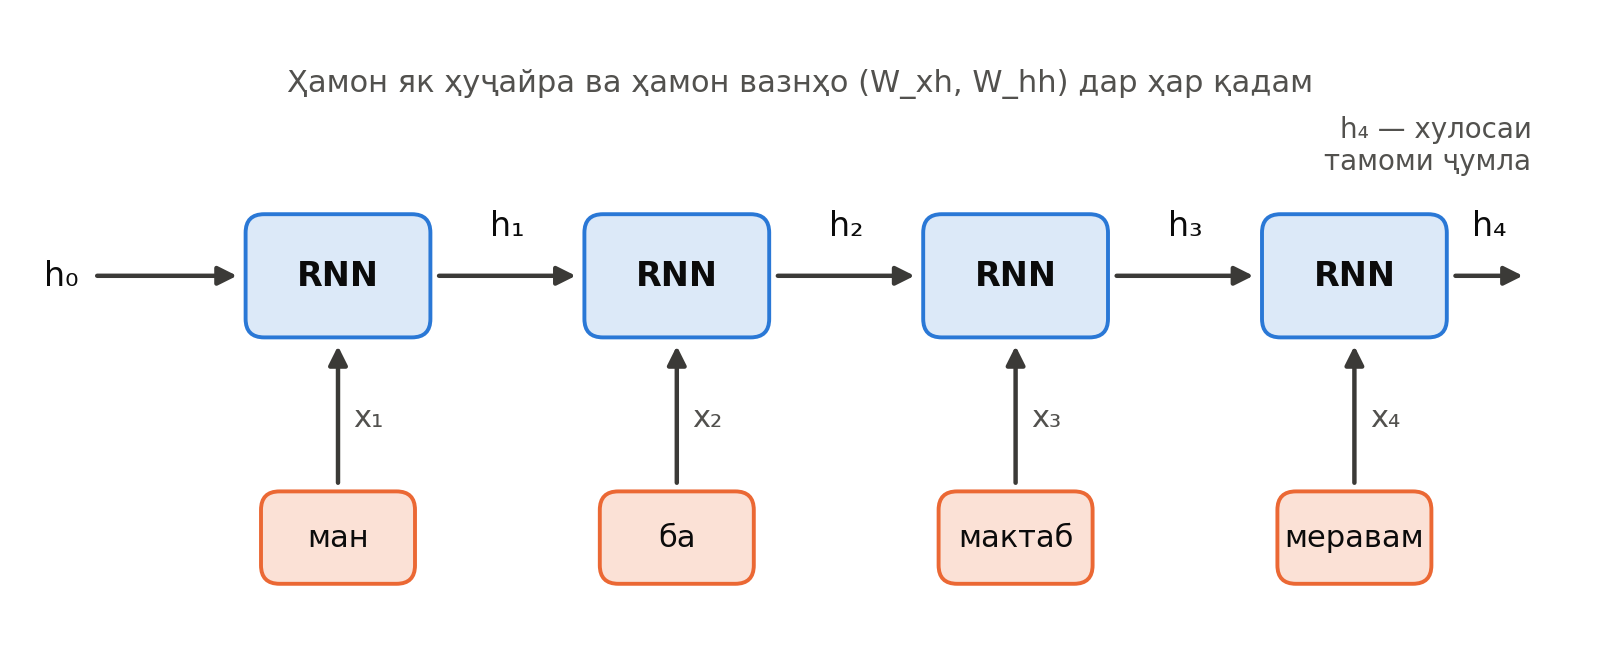
Расми 3.2. RNN-и «кушодашуда» барои ҷумлаи «ман ба мактаб меравам»: дар ҳар қадам ҳамон як ҳуҷайра калимаи навро бо ҳолати ниҳонии пешина якҷоя мекунад.
Ҳолати охирин (h_4) дар назария маълумоти тамоми ҷумларо дар бар мегирад.
Навъҳои масъалаҳо бо RNN
| Навъ | Вуруд → баромад | Мисол |
|---|---|---|
| Як ба чанд (One-to-Many) | Як вуруд → пайдарпайӣ | Тавсифи тасвир бо матн |
| Чанд ба як (Many-to-One) | Пайдарпайӣ → як натиҷа | Муайян кардани оҳанги шарҳ (мусбат/манфӣ) |
| Чанд ба чанд, ҳамзамон | Ҳар калима → як нишона | Муайян кардани ҳиссаҳои нутқ |
| Чанд ба чанд, бо таъхир | Пайдарпайӣ → пайдарпайии дигар | Тарҷумаи мошинӣ (Seq2Seq) |
RNN ҳамчун модели забонӣ
RNN метавонад калимаи навбатиро пешгӯӣ кунад: аз ҳар ҳолати ниҳонӣ (h_t) бо қабати хаттӣ ва Softmax тақсимоти эҳтимолият барои калимаи (t+1) ҳисоб мешавад. Баръакси n-граммаҳо, RNN дар назария тамоми таърихи матнро мебинад, на танҳо 2–3 калимаи охиринро. Дар солҳои 2010-ум моделҳои забонии RNN ва LSTM беҳтарин натиҷаҳоро нишон медоданд.
import torch
import torch.nn as nn

vocab_size, emb_dim, hidden_dim = 10_000, 128, 256

embedding = nn.Embedding(vocab_size, emb_dim)
rnn = nn.RNN(emb_dim, hidden_dim, batch_first=True)
head = nn.Linear(hidden_dim, vocab_size)   # пешгӯии токени навбатӣ

tokens = torch.tensor([[12, 845, 3071, 99]])  # «ман ба мактаб меравам»
h_all, h_last = rnn(embedding(tokens))        # h_all: ҳолатҳои ҳамаи қадамҳо
logits = head(h_all)                           # [1, 4, vocab_size]
Мушкили нестшавии градиент
Дар назария RNN тамоми матнро дар хотир дорад. Дар амал вай калимаҳои дурро зуд «фаромӯш» мекунад. Сабаб дар омӯзиш аст.
Ҳангоми паҳншавии баръакси хато дар RNN (онро Backpropagation Through Time меноманд) градиент аз охири ҷумла ба аввал қадам ба қадам мегузарад ва дар ҳар қадам ба ҳамон матритсаи (W_{hh}) ва ҳосилаи (\tanh) зарб мешавад. Тасаввур кунед, ки ададеро 50 маротиба ба 0.9 зарб мекунем:
[
0.9^{50} \approx 0.005
]
Ва агар ба 1.1 зарб кунем:
[
1.1^{50} \approx 117
]
Аз ин ду мушкил пайдо мешавад:
- Нестшавии градиент (Vanishing Gradient): градиент то ба калимаҳои аввал расидан қариб ба сифр баробар мешавад. Модел наметавонад омӯзад, ки калимаи аввали ҷумла ба калимаи охир таъсир дорад.
- Таркиши градиент (Exploding Gradient): градиент бениҳоят калон мешавад ва омӯзиш вайрон мегардад. Ин мушкилро нисбатан осон бо буридани градиент (Gradient Clipping) ҳал мекунанд — агар градиент аз ҳадди муайян калон бошад, онро хурд мекунанд.
Нестшавии градиент мушкили ҷиддитар аст, зеро он ба модел имкон намедиҳад, ки вобастагиҳои дарозмуддат (Long-range Dependencies)-ро ёд гирад. Дар мисоли «Китоберо, ки дирӯз ... гум кардам», RNN-и оддӣ то ба феъл расидан «китоб»-ро қариб фаромӯш мекунад.
LSTM ва GRU: хотираи дарозмуддат
LSTM
Соли 1997 Зепп Хохрайтер (Sepp Hochreiter) ва Юрген Шмидхубер (Jürgen Schmidhuber) меъмории LSTM (Long Short-Term Memory) — «хотираи кӯтоҳмуддати дароз»-ро пешниҳод карданд.
Ғояи асосӣ: ба ғайр аз ҳолати ниҳонӣ (h_t), LSTM ҳолати ҳуҷайра (Cell State) (c_t)-ро низ дорад. Онро ба тасмаи конвейер монанд кардан мумкин аст, ки маълумот аз он бо тағйироти кам мегузарад. Ба ҷои зарби такрорӣ, маълумот ба ин тасма асосан илова мешавад — ва маҳз ҳамин ба градиент имкон медиҳад, ки бе нестшавӣ ба қадамҳои дур бирасад.
Ҷараёни маълумотро се дарвоза (Gate) идора мекунад. Ҳар дарвоза як сигмоид аст, ки қимати 0 («пӯшида») то 1 («кушода») медиҳад:
| Дарвоза | Номи англисӣ | Савол | Мисол |
|---|---|---|---|
| Дарвозаи фаромӯшкунӣ | Forget Gate | Аз хотираи кӯҳна чиро нест кунам? | Мавзӯи нави ҷумла оғоз шуд — мавзӯи кӯҳнаро фаромӯш кун |
| Дарвозаи вурудӣ | Input Gate | Аз маълумоти нав чиро ба хотира илова кунам? | Мубтадои нав — «китоб» — ро нигоҳ дор |
| Дарвозаи баромадӣ | Output Gate | Аз хотира ҳозир чиро истифода барам? | Ҳангоми расидан ба феъл маълумот дар бораи мубтадоро бигир |
Ба таври содашуда:
[
c_t = f_t \odot c_{t-1} + i_t \odot \tilde{c}_t, \qquad h_t = o_t \odot \tanh(c_t)
]
Ин ҷо (f_t, i_t, o_t) — дарвозаҳо, (\tilde{c}_t) — маълумоти нави номзад ва (\odot) — зарби элемент ба элемент.
GRU
Соли 2014 GRU (Gated Recurrent Unit) пешниҳод шуд. Он варианти соддатари LSTM аст: ҳолати ҳуҷайра ва ҳолати ниҳониро якҷоя мекунад ва ба ҷои се дарвоза ду дарвоза дорад — дарвозаи навсозӣ (Update Gate) ва дарвозаи бозгашт (Reset Gate). GRU параметрҳои камтар дорад ва дар бисёр масъалаҳо натиҷаи ба LSTM наздик медиҳад.
Муқоиса
| Хусусият | RNN-и оддӣ | LSTM | GRU |
|---|---|---|---|
| Хотираи дарозмуддат | Суст | Хуб | Хуб |
| Шумораи дарвозаҳо | 0 | 3 | 2 |
| Шумораи параметрҳо | Кам | Бештар | Мобайнӣ |
| Суръати омӯзиш | Тез | Сусттар | Мобайнӣ |
Дар PyTorch иваз кардани RNN ба LSTM танҳо як сатр аст:
lstm = nn.LSTM(emb_dim, hidden_dim, num_layers=2, batch_first=True)
h_all, (h_last, c_last) = lstm(embedding(tokens))  # LSTM ҳолати ҳуҷайраро низ бармегардонад
LSTM то солҳои 2017–2018 асоси аксари системаҳои NLP буд: тарҷумаи мошинӣ, шинохти овоз, клавиатураҳои пешгӯикунанда ва ғайра.
Моделҳои пайдарпайӣ ба пайдарпайӣ (Seq2Seq)
Азбаски моделҳои трансформерӣ дар аввал маҳз барои ҳалли масъалаҳои пайдарпайӣ ба пайдарпайӣ (Sequence-to-Sequence — Seq2Seq) пешниҳод шуда буданд, беҳтар аст бо ин навъи масъалаҳо хуб шинос шавем.
Дар масъалаҳои Seq2Seq ҳам вуруд ва ҳам баромад пайдарпайӣ мебошанд ва дарозии онҳо метавонад гуногун бошад:
- тарҷумаи мошинӣ: «Ман донишҷӯ ҳастам» → «I am a student»;
- ихтисори матн: мақолаи дароз → хулосаи кӯтоҳ;
- ҷавоб ба савол, табдили нутқ ба матн ва ғайра.
Ин масъалаҳо ба навъи «чанд вуруд ба чанд баромад» (Many-to-Many) тааллуқ доранд. Шабака аввал тамоми пайдарпайии вурудиро коркард мекунад ва сипас пайдарпайии баромадиро месозад.
Сохтори рамзгузор–рамзкушо (Encoder–Decoder)
Барои ин кор одатан аз шабакаҳои рамзгузор–рамзкушо (Encoder–Decoder) истифода мешавад. Соли 2014 ду гурӯҳи муҳаққиқон (Sutskever ва ҳамкорон дар Google, Cho ва ҳамкорон) чунин моделҳоро бо RNN/LSTM пешниҳод карданд:
- Рамзгузор (Encoder) — як RNN (одатан LSTM ё GRU), ки тамоми ҷумлаи вурудиро калима ба калима мехонад. Ҳолати ниҳонии охирини он маълумоти ҷумларо дар як вектори бисёрченака нигоҳ медорад. Ин векторро вектори контекст (Context Vector) меноманд.
- Рамзкушо (Decoder) — RNN-и дигар, ки ин векторро ҳамчун ҳолати ибтидоӣ қабул мекунад ва дар асоси он пайдарпайии баромадиро калима ба калима месозад. Ҳар калимаи тавлидшуда ба қадами навбатӣ ҳамчун вуруд дода мешавад, то токени махсуси анҷом (``) тавлид шавад.
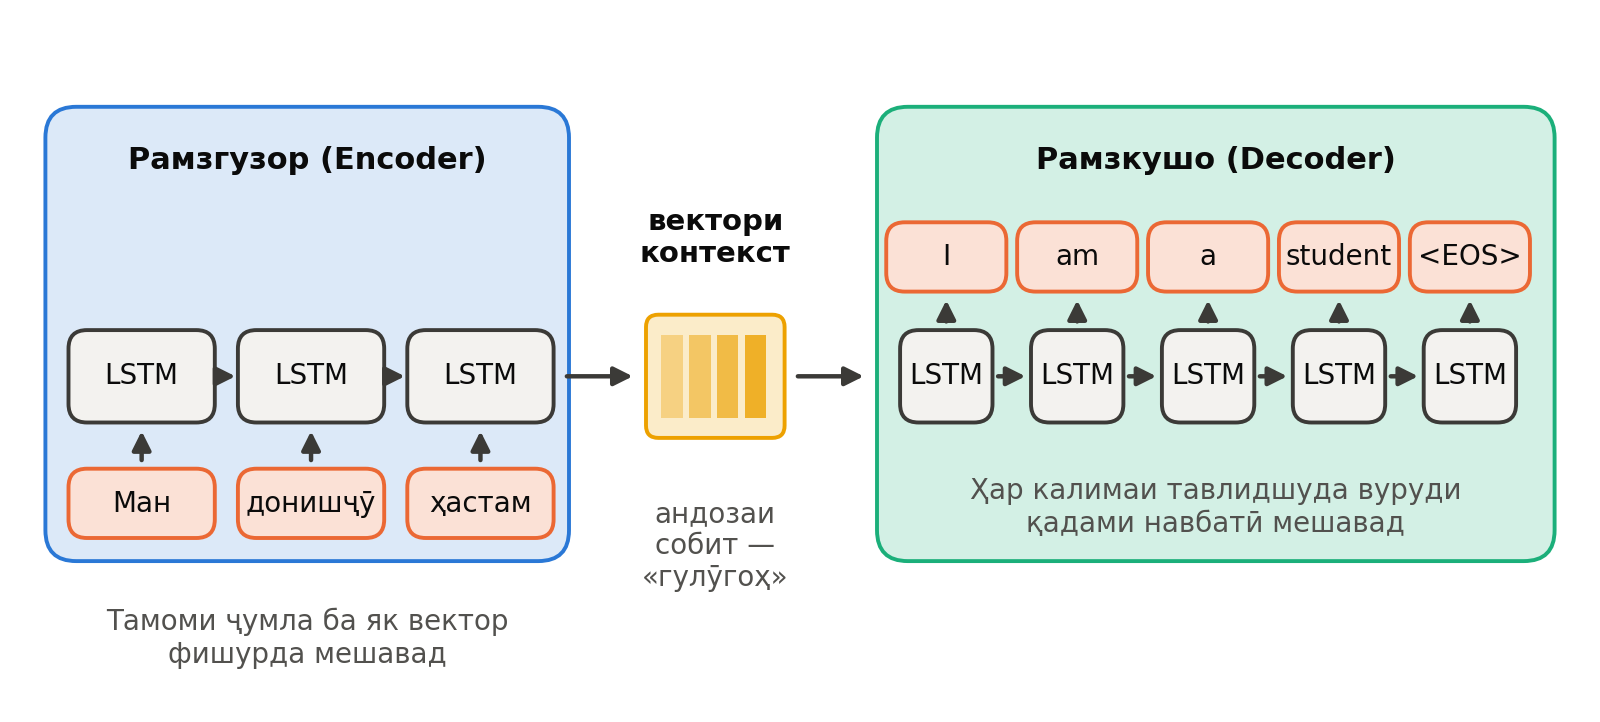
Расми 3.3. Модели Seq2Seq: рамзгузор ҷумлаи «Ман донишҷӯ ҳастам»-ро ба як вектори контексти андозаи собит фишурда мекунад ва рамзкушо аз он тарҷумаро калима ба калима то `` месозад.
Омӯзиш бо «маҷбурсозии омӯзгор» (Teacher Forcing)
Ҳангоми омӯзиш ба рамзкушо дар ҳар қадам на калимаи тавлидкардаи худаш, балки калимаи дурусти тарҷума дода мешавад. Ин усулро маҷбурсозии омӯзгор (Teacher Forcing) меноманд. Он омӯзишро тезтар ва устувортар мекунад. Ҳангоми истифода (Inference) бошад, модел бояд ба калимаҳои худаш такя кунад.
Скелети Seq2Seq дар PyTorch
class Encoder(nn.Module):
    def __init__(self, vocab, emb, hid):
        super().__init__()
        self.emb = nn.Embedding(vocab, emb)
        self.lstm = nn.LSTM(emb, hid, batch_first=True)

    def forward(self, src):
        _, (h, c) = self.lstm(self.emb(src))
        return h, c                     # вектори контекст

class Decoder(nn.Module):
    def __init__(self, vocab, emb, hid):
        super().__init__()
        self.emb = nn.Embedding(vocab, emb)
        self.lstm = nn.LSTM(emb, hid, batch_first=True)
        self.out = nn.Linear(hid, vocab)

    def forward(self, tgt_in, h, c):
        y, _ = self.lstm(self.emb(tgt_in), (h, c))
        return self.out(y)              # логитҳо барои ҳар калимаи баромад
Мушкили «гулӯгоҳ»: чаро ба таваҷҷуҳ ниёз доштем
Моделҳои Seq2Seq дар тарҷумаи ҷумлаҳои кӯтоҳ натиҷаи қобили қабул медиҳанд. Аммо азбаски вектори контекст андозаи собит дорад, ҳангоми тарҷумаи ҷумлаҳои дарозтар ба мушкил рӯ ба рӯ мешаванд.
Тасаввур кунед, ки бояд мазмуни як ҷумлаи панҷ-калимагӣ ва як абзаси панҷоҳ-калимагиро дар як «қуттӣ»-и якандоза ҷой диҳед. Барои абзаси дароз ҷой намерасад ва қисми маълумот ногузир гум мешавад. Ин мушкилро гулӯгоҳи иттилоотӣ (Information Bottleneck) меноманд. Дар таҷрибаҳо сифати тарҷума бо дароз шудани ҷумла ба таври намоён паст мешуд.
Мушкили дигар ин аст, ки роҳе, ки маълумот барои тарҷумаи як калима тай мекунад, хеле дароз аст. Барои он ки калимаи аввали ҷумлаи аслӣ ба калимаи аввали тарҷума таъсир расонад, маълумот бояд аз тамоми занҷири рамзгузор ва баъд аз рамзкушо гузарад — ва дар ин роҳ, тавре дидем, градиент суст мешавад.
Ва мушкили сеюм — суръат. RNN матнро қатъиян пайдарпай коркард мекунад: то (h_{t-1}) ҳисоб нашавад, (h_t)-ро ҳисоб кардан ғайриимкон аст. Протсессорҳои графикӣ (GPU) барои ҳисобҳои мувозӣ сохта шудаанд, вале RNN наметавонад аз ин имконият пурра истифода барад.
| Мушкил | Сабаб | Оқибат |
|---|---|---|
| Гулӯгоҳи иттилоотӣ | Як вектори андозаи собит барои тамоми ҷумла | Сифати паст дар ҷумлаҳои дароз |
| Роҳи дароз байни калимаҳо | Маълумот аз ҳар қадам мегузарад | Вобастагиҳои дур суст ёд гирифта мешаванд |
| Коркарди пайдарпай | (h_t) ба (h_{t-1}) вобаста аст | Омӯзиш суст, GPU пурра истифода намешавад |
Ғояи ҳал: ба ҳамаи калимаҳо нигоҳ кун
Барои ҳалли ин мушкил, муҳаққиқон кӯшиш карданд роҳе пайдо кунанд, ки ҳангоми сохтани ҳар калимаи баромадӣ дар ҳар қадам, ғайр аз маънои умумии ҷумла, қисмҳои мушаххаси пайдарпайии вурудӣ низ ба назар гирифта шаванд.
Одамон низ ҳангоми тарҷума аз як забон ба забони дигар раванди монандеро тай мекунанд: аввал тамоми ҷумларо мехонанд ва маънои умумии онро мефаҳманд, сипас ҳангоми навиштани ҳар калимаи тарҷума ба калимаҳои мувофиқи забони аслӣ бозмегарданд ва онҳоро ба забони мақсад тарҷума мекунанд.
Пас, ба ҷои як вектори контекст, рамзкушо метавонад ба ҳамаи ҳолатҳои ниҳонии рамзгузор ((h_1, h_2, \dots, h_n)) дастрасӣ дошта бошад ва дар ҳар қадам худаш интихоб кунад, ки ба кадоме бештар «диққат диҳад».
Натиҷаи ин кӯшишҳо пайдоиши механизми таваҷҷуҳ (Attention) буд (Bahdanau ва ҳамкорон, соли 2014). Дар аввал таваҷҷуҳ ҳамчун илова ба RNN истифода мешуд. Соли 2017 дар мақолаи «Attention Is All You Need» муҳаққиқони Google нишон доданд, ки аз RNN умуман даст кашидан мумкин аст ва модели тамоман ба таваҷҷуҳ асосёфта — трансформер — сохтанд. Трансформер ҳамаи калимаҳоро ҳамзамон коркард мекунад ва роҳи байни ду калимаи дилхоҳ ҳамагӣ як қадам аст.
Маҳз ҳамин мавзӯи боби 4 мебошад.
Хулоса
- Усулҳои оморӣ (халтаи калимаҳо, n-граммаҳо, TF-IDF) содаанд ва то ҳол дар ҷустуҷӯ муфиданд, вале тартиби калимаҳо, маъно ва контексти дарозро намефаҳманд.
- Нейрон ҷамъи вазндори вурудҳоро ҳисоб карда, онро аз функсияи фаъолсозӣ мегузаронад. Функсияи фаъолсозӣ ба шабака ғайрихаттӣ медиҳад.
- Шабака бо се ҷузъ меомӯзад: функсияи хато (масалан, энтропияи салибӣ), паҳншавии баръакси хато барои ҳисоби градиентҳо ва фуромади градиентӣ барои навсозии вазнҳо.
- RNN матнро калима ба калима мехонад ва «хотира»-ро дар ҳолати ниҳонӣ нигоҳ медорад.
- Аз сабаби нестшавии градиент RNN-и оддӣ вобастагиҳои дурро суст ёд мегирад. LSTM ва GRU бо ёрии дарвозаҳо ва ҳолати ҳуҷайра ин мушкилро сабук мекунанд.
- Моделҳои Seq2Seq аз рамзгузор ва рамзкушо иборатанд ва тамоми ҷумларо ба як вектори контекст фишурда мекунанд.
- Вектори андозаи собит «гулӯгоҳ» мешавад, роҳи маълумот дароз аст ва коркарди пайдарпай суст мебошад. Ин мушкилот ба пайдоиши механизми таваҷҷуҳ ва баъдтар трансформер оварданд.
Саволҳо барои санҷиши худ
- Чаро «халтаи калимаҳо» ҷумлаҳои «Саг гурбаро газид» ва «Гурба сагро газид»-ро фарқ карда наметавонад?
- Агар аз шабака ҳамаи функсияҳои фаъолсозиро хориҷ кунем, чӣ мешавад?
- Нақши суръати омӯзиш (Learning Rate) чист? Агар он хеле калон ё хеле хурд бошад, чӣ рух медиҳад?
- Паҳншавии баръакси хато ба кадом савол ҷавоб медиҳад?
- Чаро RNN-ро «такроршаванда» меноманд? Кадом вазнҳо дар ҳамаи қадамҳо якхелаанд?
- Нестшавии градиент чист ва чаро он ба RNN имкон намедиҳад, ки вобастагиҳои дурро ёд гирад?
- Се дарвозаи LSTM кадомҳоянд ва ҳар кадом чӣ вазифа дорад?
- Вектори контекст дар модели Seq2Seq чист ва чаро он ба «гулӯгоҳ» табдил меёбад?
- Се сабаби асосии гузариш аз RNN ба трансформерро номбар кунед.
 Барномасозӣ
 Олами Афсонаҳо
 Ахбор
 Дунё