Омӯзиши моделҳои бузурги забонӣ (LLM)
Китоби омӯзишӣ дар бораи моделҳои бузурги забонӣ (LLM) ба забони тоҷикӣ: аз мафҳумҳои аввалия то усулҳои муосир. Токенсозӣ ва векторҳо, шабакаҳои нейронӣ, механизми таваҷҷуҳ ва Transformer, оилаҳои моделҳо, омӯзиши пешакӣ, танзими дақиқ ва LoRA, мутобиқсозӣ (RLHF, DPO), тавлиди матн, муҳандисии промпт, RAG, агентҳо, самаранокӣ, арзёбӣ ва бехатарӣ, тафсирпазирӣ ва истифодаи LLM барои забони тоҷикӣ. Бо мисолҳои код дар Python ва PyTorch, замимаҳои математика ва луғати истилоҳот.
Агенти Зеҳнӣ · 13 октябри 2026 · 18 саҳифа · 2 писанд
Боби 4. Механизми таваҷҷуҳ ва меъмории Transformer
Механизми таваҷҷуҳ (Attention) ва меъмории Transformer, ки бар он сохта шудааст, пояи қариб ҳамаи моделҳои бузурги забонии муосир мебошанд. Дар боби 3 дидем, ки шабакаҳои бозгаштӣ (RNN) ва моделҳои пайдарпайӣ ба пайдарпайӣ (Seq2Seq) матнро чӣ гуна коркард мекунанд ва дар куҷо ба маҳдудият дучор мешаванд. Ин боб аз ҳамон маҳдудият оғоз карда, қадам ба қадам аз тасаввури умумӣ то барномарезии худи механизм ва тамоми меъмории Transformer мерасад.
Дар ин боб меомӯзем:
- чаро ба механизми таваҷҷуҳ ниёз пайдо шуд ва он кадом мушкили моделҳои Seq2Seq-ро ҳал мекунад;
- таваҷҷуҳ дар сатҳи тасаввурӣ чӣ кор мекунад ва «сарҳои таваҷҷуҳ» чӣ маъно доранд;
- векторҳои дархост, калид ва арзиш (Query, Key, Value), холҳои таваҷҷуҳ, softmax ва ҷамъи вазндор;
- навъҳои асосии таваҷҷуҳ: таваҷҷуҳи Баҳданау, худтаваҷҷуҳӣ, таваҷҷуҳи зарби скалярӣ ва миқёсбандишуда, таваҷҷуҳи чандсарӣ;
- барномарезии худтаваҷҷуҳӣ бо PyTorch: нусхаи сода, вазнҳои омӯзишпазир, ниқоби сабабӣ, dropout ва таваҷҷуҳи чандсарӣ;
- блоки Transformer: шабакаи пешрав бо GELU, меъёрсозии қабатӣ ва пайвастҳои боқимонда;
- меъмории пурраи Transformer: рамзгузор, рамзкушо, рамзгузории мавқеӣ, ниқобҳо ва қабати ниҳоӣ;
- меъмории GPT-2 ва GPT-3, инчунин фарқи байни меъморӣ, нуқтаи назоратӣ ва модел.
Чаро ба таваҷҷуҳ ниёз дорем
Мушкили пайдарпайиҳои дароз
Фарз кунем, ки мехоҳем модели тарҷумаи мошинӣ созем. Аз сабаби фарқияти сохтори грамматикии забони манбаъ ва забони мақсад матнро наметавон танҳо калима ба калима тарҷума кард: тартиби калимаҳо дигар мешавад ва барои тарҷумаи як калима гоҳо маълумоте лозим мешавад, ки дар охири ҷумла омадааст.
Дар боби 3 дидем, ки то соли 2017 барои ин масъала одатан моделҳои рамзгузор–рамзкушо (Seq2Seq) бо шабакаҳои бозгаштӣ (LSTM ё GRU) истифода мешуданд. Рамзгузор (Encoder) тамоми ҷумлаи вурудиро мехонад ва маънои онро дар ҳолати ниҳонии охирини худ ҷамъ мекунад. Ин ҳолатро вектори контекст (Context vector) меноманд. Рамзкушо (Decoder) тарҷумаро аз рӯи ҳамин вектор калима ба калима месозад.
Дар ҳамон боб маҳдудиятҳои ин равишро низ дидем (қисми «Мушкили гулӯгоҳ»): вектори контекст андозаи собит дорад, бинобар ин дар ҷумлаҳои дароз маълумот гум мешавад, ва роҳи маълумот байни калимаҳои аз ҳам дур хеле дароз аст. Ғояи ҳал ҳам дар он ҷо гуфта шуд: рамзкушо бояд, мисли тарҷумони инсон, дар ҳар қадам ба қисми мувофиқи ҷумлаи аслӣ баргардад ва ба он «таваҷҷуҳ» кунад. Механизми таваҷҷуҳ маҳз ҳамин рафторро ба модел медиҳад.
Аз таваҷҷуҳи Баҳданау то Transformer
Таърихи мухтасари ин ғоя чунин аст:
- Соли 2014 Дзмитрий Баҳданау (Dzmitry Bahdanau) ва ҳамкоронаш механизми таваҷҷуҳро барои RNN пешниҳод карданд (мақола соли 2015 дар конфронси ICLR нашр шуд). Ин механизм ба рамзкушо имкон дод, ки дар ҳар қадами рамзкушоӣ ба қисмҳои гуногуни пайдарпайии вурудӣ ба таври интихобӣ дастрасӣ дошта бошад. Дар баробари тарҷума, модел масъалаи мувофиқсозӣ (Alignment)-ро низ ҳал мекард, яъне муайян менамуд, ки кадом қисмҳои вуруд ба ҳар калимаи баромадӣ алоқаманданд.
- Соли 2016 мафҳуми худтаваҷҷуҳӣ (Self-Attention) истифода шуд: таваҷҷуҳ на байни ду пайдарпайӣ, балки дар дохили як пайдарпайӣ.
- Соли 2017 дар мақолаи «Attention Is All You Need» — «Таваҷҷуҳ ҳамаи он чизест, ки ба шумо лозим аст» меъмории Transformer муаррифӣ шуд. Муаллифон нишон доданд, ки барои шабакаҳои амиқи коркарди забон RNN умуман ҳатмӣ нест: воҳидҳои бозгаштӣ пурра хориҷ шуданд ва масъалаҳои пайдарпайӣ ба пайдарпайӣ танҳо бо таваҷҷуҳ ҳал гардиданд.
Азбаски Transformer унсурҳои пайдарпайиро на якто-якто, балки ҳамзамон (параллелӣ) коркард мекунад, он аз ҳисоббарории мувозии протсессорҳои графикӣ (GPU) пурра истифода мебарад ва метавонад матнҳои дарозро самаранок коркард кунад. Маҳз ҳамин хусусият омӯзиши моделҳои бузурги забонии имрӯза, аз ҷумла силсилаи GPT, -ро имконпазир сохт.
Тасаввури умумӣ дар бораи таваҷҷуҳ
Таваҷҷуҳ ҳамчун тамаркуз ба қисмҳои муҳим
Ҳадафи механизми таваҷҷуҳ дар омӯзиши амиқ ин аст, ки ба модел барои тамаркуз ба қисмҳои муҳимтару алоқамандтари вуруд ёрӣ расонад. Модел ба қисмҳое, ки барои пешгӯии ҷорӣ муҳиманд, вазни бештар ва ба қисмҳои камтар алоқаманд вазни камтар медиҳад. Ин ба он монанд аст, ки хонандаи бодиққат зери ҷумлаҳои калидии дафтараш хат мекашад.
Дар коркарди забони табиӣ ин маънои онро дорад, ки модел ҳар калимаро алоҳида коркард намекунад, балки робитаи онро бо калимаҳои дигари ҷумла ба назар мегирад. Калима дар алоҳидагӣ маънои муайян дорад, аммо маънои он метавонад аз контекст сахт вобаста бошад. Контекст метавонад аз як ё якчанд калимае иборат бошад, ки пеш ё баъд аз калимаи мавриди таҳлил ҷойгир шудаанд.
Мисоли тарҷума аз англисӣ ба фаронсавиро дида мебароем. Ҷумлаи зерин дода шудааст:
You like this course. — «Ин курс ба шумо маъқул аст».
- Ҳангоми тарҷумаи калимаи
likeмодел бояд ба калимаиYouтаваҷҷуҳ кунад, зеро дар забони фаронсавӣ шакли феъл вобаста ба мубтадо (Subject) тағйир меёбад. Қисми боқимондаи ҷумла барои интихоби шакли ин феъл чандон муҳим нест. - Ҳангоми тарҷумаи калимаи
thisмодел бояд ба калимаиcourseтаваҷҷуҳ кунад, зеро тарҷумаиthisба ҷинси грамматикии исм (мардона ё занона) вобаста аст.
Дар ҷумлаҳои мураккабтар калимаҳои муҳим метавонанд дар қисмҳои дуртари ҷумла ҷойгир бошанд, ва таваҷҷуҳ ба модел имкон медиҳад, ки онҳоро новобаста аз масофа пайдо кунад.
Мисоли дигар — ҷумлаи зерин:
The driver could not drive the car fast enough because it had a problem. — «Ронанда наметавонист мошинро ба қадри кофӣ тез ронад, зеро он мушкил дошт».
Ҷонишини it («он») ба ронанда ишора мекунад ё ба мошин? Барои инсон ҷавоб сода аст, аммо модел инро танҳо бо омӯхтани робитаҳои калимаҳо дар заминаи ҷумла фаҳмида метавонад. Вақте вазнҳои таваҷҷуҳи модели омӯзонидашударо таҳлил мекунанд, мебинанд, ки ҳангоми коркарди калимаи it модел ба калимаи car («мошин») нисбат ба калимаҳои дигар таваҷҷуҳи бештар додааст.
«Нигоҳ кардан» ва «фикр кардан»
Ҳар блоки Transformer ду бахши асосӣ дорад:
- Механизми таваҷҷуҳ робитаи байни токенҳоро коркард мекунад ва маълумоти мувофиқро байни онҳо интиқол медиҳад.
- Шабакаи пешрав (Feed-Forward) маълумоти ҷамъшударо дар ҳар мавқеи матн алоҳида коркард мекунад.
Барои содагӣ баъзан мегӯянд, ки ҳар калима аввал ба атрофаш «нигоҳ мекунад» ва баъд дар бораи маълумоти гирифтааш «фикр мекунад». Аммо ин танҳо ташбеҳ аст: ҳамаи ин амалҳоро шабака тавассути ҳисобҳои риёзӣ иҷро мекунад.
Дархост ва калид дар сатҳи тасаввурӣ
Механизми таваҷҷуҳро метавон ба низоми ҷустуҷӯи робитаи мувофиқ байни калимаҳо монанд кард. Барои ҳар токен векторҳои махсус сохта мешаванд:
- вектори дархост (Query) нишон медиҳад, ки токени ҷорӣ чӣ гуна маълумот меҷӯяд;
- вектори калид (Key) нишон медиҳад, ки токен ба кадом дархостҳо мувофиқ аст;
- вектори арзиш (Value) худи маълумотеро дар бар мегирад, ки интиқол дода мешавад.
Шабака дархостҳоро бо калидҳо муқоиса мекунад ва муайян менамояд, ки маълумоти кадом токенҳо барои токени ҷорӣ муҳимтар аст. Дар ҷумлаи «John wants his bank to cash the …» ин равандро чунин тасаввур кардан мумкин аст:
Дархости his: «Кадом калима шахсеро нишон медиҳад, ки ин ҷонишин ба ӯ бармегардад?»
Калиди John: «Ман номи шахсе ҳастам, ки дар ҳамин ҷумла зикр шудааст».
Шабака мувофиқатро муайян карда, маълумоти вобаста ба Ҷонро ба намояндагии дохилии his интиқол медиҳад.
Сарҳои таваҷҷуҳ
Ҳар қабат метавонад чанд сари таваҷҷуҳ (Attention head) дошта бошад, яъне чанд раванди мустақили коркарди робитаҳо ҳамзамон иҷро мешаванд. Ҳар сарро метавон ҳамчун «саволи» алоҳидае тасаввур кард, ки токен ба матн медиҳад. Масалан:
- як сар метавонад ҷонишинро бо исми мувофиқ пайванд диҳад;
- сари дигар метавонад барои муайян кардани маънои калимаи чандмаъно (масалан, bank — «бонк» ё «соҳили дарё») ёрӣ диҳад;
- сари сеюм метавонад ду қисми як номро, мисли «Билл Гейтс», ба ҳам пайванд диҳад.
Дар амал як вазифа метавонад ба кори якчанд сар ва якчанд қабат такя кунад. Масалан, бузургтарин нусхаи GPT-3 дар ҳар яке аз 96 қабаташ 96 сари таваҷҷуҳ дошт, яъне дар маҷмӯъ 9 216 сар.
Мисоли воқеӣ: «Мэри» ё «Ҷон»?
Соли 2022 муҳаққиқон як пешгӯии GPT-2-ро муфассал таҳлил карданд. Модел ҷумлаи зеринро бо калимаи Mary пур карда буд:
When Mary and John went to the store, John gave a drink to … — «Вақте Мэри ва Ҷон ба мағоза рафтанд, Ҷон нӯшокиеро ба … дод».
Муҳаққиқон се гурӯҳи сарҳои таваҷҷуҳро ёфтанд:
- сарҳое, ки маълумоти «Мэри»-ро ба мавқеи охирини ҷумла интиқол медоданд;
- сарҳое, ки таъсири номи дуюми «Ҷон»-ро маҳдуд мекарданд;
- сарҳое, ки такрор шудани номи «Ҷон»-ро муайян карда, ба гурӯҳҳои дигар ёрӣ медоданд.
Ҳамкории ин гурӯҳҳо эҳтимоли интихоби «Мэри»-ро зиёд мекард. Аммо ин маънои онро надорад, ки дар ҳар ҷумлаи монанд номи шахси аввал ҷавоби дуруст аст. Масалан, дар ҷумлаи «Вақте Мэри ва Ҷон ба тарабхона рафтанд, Ҷон калидҳояшро ба … дод» вобаста ба бофти қисса калимаи навбатӣ метавонад номи шахс ё «пешхизмат» бошад. Барои шарҳи пурраи чунин интихобҳои модел таҳқиқоти бештар лозим аст (нигаред ба боби 15).
Таваҷҷуҳ чӣ гуна кор мекунад
Дархост, калид ва арзиш
Ҳар механизми таваҷҷуҳ аз се ҷузъ иборат аст:
- Дархост (Query, Q) бо калидҳо муқоиса мешавад, то холҳои мувофиқат ба даст оянд;
- Калид (Key, K) барои муайян кардани алоқамандии ҳар қисми иттилоот бо дархост истифода мешавад;
- Арзиш (Value, V) иттилоотеро дар бар мегирад, ки мувофиқи вазнҳои таваҷҷуҳ ҷамъбаст мешавад.
Ин мафҳумҳо аз системаҳои ҷустуҷӯ гирифта шудаанд. Вақте шумо дар YouTube ё сомонаи филмҳо видеоеро меҷӯед, матни дар сатри ҷустуҷӯ навиштаатон дархост аст. Муҳаррики ҷустуҷӯ онро бо унвон, тавсиф ва дигар маълумоти видеоҳо — яъне бо калидҳо — муқоиса мекунад ва видеоҳои аз ҳама мувофиқ, яъне арзишҳоро, бармегардонад. Аз ин ҷиҳат таваҷҷуҳро метавон як навъ раванди ҷустуҷӯ ва дарёфти иттилоот донист. Фарқи асосӣ дар он аст, ки таваҷҷуҳ на як натиҷаи беҳтарин, балки омехтаи вазндори ҳамаи арзишҳоро бармегардонад.
Раванди умумӣ се қадам дорад:
- Холҳои таваҷҷуҳ (Attention scores): дархост бо ҳар калид муқоиса шуда, барои ҳар ҷуфт як адад — дараҷаи мувофиқат — ҳисоб мешавад.
- Вазнҳои таваҷҷуҳ (Attention weights): холҳо бо функсияи softmax ба вазнҳои мусбат табдил дода мешаванд, ки ҷамъашон ба 1 баробар аст.
- Вектори контекст: арзишҳо ба вазнҳои мувофиқ зарб шуда, ҷамъ карда мешаванд.
Таваҷҷуҳи Баҳданау (таваҷҷуҳи ҷамъшаванда)
Механизми аввалин — таваҷҷуҳи ҷамъшаванда (Additive Attention)-и Баҳданау — ин се қадамро дар дохили модели рамзгузор–рамзкушои RNN амалӣ мекунад. Фарз мекунем, ки (x = (x_1, \dots, x_n)) ҷумлаи забони манбаъ бо дарозии (n) ва (y = (y_1, \dots, y_m)) пайдарпайии забони мақсад бо дарозии (m) мебошад. Алгоритм аз панҷ марҳила иборат аст.
1. Рамзгузории калимаҳои вурудӣ (Encoding). Калимаҳо ба векторҳо табдил дода мешаванд. Баҳданау барои ин аз RNN-и дусамта истифода кард, ки ду навъи ҳолати ниҳонӣ дорад: самти пеш (Forward) ва самти қафо (Backward). Ин ду ҳолат ба ҳам пайваст шуда, ҳолати рамзгузорро барои ҳар калима ташкил медиҳанд:
[
h_i = \left[\overrightarrow{h}_i;\ \overleftarrow{h}_i\right]
]
Бо ин роҳ, вектори (h_i) ҳам иттилооти калимаҳои пеш аз калимаи (i)-ум ва ҳам иттилооти калимаҳои пас аз онро дар бар мегирад. Дар модели маъмулии рамзгузор–рамзкушо, ки таваҷҷуҳ надорад, бошад, танҳо ҳолати охирини ниҳонии рамзгузор барои муаррифии тамоми ҷумла истифода мешавад.
2. Муайян кардани калимаҳои алоқаманд (Alignment). Ҳангоми тавлиди ҳар калимаи баромадӣ аввал бояд муайян кунем, ки кадом калимаҳои вурудӣ муҳимтаранд. Барои ин функсияи холдиҳии (a) ба ҳар калимаи вурудӣ бо назардошти ҳолати қаблии рамзкушо хол медиҳад:
[
e_{t,i} = a(s_{t-1}, h_i)
]
Дар ин ҷо (t) — қадами вақт ҳангоми тавлиди баромад, (s_{t-1}) — ҳолати ниҳонии рамзкушо пас аз қадами қаблӣ ва (e_{t,i}) — холи калимаи вурудии (i)-ум дар қадами (t) мебошад. Дар кори Баҳданау функсияи (a) як шабакаи нейронии содаи пешрав буд, ки ҳамзамон бо рамзгузор ва рамзкушо омӯзонида мешуд:
[
a(s_{t-1}, h_i) = v_a^{\top} \tanh\left(W_a s_{t-1} + U_a h_i\right)
]
Ин қисмро модели мувофиқсозӣ (Alignment model) меноманд. Дар солҳои баъдӣ усулҳои содатари муайян кардани алоқамандӣ низ пешниҳод шуданд, аз ҷумла шабоҳати косинусӣ ва зарби скалярӣ (зарби дохилӣ)-и ду вектор.
3. Муайян кардани вазнҳо (Weighting). Холҳо бо softmax ба вазнҳо табдил дода мешаванд:
[
\alpha_{t,i} = \frac{\exp(e_{t,i})}{\sum_{k=1}^{n} \exp(e_{t,k})}
]
4. Сохтани вектори контекст (Context vector). Барои ҳар қадами баромадӣ вектори контекст ҳамчун ҷамъи вазндори ҳолатҳои рамзгузор ҳисоб мешавад:
[
c_t = \sum_{i=1}^{n} \alpha_{t,i}, h_i
]
5. Тавлиди калимаи баромадӣ. Рамзкушо, ки худ RNN аст, бо истифода аз вектори контекст, калимаи қаблӣ ва ҳолати ниҳонии худ ҳолати навро ҳисоб карда, калимаи (y_t)-ро тавлид мекунад:
[
s_t = f(s_{t-1}, y_{t-1}, c_t)
]
Агар вазнҳои (\alpha_{t,i})-ро барои ҳамаи ҷуфтҳои калимаҳо дар шакли ҷадвал ҷойгир кунем, матритсаи мувофиқат (Alignment matrix) ҳосил мешавад. Ин матритса ба таври аёнӣ нишон медиҳад, ки ҳар калимаи тарҷума ба кадом калимаҳои ҷумлаи аслӣ «нигоҳ кардааст».
Бо истилоҳҳои Query–Key–Value, дар механизми Баҳданау калидҳо ва арзишҳо як чизанд — ҳамон ҳолатҳои ниҳонии рамзгузор (h_i), — ва дархост аз ҳолати қаблии рамзкушо (s_{t-1}) гирифта мешавад.
Навъҳои асосии таваҷҷуҳ
Дар моделҳои омӯзиши амиқ навъҳои гуногуни таваҷҷуҳ истифода мешаванд. Маъмултарини онҳо инҳоянд.
Худтаваҷҷуҳӣ (Self-Attention). Дар тарҷумаи мошинӣ муайян кардани робитаҳои байни пайдарпайии манбаъ ва пайдарпайии мақсад муҳим аст. Аммо робитаҳоро дар дохили худи як пайдарпайӣ низ ҳисоб кардан мумкин аст. Дар худтаваҷҷуҳӣ дархостҳо, калидҳо ва арзишҳо ҳама аз ҳамон як пайдарпайии вурудӣ сохта мешаванд. Мисоли ҷонишини it дар боло маҳз натиҷаи худтаваҷҷуҳӣ аст.
Таваҷҷуҳ бо зарби скалярӣ (Dot-product Attention). Холҳои таваҷҷуҳ ҳамчун зарби скалярии векторҳои дархост ва калид ҳисоб мешаванд. Ин нисбат ба шабакаи пешрави Баҳданау содатар ва тезтар аст.
Таваҷҷуҳи миқёсбандишуда бо зарби скалярӣ (Scaled Dot-product Attention). Ҳамон зарби скалярӣ, аммо натиҷа ба (\sqrt{d_k}) — решаи квадратии андозаи вектори калид — тақсим мешавад. Ин навъ дар Transformer истифода мешавад ва дар поён муфассал шарҳ дода мешавад.
Таваҷҷуҳи чандсарӣ (Multi-head Attention). Векторҳои дархост, калид ва арзиш ба якчанд «сар» ҷудо мешаванд ва таваҷҷуҳи миқёсбандишуда барои ҳар сар алоҳида иҷро мешавад. Сипас натиҷаҳо ба ҳам пайваст карда мешаванд.
Таваҷҷуҳи сохторӣ (Structured Attention). Ин навъ имкон медиҳад, ки вазнҳои таваҷҷуҳ бо истифода аз моделҳои пешгӯии сохторӣ (масалан, бо назардошти сохтори синтаксисии ҷумла) омӯхта шаванд.
Ин навъҳоро метавон бо ҳам омехта кард ва дар сохторҳои гуногун истифода бурд. Навъҳои самараноки таваҷҷуҳ барои матнҳои хеле дароз (масалан, таваҷҷуҳи маҳаллӣ ё LSH) дар боби 13 баррасӣ мешаванд.
Худтаваҷҷуҳӣ қадам ба қадам
Акнун сохтори дохилии худтаваҷҷуҳиро баррасӣ карда, онро аз сифр бо PyTorch барномарезӣ мекунем. Худтаваҷҷуҳӣ пояи ҳар модели бузурги забонии бар Transformer асосёфта, аз ҷумла моделҳои силсилаи GPT, мебошад. Фаҳмидани он шояд таваҷҷуҳи зиёд талаб кунад, аммо вақте асосҳояшро дарк кардед, яке аз душвортарин қисмҳои сохтани моделҳои бузурги забониро аз худ кардаед.
Мо чор марҳиларо тай мекунем:
- худтаваҷҷуҳии сода бе вазнҳои омӯзишпазир;
- худтаваҷҷуҳӣ бо вазнҳои омӯзишпазир (таваҷҷуҳи миқёсбандишуда);
- таваҷҷуҳи сабабӣ (ниқоб ва dropout);
- таваҷҷуҳи чандсарӣ.
Маънои «худ» дар худтаваҷҷуҳӣ
Калимаи «худ» ба он ишора мекунад, ки механизм вазнҳои таваҷҷуҳро тавассути робитаи мавқеъҳои гуногуни як пайдарпайии вурудӣ ҳисоб мекунад. Он робитаҳо ва вобастагиҳои байни қисмҳои гуногуни худи вурудро меомӯзад — масалан, робитаи байни калимаҳои як ҷумла ё пикселҳои як тасвир.
Дар механизмҳои анъанавии таваҷҷуҳ, ба монанди таваҷҷуҳи Баҳданау, бошад, робитаи байни унсурҳои ду пайдарпайии гуногун — пайдарпайии вурудӣ ва баромадӣ — арзёбӣ мешавад.
Худтаваҷҷуҳии сода бе вазнҳои омӯзишпазир
Аввал нусхаи содаи худтаваҷҷуҳиро месозем, ки ягон вазни омӯзишпазир надорад. Ҳадаф — нишон додани мафҳумҳои асосӣ пеш аз мураккаб кардани механизм.
Ҷумлаи вурудии зеринро дар назар мегирем:
“Your journey starts with one step.” — «Сафари шумо бо як қадам оғоз мешавад».
Ҳар унсури пайдарпайӣ, масалан (x^{(1)}), вектори эмбеддинги (d)-ченака мебошад, ки токени муайянро (масалан, “Your”) ифода мекунад. Барои содагӣ эмбеддингҳои сеченакаро истифода мебарем:
import torch

inputs = torch.tensor(
    [[0.43, 0.15, 0.89],  # Your     (x^1)
     [0.55, 0.87, 0.66],  # journey  (x^2)
     [0.57, 0.85, 0.64],  # starts   (x^3)
     [0.22, 0.58, 0.33],  # with     (x^4)
     [0.77, 0.25, 0.10],  # one      (x^5)
     [0.05, 0.80, 0.55]]  # step     (x^6)
)
Ҳадафи худтаваҷҷуҳӣ ҳисоб кардани вектори контекст (z^{(i)}) барои ҳар унсури вурудӣ (x^{(i)}) мебошад. Вектори контекстро метавон эмбеддинги ғанишуда донист: он маълумотро ҳам дар бораи худи (x^{(i)}) ва ҳам дар бораи ҳамаи унсурҳои дигари пайдарпайӣ, аз (x^{(1)}) то (x^{(T)}), дар бар мегирад. Ин барои моделҳои забонӣ муҳим аст, зеро онҳо бояд робита ва аҳамияти калимаҳоро нисбат ба ҳамдигар дарк кунанд.
Барои мисол унсури дуюм — (x^{(2)}), токени “journey” («сафар») — -ро ҳамчун дархост мегирем ва вектори контексти (z^{(2)})-ро ҳисоб мекунем.
Қадами 1: холҳои таваҷҷуҳ
Холҳои таваҷҷуҳ (\omega_{2i}) ҳамчун зарби скалярии дархост (x^{(2)}) бо ҳар унсури вурудӣ ҳисоб мешаванд:
query = inputs[1]  # Унсури дуюми вурудӣ

attn_scores_2 = torch.empty(inputs.shape[0])
for i, x_i in enumerate(inputs):
    attn_scores_2[i] = torch.dot(x_i, query)

print(attn_scores_2)
tensor([0.9544, 1.4950, 1.4754, 0.8434, 0.7070, 1.0865])
Зарби скалярӣ (Dot product) унсурҳои мувофиқи ду векторро зарб карда, ҳосилҳоро ҷамъ мекунад ва ду векторро ба як адад табдил медиҳад. Ғайр аз амали риёзӣ будан, он меъёри шабоҳат низ ҳаст: зарби скалярии баландтар аз ҳамсамтии бештари векторҳо шаҳодат медиҳад. Барои векторҳои воҳидӣ зарби скалярии ду вектори яксон ба 1, ду вектори ба ҳам амудӣ ба 0 ва ду вектори муқобилсамт ба −1 баробар аст. Дар худтаваҷҷуҳӣ ҳар қадар зарби скалярӣ баландтар бошад, холи таваҷҷуҳи байни ду унсур ҳамон қадар бештар мешавад.
Дар мисоли мо холҳои баландтарин ба худи “journey” (1.4950) ва ба “starts” (1.4754) тааллуқ доранд: эмбеддингҳои ин ду калима дар мисоли сохтаи мо ба ҳам монанданд.
Қадами 2: ба меъёр овардан
Холҳоро ба меъёр меорем, то ҷамъашон ба 1 баробар шавад. Роҳи соддатарин — тақсим кардан ба ҷамъи онҳо:
attn_weights_2_tmp = attn_scores_2 / attn_scores_2.sum()

print("Attention weights:", attn_weights_2_tmp)
print("Sum:", attn_weights_2_tmp.sum())
Attention weights: tensor([0.1455, 0.2278, 0.2249, 0.1285, 0.1077, 0.1656])
Sum: tensor(1.0000)
Дар амал барои ба меъёр овардан функсияи softmax маъмултар ва тавсияшаванда аст. Он қиматҳои хеле калон ё хурдро беҳтар идора мекунад, ҳангоми омӯзиш хосиятҳои мусоидтари градиентӣ дорад ва кафолат медиҳад, ки вазнҳо ҳамеша мусбат бошанд. Аз ин рӯ, натиҷаро метавон ҳамчун эҳтимолият ё аҳамияти нисбӣ шарҳ дод: вазни баландтар аҳамияти бештарро нишон медиҳад.
Татбиқи одии softmax чунин аст:
def softmax_naive(x):
    return torch.exp(x) / torch.exp(x).sum(dim=0)

attn_weights_2_naive = softmax_naive(attn_scores_2)

print("Attention weights:", attn_weights_2_naive)
print("Sum:", attn_weights_2_naive.sum())
Attention weights: tensor([0.1385, 0.2379, 0.2333, 0.1240, 0.1082, 0.1581])
Sum: tensor(1.)
Ин татбиқи сода ҳангоми кор бо қиматҳои хеле калон ё хурд метавонад ба ноустувории ададӣ — пуршавӣ (overflow) ва холишавӣ (underflow) — дучор шавад: қиматҳо метавонанд аз ҳудуди қобили ифода берун раванд ё он қадар хурд шаванд, ки ҳамчун сифр нигоҳ дошта шаванд. Аз ин рӯ, дар амал аз татбиқи беҳинасозишудаи PyTorch истифода мебарем:
attn_weights_2 = torch.softmax(attn_scores_2, dim=0)

print("Attention weights:", attn_weights_2)
print("Sum:", attn_weights_2.sum())
Натиҷа бо натиҷаи softmax_naive яксон аст:
Attention weights: tensor([0.1385, 0.2379, 0.2333, 0.1240, 0.1082, 0.1581])
Sum: tensor(1.)
Қадами 3: вектори контекст
Вектори контекст (z^{(2)}) ҷамъи вазндори ҳамаи векторҳои вурудӣ мебошад: ҳар вектори (x^{(i)}) ба вазни таваҷҷуҳи мувофиқ зарб шуда, натиҷаҳо ҷамъ карда мешаванд:
[
z^{(2)} = \sum_{i=1}^{T} \alpha_{2i}, x^{(i)}
]
query = inputs[1]  # Унсури дуюми вурудӣ

context_vec_2 = torch.zeros(query.shape)
for i, x_i in enumerate(inputs):
    context_vec_2 += attn_weights_2[i] * x_i

print(context_vec_2)
tensor([0.4419, 0.6515, 0.5683])
Ҳисоб барои ҳамаи токенҳо
То ин ҷо вазнҳои таваҷҷуҳ ва вектори контекстро танҳо барои унсури дуюм ҳисоб кардем. Акнун ҳисобро барои ҳамаи унсурҳо васеъ мекунем. Ба ҷойи даврҳои for аз зарби матритсаҳо истифода мебарем, ки ҳамон натиҷаро самараноктар ва кӯтоҳтар медиҳад:
attn_scores = inputs @ inputs.T                    # (6, 6): ҳамаи ҷуфтҳои зарби скалярӣ
attn_weights = torch.softmax(attn_scores, dim=-1)  # ҳар сатр ба 1 баробар
all_context_vecs = attn_weights @ inputs           # (6, 3)

print(all_context_vecs)
tensor([[0.4421, 0.5931, 0.5790],
        [0.4419, 0.6515, 0.5683],
        [0.4431, 0.6496, 0.5671],
        [0.4304, 0.6298, 0.5510],
        [0.4671, 0.5910, 0.5266],
        [0.4177, 0.6503, 0.5645]])
Сатри дуюм бо вектори context_vec_2, ки дар боло ҳисоб кардем, мувофиқ аст. Дар матритсаи attn_weights ҳар сатр ба як дархост (токен) ва ҳар сутун ба як калид мувофиқ аст; аз ин рӯ, dim=-1 маънои ба меъёр овардан аз рӯи сутунҳоро дорад.
Расми 4.1 тамоми матритсаи attn_weights-ро барои ҷумлаи мисол нишон медиҳад.
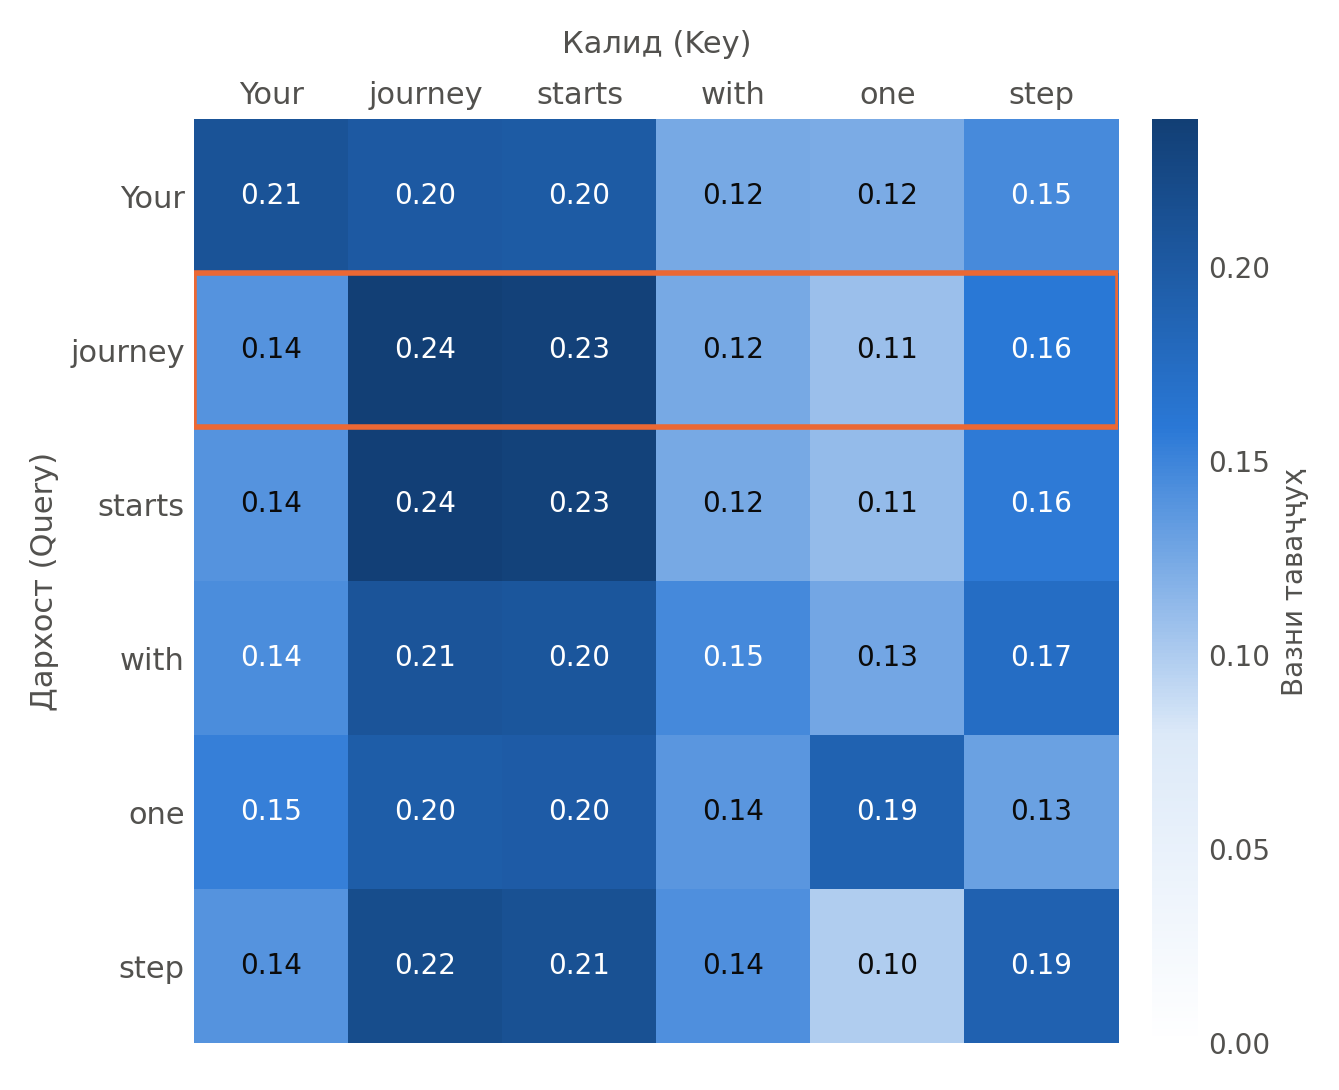
Расми 4.1. Вазнҳои таваҷҷуҳ (softmax(inputs @ inputs.T)) барои ҷумлаи “Your journey starts with one step”. Ҳар сатр — дархост, ҳар сутун — калид; ҷамъи ҳар сатр ба 1 баробар аст. Сатри “journey” (дар чорчӯба) ҳамон вазнҳои дар боло ҳисобшуда мебошад.
Худтаваҷҷуҳӣ бо вазнҳои омӯзишпазир
Дар механизми сода худи эмбеддингҳо ҳам дархост, ҳам калид ва ҳам арзиш буданд. Дар моделҳои воқеӣ се матритсаи вазни омӯзишпазир (W_q), (W_k) ва (W_v) илова мешаванд, ки ҳар эмбеддингро ба се намояндагии мобайнӣ табдил медиҳанд:
[
q^{(i)} = x^{(i)} W_q, \qquad k^{(i)} = x^{(i)} W_k, \qquad v^{(i)} = x^{(i)} W_v
]
Ин вазнҳо ҳангоми омӯзиш танзим мешаванд, то модел худаш омӯзад, ки кадом «саволҳо» бидиҳад, бо кадом «калидҳо» ҷавоб гӯяд ва кадом маълумотро интиқол диҳад. Дар шакли матритсавӣ: (Q = XW_q), (K = XW_k), (V = XW_v).
Холҳо ҳамчун (QK^{\top}) ҳисоб мешаванд ва пеш аз softmax ба (\sqrt{d_k}) тақсим карда мешаванд, ки дар он (d_k) андозаи векторҳои калид аст:
[
\operatorname{Attention}(Q, K, V) = \operatorname{softmax}!\left(\frac{QK^{\top}}{\sqrt{d_k}}\right) V
]
Ҳамин формула таваҷҷуҳи миқёсбандишуда бо зарби скалярӣ (Scaled Dot-Product Attention) ном дорад. Сабаби миқёсбандӣ: дар векторҳои калонченака зарбҳои скалярӣ хеле калон мешаванд ва softmax-ро ба ҳолати «сершуда» мебаранд, ки дар он қариб тамоми вазн ба як токен мерасад ва градиентҳо хеле хурд мешаванд. Тақсим ба (\sqrt{d_k}) пароканда будани холҳоро мӯътадил нигоҳ медорад ва омӯзишро устувор мекунад.
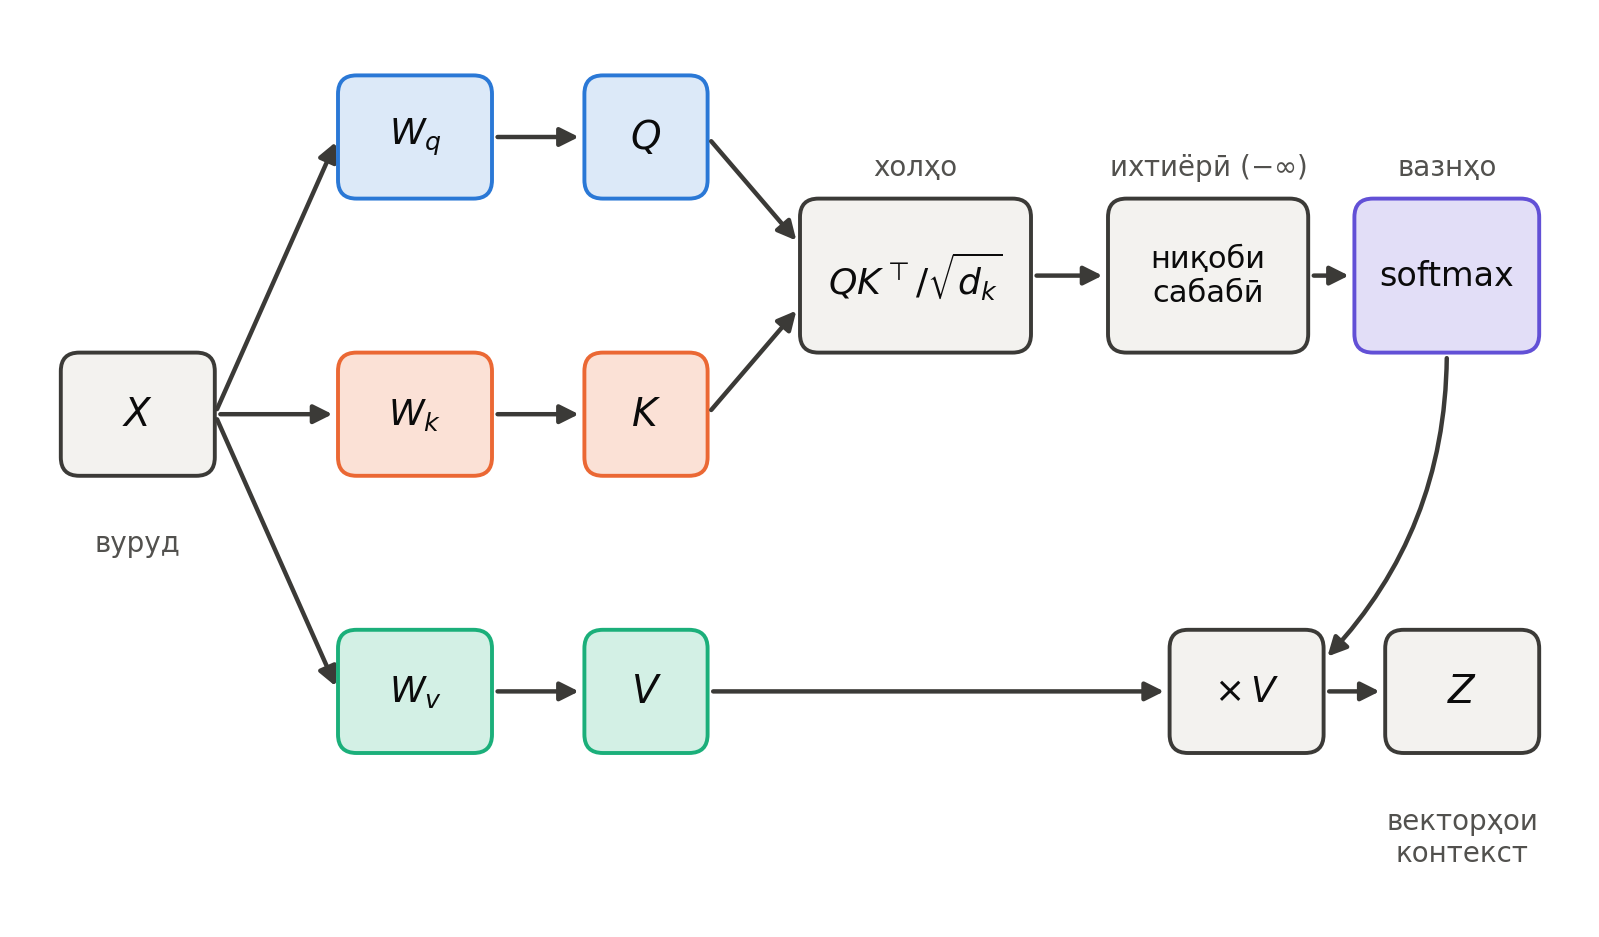
Расми 4.2. Таваҷҷуҳи миқёсбандишуда бо зарби скалярӣ: вуруди (X) бо матритсаҳои (W_q), (W_k), (W_v) ба (Q), (K), (V) табдил меёбад; холҳои (QK^{\top}/\sqrt{d_k}) (дар моделҳои GPT — бо ниқоби сабабӣ) аз softmax гузашта, ба (V) зарб мешаванд ва векторҳои контекст (Z) ҳосил мегарданд.
Дар PyTorch ин механизмро бо қабатҳои nn.Linear (бе bias) ба шакли синф менависем:
import torch.nn as nn

class SelfAttention(nn.Module):
    def __init__(self, d_in, d_out, qkv_bias=False):
        super().__init__()
        self.W_query = nn.Linear(d_in, d_out, bias=qkv_bias)
        self.W_key   = nn.Linear(d_in, d_out, bias=qkv_bias)
        self.W_value = nn.Linear(d_in, d_out, bias=qkv_bias)

    def forward(self, x):
        queries = self.W_query(x)
        keys    = self.W_key(x)
        values  = self.W_value(x)

        attn_scores = queries @ keys.T
        attn_weights = torch.softmax(
            attn_scores / keys.shape[-1] ** 0.5, dim=-1
        )
        return attn_weights @ values

torch.manual_seed(123)
sa = SelfAttention(d_in=3, d_out=2)
print(sa(inputs).shape)  # torch.Size([6, 2])
Модул шаш вектори сеченакаро қабул карда, шаш вектори контексти дученака бармегардонад. Қиматҳои мушаххаси онҳо аз вазнҳои тасодуфии ибтидоӣ вобастаанд ва ҳангоми омӯзиш тағйир меёбанд.
Таваҷҷуҳи сабабӣ: пинҳон кардани калимаҳои оянда
Моделҳои GPT матнро аз чап ба рост тавлид мекунанд: ҳангоми пешгӯии токени навбатӣ модел бояд танҳо ба токенҳои қаблӣ ва ҷорӣ дастрасӣ дошта бошад. Аммо механизми боло ба ҳар токен имкон медиҳад, ки ба ҳамаи токенҳо, аз ҷумла ба токенҳои оянда, «нигоҳ кунад». Барои манъ кардани ин ниқоби таваҷҷуҳи сабабӣ (Causal attention mask) истифода мешавад. Онро таваҷҷуҳи ниқобдор (Masked attention) низ меноманд.
Ғоя сода аст: дар матритсаи холҳо ҳамаи қиматҳои болои диагонали асосӣ (яъне холҳои токенҳои оянда) ба манфии беохир ((-\infty)) иваз карда мешаванд. Азбаски (e^{-\infty} = 0), пас аз softmax вазни ин мавқеъҳо ба сифр баробар мешавад, ва вазнҳои боқимондаи ҳар сатр боз ба 1 ҷамъ мешаванд:
# Идомаи forward-и SelfAttention: attn_scores = queries @ keys.T
context_length = attn_scores.shape[0]
mask = torch.triu(torch.ones(context_length, context_length), diagonal=1)
masked = attn_scores.masked_fill(mask.bool(), -torch.inf)
attn_weights = torch.softmax(masked / keys.shape[-1] ** 0.5, dim=-1)
Дар натиҷа матритсаи вазнҳо секунҷаи поёнӣ мешавад: токени якум танҳо ба худаш, токени дуюм ба токенҳои 1–2, токени сеюм ба токенҳои 1–3 ва ғайра таваҷҷуҳ мекунад.
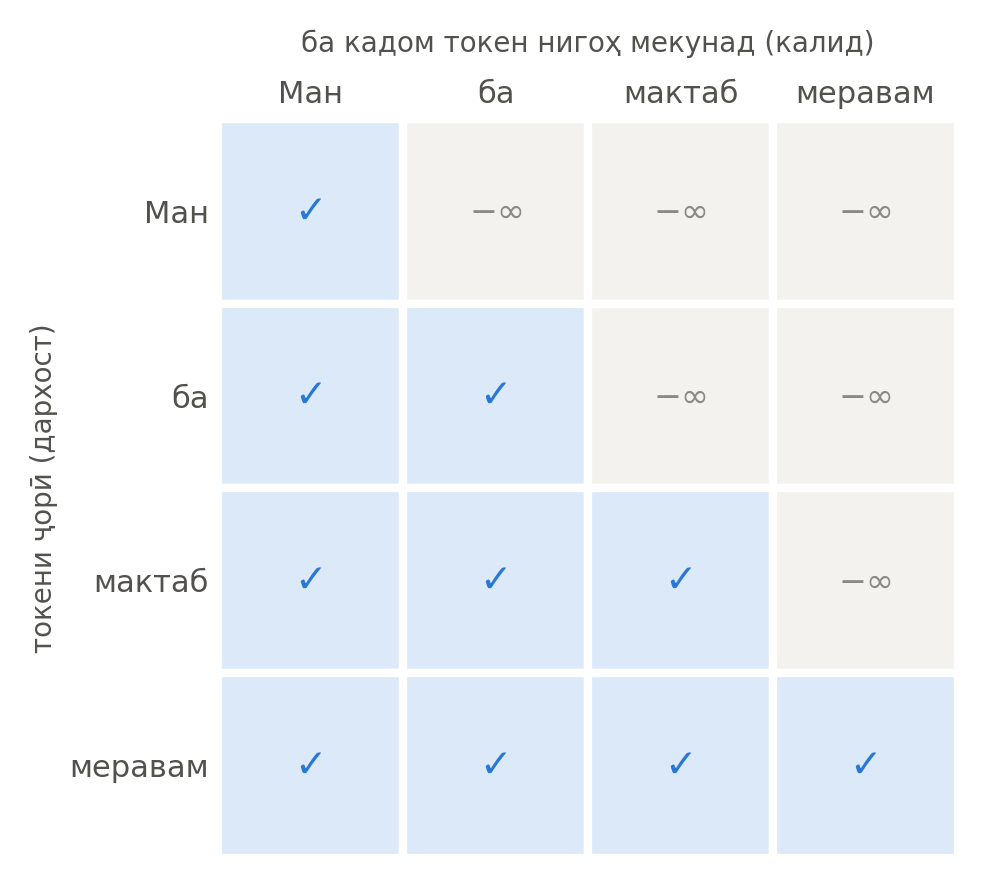
Расми 4.3. Ниқоби таваҷҷуҳи сабабӣ барои ҷумлаи «Ман ба мактаб меравам»: ҳар токен (сатр) танҳо ба худ ва ба токенҳои пешина (✓) таваҷҷуҳ мекунад; холҳои токенҳои оянда ба (-\infty) иваз шуда, пас аз softmax ба сифр баробар мешаванд.
Эзоҳ: Агар вазнҳои softmax-шударо баъдан бо сифр ниқоб карда, аз нав ба меъёр оварем, ҳамон натиҷа ҳосил мешавад. Аммо ниқобгузорӣ бо (-\infty) пеш аз softmax содатар ва самараноктар аст, зеро ба меъёрсозии дубора ниёз надорад.
Dropout дар вазнҳои таваҷҷуҳ
Dropout усули пешгирӣ аз мутобиқшавии аз ҳад зиёд (Overfitting) аст: ҳангоми омӯзиш як қисми тасодуфии воҳидҳо муваққатан ғайрифаъол (ба сифр баробар) карда мешаванд, то модел ба маҷмӯи муайяни воҳидҳо аз ҳад зиёд вобаста нашавад. Дар таваҷҷуҳ dropout одатан ба матритсаи вазнҳои таваҷҷуҳ пас аз softmax татбиқ мешавад.
torch.manual_seed(123)
dropout = nn.Dropout(0.5)  # 50% унсурҳо ба сифр иваз мешаванд
example = torch.ones(6, 6)
print(dropout(example))
Барои он ки миқёси умумии сигнал тағйир наёбад, унсурҳои боқимонда ба (1/(1-p)) зарб карда мешаванд: бо (p = 0.5) ҳар унсури боқимонда ба 2 баробар мешавад. Dropout танҳо ҳангоми омӯзиш фаъол аст; ҳангоми истифодаи модел (model.eval()) он хомӯш мешавад. Дар моделҳои GPT меъёри dropout одатан хурдтар аст, масалан 0.1, ва бисёр моделҳои бузурги муосир онро ҳангоми пешомӯзиш тамоман истифода намебаранд.
Синфи таваҷҷуҳи сабабӣ
Акнун ҳама қисмҳоро — вазнҳои омӯзишпазир, миқёсбандӣ, ниқоби сабабӣ ва dropout — дар як синф ҷамъ мекунем. Ин синф инчунин бастаҳо (Batches)-и якчанд матнро коркард мекунад, бинобар ин вуруд шакли (b, num_tokens, d_in) дорад:
class CausalAttention(nn.Module):
    def __init__(self, d_in, d_out, context_length, dropout, qkv_bias=False):
        super().__init__()
        self.W_query = nn.Linear(d_in, d_out, bias=qkv_bias)
        self.W_key   = nn.Linear(d_in, d_out, bias=qkv_bias)
        self.W_value = nn.Linear(d_in, d_out, bias=qkv_bias)
        self.dropout = nn.Dropout(dropout)
        self.register_buffer(
            "mask",
            torch.triu(torch.ones(context_length, context_length), diagonal=1)
        )

    def forward(self, x):
        b, num_tokens, d_in = x.shape
        queries = self.W_query(x)
        keys    = self.W_key(x)
        values  = self.W_value(x)

        attn_scores = queries @ keys.transpose(1, 2)
        attn_scores.masked_fill_(
            self.mask.bool()[:num_tokens, :num_tokens], -torch.inf
        )
        attn_weights = torch.softmax(
            attn_scores / keys.shape[-1] ** 0.5, dim=-1
        )
        attn_weights = self.dropout(attn_weights)
        return attn_weights @ values

batch = torch.stack((inputs, inputs), dim=0)  # 2 матн, 6 токенӣ
torch.manual_seed(123)
ca = CausalAttention(d_in=3, d_out=2, context_length=6, dropout=0.0)
print(ca(batch).shape)  # torch.Size([2, 6, 2])
register_buffer ниқобро ҳамчун қисми модел нигоҳ медорад (масалан, ҳангоми интиқол ба GPU), аммо онро параметри омӯзишпазир намешуморад.
Таваҷҷуҳи чандсарӣ
Як модули таваҷҷуҳ танҳо як навъи робитаро дар як вақт хуб омӯхта метавонад. Таваҷҷуҳи чандсарӣ (Multi-Head Attention) якчанд модули таваҷҷуҳи сабабиро бо вазнҳои гуногун параллелӣ иҷро мекунад. Ҳар модул як сар (Head) аст: вектори вурудӣ ба чанд маҷмӯи гуногуни қабатҳои хаттӣ ва блокҳои таваҷҷуҳ дода мешавад. Интизор меравад, ки ҳар сар ба ҷанбаҳои гуногун таваҷҷуҳ карда, робитаҳои гуногунро омӯзад — чунон ки дар бахши тасаввурӣ дидем. Баромадҳои ҳамаи сарҳо ба ҳам пайваст (concatenate) шуда, аз як қабати хаттии ниҳоӣ мегузаранд:
[
\operatorname{MultiHead}(Q, K, V) = \operatorname{Concat}(\text{head}_1, \dots, \text{head}_h), W^{O}
]
Роҳи соддатарини сохтани он — якҷоя кардани чанд нусхаи CausalAttention:
class MultiHeadAttentionWrapper(nn.Module):
    def __init__(self, d_in, d_out, context_length, dropout, num_heads,
                 qkv_bias=False):
        super().__init__()
        self.heads = nn.ModuleList(
            [CausalAttention(d_in, d_out, context_length, dropout, qkv_bias)
             for _ in range(num_heads)]
        )

    def forward(self, x):
        return torch.cat([head(x) for head in self.heads], dim=-1)
Ин нусха сарҳоро пайдарпай ҳисоб мекунад. Роҳи самараноктар — ҳисоб кардани ҳамаи сарҳо бо як зарби матритса: дархостҳо, калидҳо ва арзишҳо барои ҳамаи сарҳо якбора ҳисоб шуда, сипас бо view ва transpose ба сарҳо тақсим мешаванд. Ин усул зарби бастаии матритсаҳо (Batched matrix multiplication)-ро истифода мебарад:
class MultiHeadAttention(nn.Module):
    def __init__(self, d_in, d_out, context_length, dropout, num_heads,
                 qkv_bias=False):
        super().__init__()
        assert d_out % num_heads == 0, "d_out бояд ба num_heads тақсим шавад"
        self.d_out = d_out
        self.num_heads = num_heads
        self.head_dim = d_out // num_heads

        self.W_query = nn.Linear(d_in, d_out, bias=qkv_bias)
        self.W_key   = nn.Linear(d_in, d_out, bias=qkv_bias)
        self.W_value = nn.Linear(d_in, d_out, bias=qkv_bias)
        self.out_proj = nn.Linear(d_out, d_out)  # пайваст кардани сарҳо
        self.dropout = nn.Dropout(dropout)
        self.register_buffer(
            "mask",
            torch.triu(torch.ones(context_length, context_length), diagonal=1)
        )

    def forward(self, x):
        b, num_tokens, d_in = x.shape
        queries = self.W_query(x)
        keys    = self.W_key(x)
        values  = self.W_value(x)

        # (b, num_tokens, d_out) -> (b, num_heads, num_tokens, head_dim)
        def split(t):
            return t.view(b, num_tokens, self.num_heads, self.head_dim).transpose(1, 2)
        queries, keys, values = split(queries), split(keys), split(values)

        attn_scores = queries @ keys.transpose(2, 3)
        mask_bool = self.mask.bool()[:num_tokens, :num_tokens]
        attn_scores.masked_fill_(mask_bool, -torch.inf)

        attn_weights = torch.softmax(attn_scores / self.head_dim ** 0.5, dim=-1)
        attn_weights = self.dropout(attn_weights)

        # (b, num_heads, num_tokens, head_dim) -> (b, num_tokens, d_out)
        context_vec = (attn_weights @ values).transpose(1, 2)
        context_vec = context_vec.contiguous().view(b, num_tokens, self.d_out)
        return self.out_proj(context_vec)
Дар ин нусха андозаи ҳар сар head_dim = d_out / num_heads аст, бинобар ин хароҷоти ҳисоббарорӣ тақрибан ба хароҷоти як сари калон баробар мемонад. Масалан, дар хурдтарин модели GPT-2 12 сар ва андозаи эмбеддинги 768 истифода мешавад, яъне андозаи ҳар сар 64 аст.
Эзоҳ: Дар китобхонаҳои муосир ин ҳисобро функсияҳои омодаи беҳинасозишуда, масалан
torch.nn.functional.scaled_dot_product_attention, иҷро мекунанд, ки аз алгоритмҳои ба монанди FlashAttention истифода мебаранд. Моделҳои бузурги имрӯза инчунин аксар вақт гурӯҳҳои сарҳоро барои калидҳо ва арзишҳо муштарак мекунанд (Grouped-Query Attention). Ин усулҳо ва кэши калид–арзиш (KV cache) дар боби 13 баррасӣ мешаванд.
Блоки Transformer
Модули таваҷҷуҳи чандсарӣ қалби Transformer аст, аммо худ ба худ модел намешавад. Он дар дохили блоки Transformer ҷойгир мешавад, ки инчунин шабакаи пешрав, меъёрсозии қабатӣ ва пайвастҳои боқимондаро дар бар мегирад. Модели забонӣ аз даҳҳо чунин блокҳои якхела, ки пайи ҳам ҷойгир шудаанд, иборат аст. Дар ин бахш ҳар ҷузъи блокро алоҳида месозем ва сипас онҳоро ба ҳам мепайвандем.
Шабакаи пешрав (Feed-Forward)
Пас аз он ки таваҷҷуҳ маълумотро байни токенҳо интиқол медиҳад, шабакаи пешрав намояндагии ҳар токенро алоҳида коркард мекунад. Дар ин бахш мубодилаи мустақими маълумот байни мавқеъҳо сурат намегирад, аммо ҳар мавқеъ аллакай маълумотеро дорад, ки таваҷҷуҳ аз токенҳои дигар ҷамъ кардааст.
Нейронҳо ва пайвастҳо
Нейронҳои шабака дар асл амалҳои риёзӣ мебошанд: онҳо ҷамъи вазндори вурудҳоро ҳисоб карда, натиҷаро аз функсияи фаъолсозӣ мегузаронанд (нигаред ба боби 3). Шабакаи пешрави Transformer аз ду қабати хаттӣ иборат аст: қабати якум андозаи векторро одатан чор маротиба зиёд мекунад, баъд функсияи фаъолсозӣ меояд ва қабати дуюм андозаро ба ҳолати аввал бармегардонад.
Қувваи ин шабака аз шумораи зиёди пайвастҳояш бармеояд. Дар бузургтарин нусхаи GPT-3 андозаи намояндагии асосӣ 12 288 ва андозаи қабати мобайнии пешрав 49 152 буд. Аз ин рӯ, ду табдили ин бахш дар ҳар қабат тақрибан чунин шумораи параметр доштанд:
12 288 × 49 152 + 49 152 × 12 288 ≈ 1,2 миллиард
Бо 96 қабат ин ба тақрибан 116 миллиард параметр мерасад — қариб аз се ду ҳиссаи 175 миллиард параметри GPT-3. Яъне қисми асосии параметрҳои модел на дар таваҷҷуҳ, балки дар шабакаҳои пешрав ҷойгир аст.
Таҳқиқот нишон медиҳад, ки шабакаҳои пешрав метавонанд ба қолабҳои муайяни намояндагиҳои дохилӣ ҷавоб диҳанд. Дар қабатҳои аввал ин қолабҳо ба калимаҳо ё ибораҳои мушаххас наздиканд, дар қабатҳои баъдӣ — ба робитаҳои умумитар ва абстрактӣ. Масалан, шабака дар мавқеи калимаи «бойгонишуда» метавонад ба тамоми ибораи «нусхаи навшудаи мақола, бойгонишуда» вокуниш нишон диҳад. Ин имконпазир аст, зеро таваҷҷуҳ пештар маълумоти калимаҳои дигарро ба намояндагии ҳамин мавқеъ интиқол додааст. Вақте шабака қолаби мувофиқро муайян мекунад, намояндагии токенро тағйир медиҳад; баъзан ин тағйиротро метавон ҳамчун қадаме ба сӯи пешгӯии токени навбатӣ шарҳ дод.
Функсияҳои фаъолсозӣ: ReLU, GELU ва SwiGLU
Дар Transformer-и аслӣ функсияи фаъолсозии ReLU истифода мешуд, ки бо сабаби содагӣ ва самаранокиаш дар шабакаҳои нейронӣ васеъ маъмул буд. Дар моделҳои бузурги забонӣ бошад, функсияҳои ҳамвортар маъмуланд:
- GELU (Gaussian Error Linear Unit) — воҳиди хаттии хатои гауссӣ; дар GPT-2 ва BERT истифода мешавад;
- SwiGLU (Swish-Gated Linear Unit) — воҳиди хаттии дарвозадор бо функсияи Swish; дар бисёр моделҳои кушодаи муосир (масалан, силсилаи LLaMA) истифода мешавад.
Ин функсияҳо мураккабтар ва ҳамвортар аз ReLU мебошанд: GELU ба тақсимоти гауссӣ асос ёфтааст ва SwiGLU воҳидҳои хаттии дорои «дарвоза»-ро истифода мебарад. Дар муқоиса бо ReLU онҳо метавонанд сифати моделҳои амиқро беҳтар кунанд.
Шакли дақиқи GELU чунин аст:
[
\operatorname{GELU}(x) = x \cdot \Phi(x)
]
Дар ин ҷо (\Phi(x)) функсияи тақсимоти ҷамъшавандаи тақсимоти гауссии стандартӣ аст, яъне эҳтимоли он ки адади тасодуфии меъёрӣ аз (x) хурдтар бошад. Ба ибораи дигар, GELU вурудро ба «эҳтимоли гузаштани» он зарб мекунад: қиматҳои калони мусбат қариб бетағйир мегузаранд, қиматҳои калони манфӣ қариб ба сифр мерасанд ва дар атрофи сифр гузариш ҳамвор аст. Бар хилофи ReLU, ки дар нуқтаи сифр шикасти тез дорад ва барои ҳамаи қиматҳои манфӣ градиенти сифр медиҳад, GELU ҳамвор аст ва барои қиматҳои хурди манфӣ низ градиенти ғайрисифрӣ дорад. Ин ба омӯзиши шабака кӯмак мекунад.
Дар амал одатан аз наздиксозие истифода мекунанд, ки ҳисобаш арзонтар аст; модели аслии GPT-2 низ бо ҳамин наздиксозӣ омӯзонида шудааст. Он бо мутобиқ кардани каҷхати (\tanh) ба функсияи аслӣ ба даст омадааст:
[
\operatorname{GELU}(x) \approx 0.5 \cdot x \cdot \left(1 + \tanh\left[\sqrt{\frac{2}{\pi}} \cdot \left(x + 0.044715 \cdot x^{3}\right)\right]\right)
]
Дар PyTorch онро чунин менависем:
class GELU(nn.Module):
    def forward(self, x):
        return 0.5 * x * (1 + torch.tanh(
            torch.sqrt(torch.tensor(2.0 / torch.pi)) *
            (x + 0.044715 * torch.pow(x, 3))
        ))
Эзоҳ: Дар PyTorch функсияи омода низ ҳаст:
nn.GELU()шакли дақиқро ҳисоб мекунад ваnn.GELU(approximate="tanh")ҳамин наздиксозиро.
Бо ин функсия модули шабакаи пешравро месозем, ки андозаро аз emb_dim ба 4 * emb_dim васеъ ва баъд боз танг мекунад:
class FeedForward(nn.Module):
    def __init__(self, cfg):
        super().__init__()
        self.layers = nn.Sequential(
            nn.Linear(cfg["emb_dim"], 4 * cfg["emb_dim"]),
            GELU(),
            nn.Linear(4 * cfg["emb_dim"], cfg["emb_dim"]),
        )

    def forward(self, x):
        return self.layers(x)
Шакли вуруд ва баромади ин модул яксон аст — (batch, num_tokens, emb_dim). Васеъ кардани андоза дар қабати мобайнӣ ба шабака имкон медиҳад, ки намояндагиҳоро дар фазои бойтар коркард кунад.
SwiGLU ба ҷойи як қабати васеъкунанда ду қабати параллелӣ дорад: яке аз функсияи Swish ((\operatorname{Swish}(x) = x \cdot \sigma(x))) мегузарад ва ҳамчун «дарвоза» ба натиҷаи дигаре унсур ба унсур зарб мешавад:
[
\operatorname{FFN}_{\text{SwiGLU}}(x) = \left(\operatorname{Swish}(xW_1) \odot xV\right) W_2
]
Меъёрсозии қабатӣ (Layer Normalization)
Омӯзиши шабакаҳои амиқи серқабата метавонад бо сабаби нестшавӣ ё таркиши градиентҳо душвор шавад. Ин мушкилот раванди омӯзишро ноустувор мекунанд ва ба шабака намегузоранд, ки вазнҳояшро самаранок танзим карда, параметрҳоеро ёбад, ки функсияи хаторо кам мекунанд.
Ғояи асосии меъёрсозии қабатӣ ин аст, ки фаъолсозиҳо (баромадҳо)-и қабат тавре танзим шаванд, ки миёнаашон ба 0 ва дисперсияашон ба 1 (дисперсияи воҳидӣ) баробар бошад. Ин расидан ба вазнҳои муносибро тезтар ва омӯзишро устувортар мекунад. Ғайр аз ин, ду параметри омӯзишпазир — миқёс (scale) ва ҷобаҷогузорӣ (shift) — ба модел имкон медиҳанд, ки агар лозим бошад, ин меъёрсозиро «ислоҳ» кунад:
class LayerNorm(nn.Module):
    def __init__(self, emb_dim):
        super().__init__()
        self.eps = 1e-5  # барои пешгирӣ аз тақсим ба сифр
        self.scale = nn.Parameter(torch.ones(emb_dim))
        self.shift = nn.Parameter(torch.zeros(emb_dim))

    def forward(self, x):
        mean = x.mean(dim=-1, keepdim=True)
        var = x.var(dim=-1, keepdim=True, unbiased=False)
        norm_x = (x - mean) / torch.sqrt(var + self.eps)
        return self.scale * norm_x + self.shift
Меъёрсозӣ аз рӯи ченаки охирин (dim=-1), яъне аз рӯи унсурҳои вектори эмбеддинги ҳар токен, иҷро мешавад.
Баҳодиҳии ғаразноки дисперсия. Танзими unbiased=False маънои онро дорад, ки дар формулаи дисперсия натиҷа ба шумораи унсурҳо (n) тақсим мешавад. Дар ин ҳолат ислоҳи Бессел, ки барои ҷуброни ғараз дар баҳодиҳии дисперсияи намуна дар махраҷ (n-1)-ро истифода мебарад, татбиқ намешавад. Дар моделҳои бузурги забонӣ андозаи эмбеддинг хеле калон аст, бинобар ин фарқи байни (n) ва (n-1) дар амал ночиз аст. Ин интихоб барои мутобиқат бо қабатҳои меъёрсозии GPT-2 ва рафтори пешфарзи TensorFlow, ки GPT-2-и аслӣ бо он сохта шуда буд, анҷом дода шудааст. Ҳамин мутобиқат имкон медиҳад, ки вазнҳои пешомӯзишдидаи GPT-2-и аслиро ба модели мо бор кардан мумкин бошад.
Фарқ аз меъёрсозии бастаӣ. Меъёрсозии бастаӣ (Batch Normalization) аз рӯи андозаи бастаи намунаҳо меъёрсозӣ мекунад, аммо меъёрсозии қабатӣ — аз рӯи хусусиятҳои ҳар намуна. Андозаи баста дар моделҳои бузурги забонӣ аз таҷҳизоти дастрас ва вазифа вобаста аст ва метавонад тағйир ёбад. Меъёрсозии қабатӣ ҳар вурудро новобаста аз андозаи баста меъёрсозӣ мекунад, аз ин рӯ чандиртар ва устувортар аст. Ин хусусият махсусан барои омӯзиши тақсимшуда ва ҷойгир кардани моделҳо дар муҳитҳои захирааш маҳдуд муфид аст.
Эзоҳ: Дар бисёр моделҳои кушодаи муосир ба ҷойи LayerNorm варианти соддатари он — RMSNorm — истифода мешавад, ки миёнаро тарҳ намекунад ва танҳо аз рӯи решаи миёнаи квадратӣ меъёрсозӣ менамояд.
Пайвастҳои боқимонда (Residual connections)
Пайвастҳои боқимонда ё пайвастҳои миёнбур (Shortcut connections) вуруди ҳар зербахшро бевосита ба баромади он илова мекунанд: (x + F(x)). Бо ин роҳ градиент ҳангоми омӯзиш метавонад аз «роҳи миёнбур» бе тағйир аз қабатҳои зиёд гузарад ва мушкили нестшавии градиент дар шабакаҳои амиқ кам мешавад. Ғайр аз ин, ҳар зербахш маълумоти мавҷударо иваз намекунад, балки ба он «ислоҳот» илова менамояд.
Ҷамъ кардани блок
Ҳоло ҳамаи қисмҳоро ба як блок мепайвандем. Дар GPT-2 ва аксари моделҳои муосир меъёрсозии қабатӣ пеш аз модули таваҷҷуҳ ва пеш аз шабакаи пешрав татбиқ мешавад (Pre-LayerNorm). Дар Transformer-и аслии соли 2017 бошад, меъёрсозӣ пас аз ҷамъ кардани пайвасти боқимонда меомад (Post-LayerNorm). Варианти Pre-LayerNorm моделҳои амиқро устувортар меомӯзонад.
class TransformerBlock(nn.Module):
    def __init__(self, cfg):
        super().__init__()
        self.att = MultiHeadAttention(
            d_in=cfg["emb_dim"], d_out=cfg["emb_dim"],
            context_length=cfg["context_length"],
            num_heads=cfg["n_heads"], dropout=cfg["drop_rate"],
            qkv_bias=cfg["qkv_bias"],
        )
        self.ff = FeedForward(cfg)
        self.norm1 = LayerNorm(cfg["emb_dim"])
        self.norm2 = LayerNorm(cfg["emb_dim"])
        self.drop_shortcut = nn.Dropout(cfg["drop_rate"])

    def forward(self, x):
        # Зербахши таваҷҷуҳ бо пайвасти боқимонда
        shortcut = x
        x = self.norm1(x)
        x = self.att(x)
        x = self.drop_shortcut(x)
        x = x + shortcut

        # Зербахши шабакаи пешрав бо пайвасти боқимонда
        shortcut = x
        x = self.norm2(x)
        x = self.ff(x)
        x = self.drop_shortcut(x)
        x = x + shortcut
        return x
Блок вуруди шакли (batch, num_tokens, emb_dim)-ро қабул карда, баромади ҳамон шаклро бармегардонад. Маҳз барои ҳамин блокҳоро метавон пайи ҳам ба шумораи дилхоҳ ҷойгир кард.
Таваҷҷуҳ ва шабакаи пешрав вазифаҳои гуногун доранд
Ду ҷузъи асосии блок дар амал «тақсими кор» доранд. Муҳаққиқони Донишгоҳи Браун мисоли ҷолибро дар модели 24-қабатаи GPT-2 таҳлил карданд. Ба модел чунин матн дода шуд:
Савол: Пойтахти Фаронса куҷост?
Ҷавоб: Париж.
Савол: Пойтахти Лаҳистон куҷост?
Ҷавоб: …
- Дар 15 қабати аввал беҳтарин пешгӯии модел ҳанӯз ҷавоби муносиб набуд.
- Дар қабатҳои 16–19 калимаи «Лаҳистон» эҳтимоли баландтар гирифт — ҷавоби нодуруст, аммо ба мавзӯъ алоқаманд.
- Дар қабати 20 пешгӯии асосӣ ба «Варшава» иваз шуд ва дар чор қабати охир ҳамин тавр монд.
Муҳаққиқон ин тағйиротро ба амали векторие нисбат доданд, ки номи кишварро ба пойтахти он мепайваст — монанди арифметикаи векторҳои калимаҳо, ки дар боби 2 дидем. Дар ҳамин модел векторҳое низ ёфт шуданд, ки ҳарфҳои хурдро ба калон ё шакли замони ҳозираро ба гузашта табдил медоданд.
Акнун ду мисолро муқоиса кунем:
- дар мисоли «Мэри» модел номро аз худи матн гирифта, барои пур кардани ҷумла истифода кард;
- дар мисоли «Варшава» ин ном дар матн набуд — модел бояд аз дониши ҳангоми омӯзиш азхудкардааш истифода мекард.
Вақте муҳаққиқон бахши пешрави алоқамандро ғайрифаъол карданд, модел дигар «Варшава»-ро дуруст пешгӯӣ накард. Аммо вақте ба аввали матн ҷумлаи «Варшава пойтахти Лаҳистон аст»-ро илова карданд, модели тағйирёфта боз ҷавоби дуруст дод — эҳтимол, ин дафъа таваҷҷуҳ маълумотро аз худи матн гирифт.
Аз ин мисол чунин тақсими корро метавон дид:
- механизми таваҷҷуҳ барои истифодаи маълумоти матни ҷорӣ ёрӣ медиҳад;
- шабакаи пешрав дар истифодаи дониш ва робитаҳои ҳангоми омӯзиш азхудшуда саҳм дорад.
Ба таври ташбеҳӣ, шабакаҳои пешравро метавон ба ҷойи нигоҳдории дониши омӯхташуда монанд кард: қабатҳои аввал робитаҳои содатар (масалан, пайдарпайии «Стив Ҷобс»)-ро коркард мекунанд, қабатҳои баъдӣ — робитаҳои мураккабтар, аз ҷумла робитаи кишвар ва пойтахт. Ин тасвир соддакардашуда аст; масъалаҳои тафсири дохили модел дар боби 15 муфассал баррасӣ мешаванд.
Меъмории пурраи Transformer
Акнун, ки ҷузъҳои асосиро медонем, ба меъмории пурраи Transformer, ки соли 2017 барои тарҷумаи мошинӣ пешниҳод шуда буд, бармегардем. Барои фаҳмидани он фарз мекунем, ки мехоҳем ҷумлаеро аз забони манбаъ ба забони мақсад тарҷума кунем.
Сохтори умумӣ: рамзгузор ва рамзкушо
Модели Transformer аз ду блоки асосӣ иборат аст:
- Рамзгузор (Encoder) — дар тасвирҳои маъмули меъморӣ дар тарафи чап — матни вурудиро қабул карда, аз он намояндагии дохилӣ (Representation) месозад, ки хусусиятҳои (Features) муҳими вурудро дар бар мегирад. Рамзгузор барои фаҳмидани маънои вуруд беҳинасозӣ шудааст.
- Рамзкушо (Decoder) — дар тарафи рост — аз намояндагии сохтаи рамзгузор ва калимаҳои то ин вақт тавлидшуда истифода бурда, пайдарпайии мақсад (Target sequence)-ро тавлид мекунад. Рамзкушо барои тавлиди натиҷа беҳинасозӣ шудааст.
Ҷараёни умумӣ чунин аст: матни вурудӣ → рамзгузор → рамзкушо → натиҷа.
Вобаста ба вазифа, ҳар яке аз ин қисмҳоро мустақилона низ истифода бурдан мумкин аст:
| Навъи меъморӣ | Вазифаҳои мувофиқ |
|---|---|
| Танҳо рамзгузор (Encoder-only) | Вазифаҳое, ки фаҳмидани вурудро талаб мекунанд: таснифи ҷумлаҳо, шинохти номҳои хос (NER) |
| Танҳо рамзкушо (Decoder-only) | Вазифаҳои тавлидӣ, аз ҷумла тавлиди матн |
| Рамзгузор–рамзкушо (Encoder-Decoder) | Тавлиде, ки ба матни вурудӣ вобаста аст: тарҷума, хулосабарорӣ |
Ин се оила (BERT, GPT, T5 ва ғайра) дар боби 5 муфассал баррасӣ мешаванд.
Вуруди шабака: эмбеддинг ва рамзгузории мавқеӣ
Шабакаи нейронӣ танҳо бо ададҳо кор мекунад, бинобар ин матн аввал токенсозӣ шуда, ҳар токен ба эмбеддинг (Embedding) табдил дода мешавад (нигаред ба боби 2).
Аммо дар Transformer воҳиди бозгаштӣ нест ва ҳамаи токенҳо параллелӣ коркард мешаванд. Худи механизми таваҷҷуҳ тартиби токенҳоро «намебинад»: агар калимаҳои ҷумларо ҷобаҷо кунем, холҳои таваҷҷуҳ байни ҷуфтҳои калимаҳо тағйир намеёбанд. Аз ин рӯ, ба шабака бояд маълумот дар бораи мавқеи калима дар ҷумла низ дода шавад. Ин кор бо рамзгузории мавқеӣ (Positional encoding) анҷом мешавад: вектори мавқеъ ба эмбеддинги ҳар калима илова карда мешавад.
Дар Transformer-и аслӣ векторҳои мавқеъ бо функсияҳои синус ва косинус ҳисоб мешаванд: барои ченакҳои ҷуфти вектор синус ва барои ченакҳои тоқ косинус истифода мешавад:
[
PE_{(pos,,2i)} = \sin!\left(\frac{pos}{10000^{2i/d_{\text{model}}}}\right), \qquad
PE_{(pos,,2i+1)} = \cos!\left(\frac{pos}{10000^{2i/d_{\text{model}}}}\right)
]
Дар ин ҷо (pos) — мавқеи токен, (i) — рақами ҷуфти ченакҳо ва (d_{\text{model}}) — андозаи эмбеддинг аст. Ҳар ченак бо басомади худ тағйир меёбад. Инро метавон ба навиштани рақами мавқеъ дар системаи дуӣ монанд кард, ки дар он битҳои поёнӣ зуд ва битҳои болоӣ оҳиста иваз мешаванд. Фарқ дар он аст, ки ба ҷойи 0 ва 1 қиматҳои касрии ҳамвор истифода мешаванд. Агар векторҳои мавқеъро ҳамчун ҷадвал тасаввур кунем, ҳар сатр вектори як мавқеъ ва ҳар сутун як ченак аст. Шарҳи муфассал ва аёниро дар мақолаи Амирҳусейн Кавимнежод метавон ёфт.
Эзоҳ: Рамзгузории синусӣ танҳо яке аз роҳҳост. GPT-2 векторҳои мавқеъро ҳамчун параметрҳои омӯзишпазир меомӯзад (бинобар ин дарозии контексташ маҳдуд аст), ва аксари моделҳои бузурги муосир рамзгузории мавқеии даврзананда (RoPE) ё усулҳои монандро истифода мебаранд, ки мавқеи нисбии токенҳоро бевосита дар ҳисоби таваҷҷуҳ ба назар мегиранд.
Бо илова кардани векторҳои мавқеъ ба эмбеддингҳо вуруди рамзгузор ва рамзкушо омода мешавад.
Рамзгузор
Ҳадафи рамзгузор дарк кардани маънои ҷумла дар забони манбаъ аст. Ҳар қабати рамзгузор ду зербахш дорад:
- Худтаваҷҷуҳии чандсарӣ. Ҳар се вуруди блоки таваҷҷуҳ — дархост, калид ва арзиш — аз як манбаъ, яъне аз ҷумлаи вурудӣ, гирифта мешаванд. Векторҳои калимаҳо аз се қабати хаттӣ бо вазнҳои гуногун гузашта, (Q), (K) ва (V)-ро месозанд, сипас таваҷҷуҳи миқёсбандишуда бо зарби скалярӣ барои ҳар сар ҳисоб мешавад ва баромадҳои сарҳо пайваст шуда, аз қабати хаттии ниҳоӣ мегузаранд. Дар рамзгузор ниқоби сабабӣ нест: таваҷҷуҳ метавонад ба ҳамаи калимаҳои ҷумла, ҳам пеш ва ҳам баъд аз калимаи ҷорӣ, нигоҳ кунад, зеро тарҷумаи як калима метавонад аз ҳарду тараф вобаста бошад.
- Шабакаи пешрав бо функсияи фаъолсозии ReLU (дар Transformer-и аслӣ).
Ҳар зербахш бо пайвасти боқимонда иҳота шудааст ва пас аз он меъёрсозии қабатӣ меояд. Натиҷаи рамзгузор маҷмӯи векторҳои пайваста аст, ки ҳам вурудро ва ҳам маълумоти таваҷҷуҳро рамзгузорӣ кардаанд. Ин векторҳо ба рамзкушо ёрӣ медиҳанд, ки ҳангоми тавлиди ҳар калимаи баромадӣ ба қисмҳои мувофиқи ҷумлаи вурудӣ таваҷҷуҳ кунад. Барои зиёд кардани қобилияти модел чунин қабатҳо пайи ҳам ҷойгир карда мешаванд; дар Transformer-и аслӣ рамзгузор шаш қабат дошт.
Рамзкушо
Ҳадафи рамзкушо сохтани ҷумлаи баромадӣ аст. Дар ҳар қадами вақт он аз баромади рамзгузор ва калимаҳои дар қадамҳои қаблӣ тавлидшуда истифода карда, калимаи навро месозад. Ин раванд то тавлиди нишонаи махсуси ``, ки анҷоми ҷумларо нишон медиҳад, идома меёбад.
Дар вуруди рамзкушо эмбеддинги калимаҳои қаблан тавлидшуда гирифта шуда, ба онҳо векторҳои мавқеъ илова мешаванд. Ҳар қабати рамзкушо се зербахш дорад.
1. Худтаваҷҷуҳии чандсарии ниқобдор (Masked Multi-Head Attention). Мисли рамзгузор, аввал худтаваҷҷуҳӣ истифода мешавад, то модел ҷумлаи то ин вақт тавлидшударо таҳлил кунад. Аммо азбаски рамзкушо баромадро калима ба калима месозад, ҳар калима набояд ба калимаҳои баъд аз худ таваҷҷуҳ кунад. Барои ин, ҳамон ниқоби сабабие, ки дар боло барномарезӣ кардем, истифода мешавад: пас аз миқёсбандии холҳо ва пеш аз softmax ба онҳо матритсае илова мешавад, ки қиматҳояш дар болои диагонали асосӣ ба (-\infty) баробаранд.
Масалан, ҳангоми тарҷумаи ҷумла ба «Ман ба мактаб меравам»:
| Мавқеъ | 1 | 2 | 3 | 4 |
|---|---|---|---|---|
| Калима | Ман | ба | мактаб | меравам |
Ҳангоми пешгӯии калимаи чорум рамзкушо метавонад ба се калимаи аввал таваҷҷуҳ кунад, аммо на ба худи калимаи чорум. Агар модел ҳангоми пешгӯии калимаи мавқеи дуюм аллакай ба худи ҳамин калима дастрасӣ медошт, вазифа беҳуда осон мешуд ва модел чизе намеомӯхт.
Ниқоб махсусан ҳангоми омӯзиш муҳим аст. Барои тез кардани омӯзиш, вақте ки ҷумлаи мақсад маълум аст, тамоми он якбора ба рамзкушо дода мешавад ва пешгӯиҳо барои ҳамаи мавқеъҳо параллелӣ ҳисоб мешаванд. Ниқоб кафолат медиҳад, ки дар ин ҳолат ҳам ҳар мавқеъ танҳо калимаҳои пештараро бинад.
2. Таваҷҷуҳи байнипайдарпайӣ (Cross-attention). Пас аз худтаваҷҷуҳӣ модел бояд ба ҷумлаи вурудӣ низ таваҷҷуҳ кунад. Дар ин блок дархостҳо аз баромади зербахши қаблии рамзкушо, вале калидҳо ва арзишҳо аз баромади рамзгузор гирифта мешаванд. Ин ҳамон ғояи таваҷҷуҳи Баҳданау аст, ки акнун бе RNN амалӣ шудааст. Ба туфайли ин блок рамзкушо ба тамоми ҷумлаи вурудӣ дастрасӣ дорад. Ин хеле муфид аст, зеро забонҳо қоидаҳои грамматикии гуногун доранд: тартиби калимаҳо фарқ мекунад ва маълумоти охири ҷумла метавонад барои тарҷумаи дурусти калимаи аввал зарур бошад.
3. Шабакаи пешрав. Натиҷаи ин марҳилаҳо барои коркарди бештар ба шабакаи пешрав дода мешавад.
Дар ҳамаи зербахшҳо пайвастҳои боқимонда ва меъёрсозии қабатӣ мавҷуданд. Қабатҳои рамзкушо низ пайи ҳам ҷойгир мешаванд; ҳар қабат аз баромади қабати қаблии рамзкушо ва натиҷаи ниҳоии рамзгузор истифода мекунад.
Ниқоби таваҷҷуҳ барои токенҳои пуркунанда
Ғайр аз ниқоби сабабӣ, ниқоби таваҷҷуҳ (Attention mask)-ро дар рамзгузор ва рамзкушо барои он низ истифода мебаранд, ки модел ба баъзе токенҳои махсус таваҷҷуҳ накунад. Масалан, ҳангоми коркарди якчанд ҷумла дар як баста (Batching) ҷумлаҳои кӯтоҳтар бо токени пуркунанда (Padding token) то дарозии ҷумлаи дарозтарин пур карда мешаванд. Ниқоби таваҷҷуҳ холҳои ин мавқеъҳоро ба (-\infty) иваз мекунад, то модел токенҳои пуркунандаро ҳамчун қисми маънодори матн ҳисоб накунад. Дар китобхонаи Hugging Face Transformers ин ниқоб ҳамчун attention_mask (1 — токени воқеӣ, 0 — пуркунанда) ҳамроҳи токенҳо ба модел дода мешавад.
Қабати ниҳоӣ ва тавлиди калима
Пас аз охирин қабати рамзкушо баромад ба як қабати хаттӣ бо функсияи softmax дода мешавад, то калимаи навбатӣ пешгӯӣ шавад. Шумораи нейронҳои ин қабат ба андозаи луғати модел (Vocabulary) баробар аст: барои ҳар токени луғат як адад — логит (Logit) — ҳисоб мешавад ва softmax онҳоро ба эҳтимолиятҳо табдил медиҳад.
Калимаи дар ҳар қадам интихобшуда ба калимаҳои пештара илова шуда, боз ба рамзкушо дода мешавад ва рамзкушо онҳоро барои тавлиди калимаи навбатӣ истифода мебарад. Ин раванд то пайдо шудани нишонаи `` ё расидан ба дарозии ҳадди аксар идома меёбад. Тавлиди калима ҳадафи ниҳоии моделҳои GPT аст: дар ин марҳила модел дониши аз омӯзиш азхудкардаашро барои эҷоди матни пайваста ва аз ҷиҳати дастурӣ дуруст истифода мебарад. Усулҳои интихоби токен аз тақсимоти эҳтимолиятҳо (интихоби бохирс, намунагирӣ, ҳарорат ва ғайра) дар боби 9 баррасӣ мешаванд.
Меъмории GPT
GPT ҳамчун Transformer-и танҳо рамзкушо
Моделҳои GPT (Generative Pretrained Transformer — «Transformer-и тавлидкунандаи пешомӯзишдида») меъмориҳои бузурги шабакаҳои нейронии амиқ мебошанд, ки барои тавлиди матн — ҳар дафъа як токен — тарҳрезӣ шудаанд. Онҳо танҳо қисми рамзкушои Transformer-ро истифода мебаранд ва зербахши таваҷҷуҳи байнипайдарпайиро надоранд: ҳар блок аз худтаваҷҷуҳии чандсарии ниқобдор ва шабакаи пешрав иборат аст — маҳз ҳамон TransformerBlock-е, ки дар боло сохтем.
Бо вуҷуди бузургиашон, меъмории ин моделҳо аз он чи шояд тасаввур кунед, содатар аст, зеро ҷузъҳои он борҳо такрор мешаванд. Акнун андозаи моделро то сатҳи хурдтарин нусхаи GPT-2 бо 124 миллион параметр зиёд мекунем, ки дар мақолаи Рэдфорд ва ҳамкоронаш «Language Models are Unsupervised Multitask Learners» — «Моделҳои забонӣ омӯзандагони бисёрвазифаи беназорат мебошанд» тавсиф шудааст. Дар гузориши аслӣ шумораи параметрҳо 117 миллион зикр шуда буд, аммо баъдтар ин рақам ислоҳ гардид. Нусхаҳои калонтари GPT-2 345, 762 ва 1 542 миллион параметр доранд ва бо ҳамин меъморӣ, танҳо бо андозаҳои калонтар, сохта мешаванд.
Параметрҳо дар омӯзиши амиқ вазнҳои омӯзишпазири модел мебошанд — тағйирёбандаҳои дохилие, ки ҳангоми омӯзиш танзим мешаванд, то қимати функсияи хато кам гардад. Масалан, агар қабати шабака бо матритсаи вазнҳои андозааш (2,048 \times 2,048) ифода шавад, ҳар унсури он як параметр аст ва қабат дар маҷмӯъ
[
2,048 \times 2,048 = 4,194,304
]
параметр дорад.
Танзимоти модели хурди GPT-2-ро бо луғати зерини Python муайян мекунем:
GPT_CONFIG_124M = {
    "vocab_size": 50257,     # Андозаи луғат
    "context_length": 1024,  # Дарозии контекст
    "emb_dim": 768,          # Андозаи embedding
    "n_heads": 12,           # Шумораи сарҳои таваҷҷуҳ
    "n_layers": 12,          # Шумораи блокҳои Transformer
    "drop_rate": 0.1,        # Меъёри dropout
    "qkv_bias": False        # Bias дар қабатҳои Query, Key ва Value
}
vocab_size— андозаи луғати токенсози BPE, ки 50 257 токен дорад (нигаред ба боби 2);context_length— шумораи ҳадди аксари токенҳои вурудӣ, ки модел тавассути эмбеддингҳои мавқеӣ коркард карда метавонад;emb_dim— андозаи эмбеддинг: ҳар токен ба вектори 768-ченака табдил дода мешавад;n_heads— шумораи сарҳо дар таваҷҷуҳи чандсарӣ;n_layers— шумораи блокҳои Transformer дар модел;drop_rate— шиддати dropout: 0.1 маънои тасодуфан ғайрифаъол кардани 10 фоизи воҳидҳоро дорад;qkv_bias— оё дар қабатҳоиLinear-и дархост, калид ва арзиш вектори иловагии bias истифода шавад. Бо пайравӣ аз моделҳои муосир онро ғайрифаъол мекунем; аммо агар хоҳед вазнҳои аслии GPT-2-ро ба ин модел бор кунед, онро бояд фаъол кунед (True), зеро GPT-2 ин bias-ро дорад.
Бо ин танзимот тамоми моделро аз ҷузъҳои сохташуда ҷамъ мекунем: эмбеддинги токенҳо ва мавқеъҳо, dropout, 12 блоки Transformer, меъёрсозии қабатии ниҳоӣ ва қабати баромад, ки логитҳоро барои ҳамаи токенҳои луғат ҳисоб мекунад:
class GPTModel(nn.Module):
    def __init__(self, cfg):
        super().__init__()
        self.tok_emb = nn.Embedding(cfg["vocab_size"], cfg["emb_dim"])
        self.pos_emb = nn.Embedding(cfg["context_length"], cfg["emb_dim"])
        self.drop_emb = nn.Dropout(cfg["drop_rate"])
        self.trf_blocks = nn.Sequential(
            *[TransformerBlock(cfg) for _ in range(cfg["n_layers"])]
        )
        self.final_norm = LayerNorm(cfg["emb_dim"])
        self.out_head = nn.Linear(cfg["emb_dim"], cfg["vocab_size"], bias=False)

    def forward(self, in_idx):
        batch_size, seq_len = in_idx.shape
        tok_embeds = self.tok_emb(in_idx)
        pos_embeds = self.pos_emb(torch.arange(seq_len, device=in_idx.device))
        x = self.drop_emb(tok_embeds + pos_embeds)
        x = self.trf_blocks(x)
        x = self.final_norm(x)
        return self.out_head(x)  # (batch, seq_len, vocab_size)
Баромади модел барои ҳар мавқеъ вектори логитҳо бо андозаи луғат аст. Модели навсохта вазнҳои тасодуфӣ дорад ва матни бемаъно тавлид мекунад; ғояи омӯзиши он дар боби 6 баррасӣ мешавад.
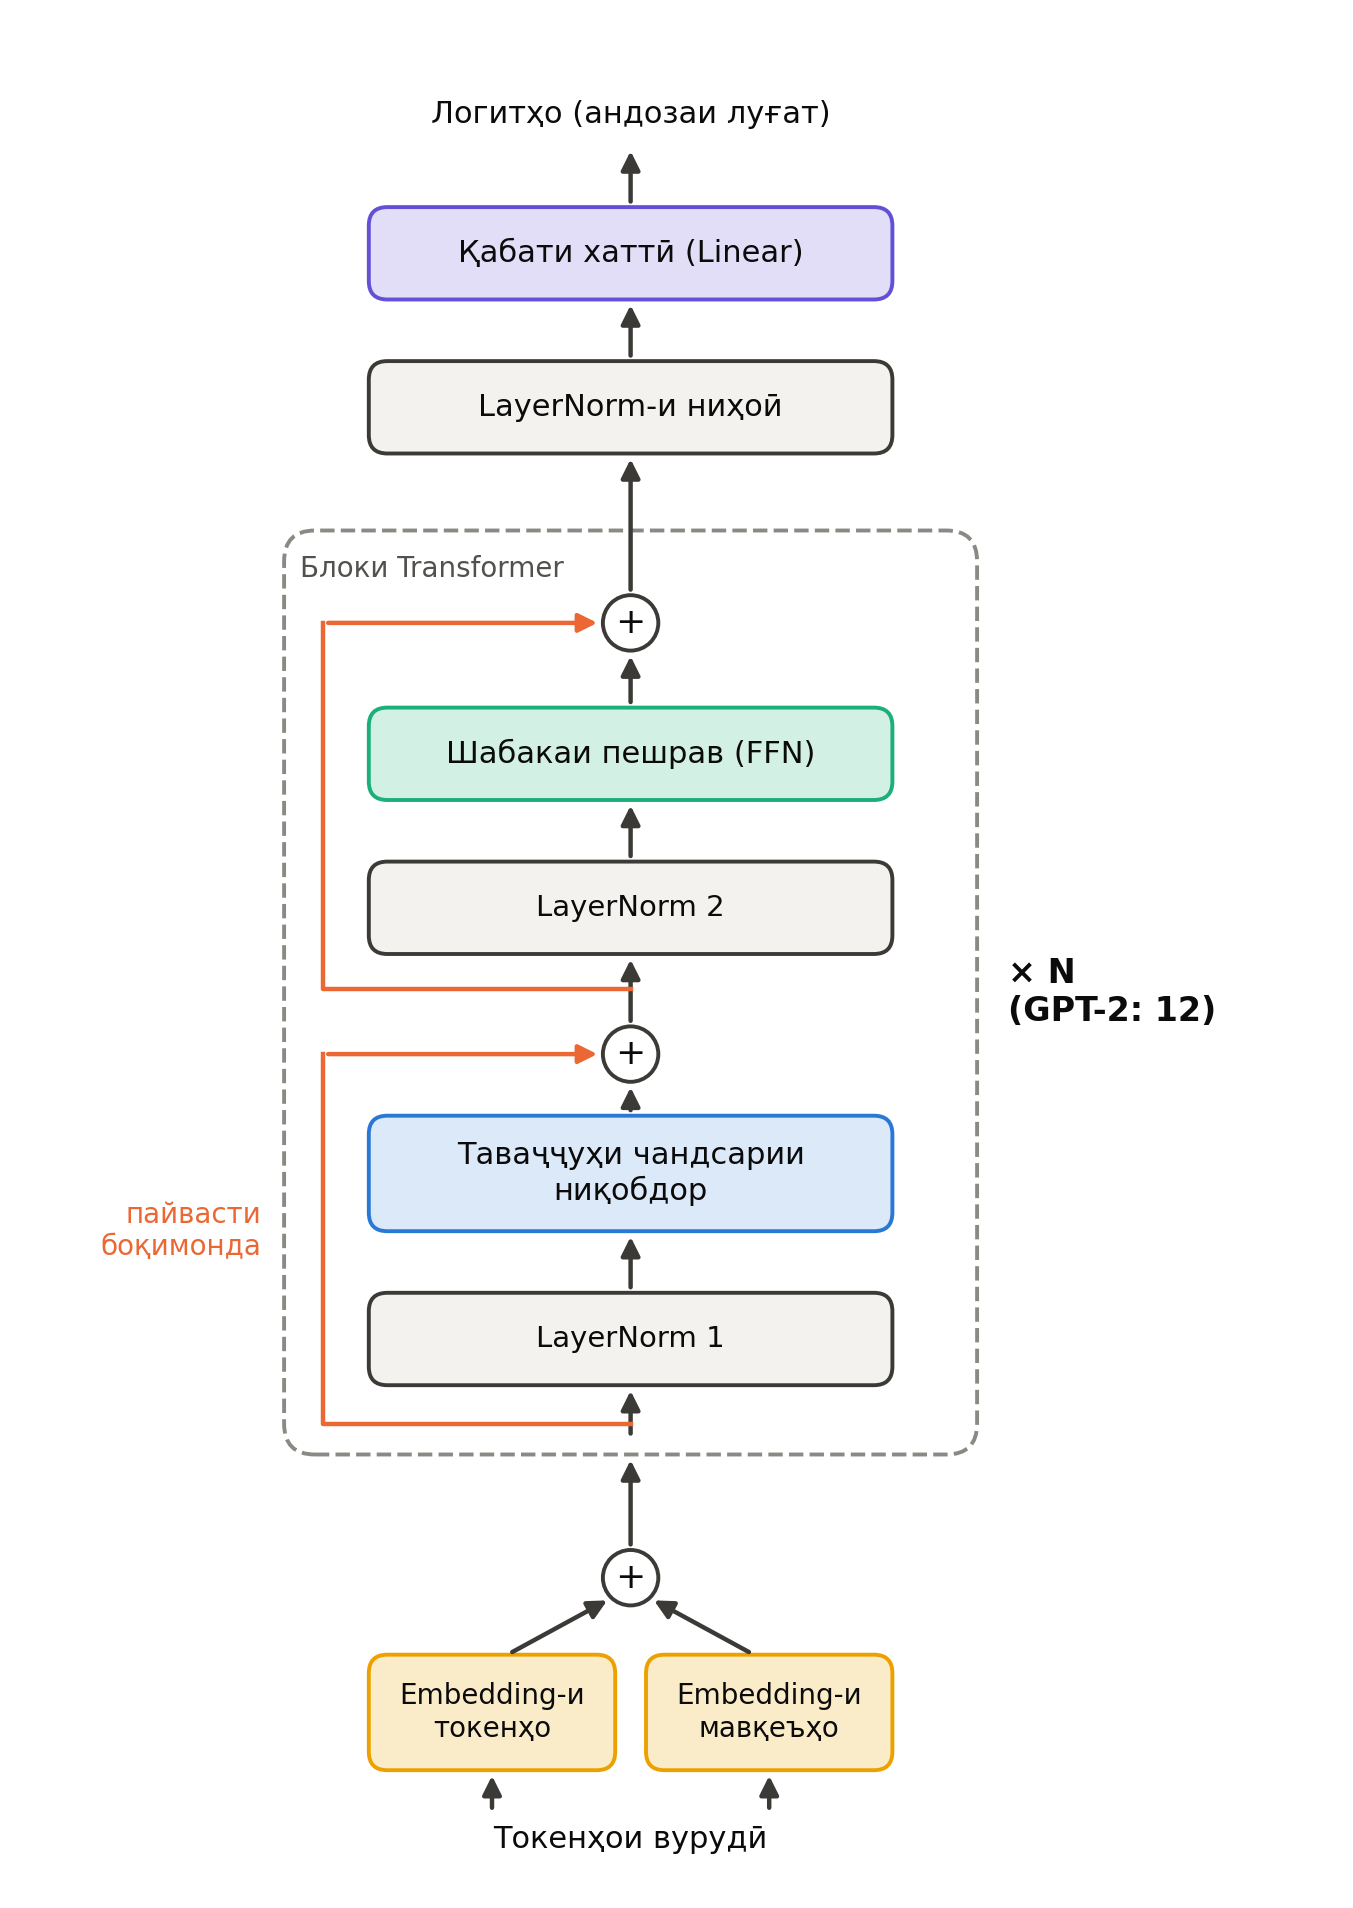
Расми 4.4. Сохтори модели GPT: эмбеддинги токенҳо ва мавқеъҳо ҷамъ шуда, аз (N) блоки Transformer (Pre-LayerNorm: LayerNorm → таваҷҷуҳи чандсарии ниқобдор → ҷамъ бо пайвасти боқимонда → LayerNorm → шабакаи пешрав → ҷамъ) мегузаранд; сипас LayerNorm-и ниҳоӣ ва қабати хаттӣ логитҳоро барои ҳамаи токенҳои луғат ҳисоб мекунанд. Dropout барои соддагӣ нишон дода нашудааст.
Эзоҳ: GPT-2-и аслӣ вазнҳои қабати эмбеддинги токенҳоро дар қабати баромад такроран истифода мебарад (Weight tying), бинобар ин шумораи параметрҳои синфи боло, ки қабати баромади алоҳида дорад, аз 124 миллион бештар мешавад.
GPT-2 дар муқоиса бо GPT-3
GPT-2 барои омӯзиш интихоби хуб аст, зеро OpenAI вазнҳои пешомӯзишдидаи онро ба таври оммавӣ дастрас кардааст ва онро метавон дар як ноутбук иҷро кард. Аз ҷиҳати меъморӣ GPT-3 ба GPT-2 хеле монанд аст. Фарқи асосӣ дар миқёс аст: шумораи параметрҳо аз 1,5 миллиард дар GPT-2 то 175 миллиард дар GPT-3 зиёд шуд ва GPT-3 бо маълумоти хеле бештар омӯзонида шудааст.
GPT-3 барои омӯзиш ва ҳатто иҷрои пешгӯӣ ба маҷмӯи GPU-ҳо ниёз дорад. Тибқи ҳисобҳои Lambda Labs, омӯзиши GPT-3 бо як GPU-и маркази додаҳои V100 тақрибан 355 сол ва бо як GPU-и RTX 8000 тақрибан 665 сол вақт мегирифт.
Эзоҳ: Вазнҳои GPT-3 то ҳол ба таври оммавӣ нашр нашудаанд. Аммо имрӯз моделҳои кушодавазни зиёде (аз ҷумла моделҳои кушодавазни худи OpenAI, ки соли 2025 нашр шуданд) мавҷуданд, ки аз ҷиҳати сифат аз GPT-3 хеле болотаранд ва бо ҳамин меъмории асосии танҳо рамзкушо, бо такмилҳое чун RoPE, RMSNorm, SwiGLU ва Grouped-Query Attention, сохта шудаанд.
Меъморӣ, нуқтаи назоратӣ ва модел
Ҳангоми кор бо моделҳои Transformer (масалан, дар китобхонаи Hugging Face) се истилоҳи ба ҳам наздик вомехӯранд, ки маънои каме гуногун доранд:
- Меъморӣ (Architecture) — сохтори асосӣ ё «скелет»-и модел: аз кадом қабатҳо иборат аст ва дар дохили он кадом амалҳо иҷро мешаванд. Синфи
GPTModel-и боло меъморӣ аст. - Нуқтаи назоратӣ (Checkpoint) — маҷмӯи вазнҳои омӯзонидашуда (Trained weights), ки ба меъмории муайян бор карда мешаванд. Меъморӣ сохторро муайян мекунад, нуқтаи назоратӣ — параметрҳои омӯхташударо.
- Модел (Model) — истилоҳи умумитар, ки метавонад ҳам ба меъморӣ ва ҳам ба нуқтаи назоратӣ ишора кунад. Аз ин рӯ, он камтар дақиқ аст; дар ҷойҳое, ки фарқ муҳим аст, беҳтар аст истилоҳҳои «меъморӣ» ва «нуқтаи назоратӣ»-ро истифода барем.
Масалан, BERT номи меъморӣ аст, аммо bert-base-cased нуқтаи назоратӣ аст — маҷмӯи вазнҳое, ки гурӯҳи Google барои нашри аввали BERT омӯзонида буд. Дар гуфтори умумӣ ҳам «модели BERT» ва ҳам «модели bert-base-cased» гуфтан қобили қабул аст, аммо аз ҷиҳати техникӣ аввалӣ ба меъморӣ ва дуввумӣ ба вазнҳои мушаххас ишора мекунад.
Хулоса
- Моделҳои рамзгузор–рамзкушои RNN тамоми ҷумларо дар як вектори контексти андозааш собит ҷой медоданд, ки барои ҷумлаҳои дароз боиси гум шудани маълумот мешуд. Механизми таваҷҷуҳ ба модел имкон медиҳад, ки дар ҳар қадам ба қисмҳои мувофиқи вуруд бевосита дастрасӣ дошта бошад.
- Ҳар механизми таваҷҷуҳ аз дархост, калид ва арзиш иборат аст: дархост бо калидҳо муқоиса шуда, холҳо ҳосил мешаванд, softmax онҳоро ба вазнҳо табдил медиҳад ва вектори контекст ҳамчун ҷамъи вазндори арзишҳо ҳисоб мешавад.
- Таваҷҷуҳи Баҳданау (2014) ин ғояро дар RNN амалӣ кард; худтаваҷҷуҳӣ робитаҳоро дар дохили як пайдарпайӣ ҳисоб мекунад; Transformer (2017) RNN-ро пурра бо таваҷҷуҳ иваз карда, коркарди параллелиро имконпазир сохт.
- Дар Transformer таваҷҷуҳи миқёсбандишуда бо зарби скалярӣ истифода мешавад: (\operatorname{softmax}(QK^{\top}/\sqrt{d_k})V), ки дар он (Q), (K), (V) бо матритсаҳои вазни омӯзишпазир аз вуруд ҳосил мешаванд.
- Ниқоби сабабӣ холҳои токенҳои ояндаро ба (-\infty) иваз мекунад, то модели тавлидкунанда «ба оянда нигоҳ накунад»; dropout дар вазнҳои таваҷҷуҳ аз мутобиқшавии аз ҳад зиёд пешгирӣ мекунад.
- Таваҷҷуҳи чандсарӣ якчанд сари таваҷҷуҳро параллелӣ иҷро мекунад, то ҳар сар навъи дигари робитаро омӯзад; онро бо зарби бастаии матритсаҳо самаранок барномарезӣ кардан мумкин аст.
- Блоки Transformer аз таваҷҷуҳи чандсарӣ ва шабакаи пешрав (бо GELU ё SwiGLU) иборат аст, ки ҳар кадом бо меъёрсозии қабатӣ ва пайвасти боқимонда иҳота шудааст. Таваҷҷуҳ асосан маълумотро аз матни ҷорӣ интиқол медиҳад, шабакаи пешрав бошад, бештари параметрҳо ва дониши азхудшударо дар бар мегирад.
- Transformer-и аслӣ аз рамзгузор ва рамзкушо иборат аст; вуруди он эмбеддингҳо бо рамзгузории мавқеӣ аст; рамзкушо худтаваҷҷуҳии ниқобдор ва таваҷҷуҳи байнипайдарпайӣ ба баромади рамзгузор дорад; қабати ниҳоӣ эҳтимоли ҳар токени луғатро ҳисоб мекунад. Ниқоби таваҷҷуҳ инчунин токенҳои пуркунандаро пинҳон мекунад.
- GPT Transformer-и танҳо рамзкушо аст; GPT-2 ва GPT-3 як меъморӣ доранд ва асосан бо миқёс фарқ мекунанд.
- Меъморӣ сохтори модел, нуқтаи назоратӣ вазнҳои омӯхташуда ва модел истилоҳи умумии ҳардуи онҳост.
Дар боби 5 се оилаи асосии моделҳои бар Transformer асосёфта — танҳо рамзгузор, танҳо рамзкушо ва рамзгузор–рамзкушо — ва истифодаи онҳо дар амал баррасӣ мешаванд.
Манбаъҳо
Ин боб қисман дар асоси манбаъҳои зерин таҳия шудааст:
- Raschka, S. (2024). Build a Large Language Model (From Scratch). Manning. Коди китоб: https://github.com/rasbt/LLMs-from-scratch — барномарезии худтаваҷҷуҳӣ, таваҷҷуҳи чандсарӣ, блоки Transformer ва модели GPT.
- Lee, T. B., Trott, S. (2023). Large language models, explained with a minimum of math and jargon. Understanding AI. https://www.understandingai.org/p/large-language-models-explained-with — мисоли «John wants his bank to cash the …».
 Барномасозӣ
 Олами Афсонаҳо
 Ахбор
 Саломатӣ
 Дунё