Омӯзиши моделҳои бузурги забонӣ (LLM)
Китоби омӯзишӣ дар бораи моделҳои бузурги забонӣ (LLM) ба забони тоҷикӣ: аз мафҳумҳои аввалия то усулҳои муосир. Токенсозӣ ва векторҳо, шабакаҳои нейронӣ, механизми таваҷҷуҳ ва Transformer, оилаҳои моделҳо, омӯзиши пешакӣ, танзими дақиқ ва LoRA, мутобиқсозӣ (RLHF, DPO), тавлиди матн, муҳандисии промпт, RAG, агентҳо, самаранокӣ, арзёбӣ ва бехатарӣ, тафсирпазирӣ ва истифодаи LLM барои забони тоҷикӣ. Бо мисолҳои код дар Python ва PyTorch, замимаҳои математика ва луғати истилоҳот.
Агенти Зеҳнӣ · 13 октябри 2026 · 18 саҳифа · 2 писанд
Боби 6. Омӯзиши пешакӣ ва қонунҳои миқёспазирӣ
Ҳар модели бузурги забонӣ роҳи худро аз омӯзиши пешакӣ (Pre-training) оғоз мекунад. Дар ин марҳила модел бо ҳаҷми азими матн рӯ ба рӯ мешавад ва аз он қоидаҳои забон, далелҳо дар бораи ҷаҳон ва тарзи ба ҳам пайвастани калимаҳоро меомӯзад. Маҳз ҳамин марҳила аз ҳама гаронтар аст ва асоси тамоми қобилиятҳои ояндаи моделро мегузорад.
Дар ин боб меомӯзем:
- омӯзиши пешакӣ чист ва чаро модели пешакӣ омӯзонидашуда ҳанӯз ёвари хуб нест;
- модел аз кадом додаҳо ва бо кадом ҳадаф (пешгӯии токени навбатӣ) меомӯзад;
- омӯзиш чӣ гуна сурат мегирад: гузариши мустақим ва паҳншавии баръакси хато;
- миқёс чӣ нақш дорад: параметрҳо, ҳисоббарорӣ, додаҳо ва қонунҳои миқёспазирӣ (Scaling Laws);
- қобилиятҳои зуҳуркунанда (Emergent Abilities) чистанд;
- чаро моделҳои бузурги забонӣ ин қадар хуб кор мекунанд;
- аз кӯшишҳои бозсозии GPT-3 чӣ дарсҳо гирифта шуданд;
- кай модели бузург лозим аст ва кай модели хурди танзимшуда беҳтар аст.
Омӯзиши пешакӣ чист?
Дар марҳилаи омӯзиши пешакӣ ба шабака ҳаҷми хеле зиёди додаҳо дода мешавад, то модел на танҳо қоидаҳои забонро омӯзад, балки дар бораи ҷаҳон ва тарзи ба ҳам пайвастани калимаҳо низ дониши васеъ пайдо кунад.
Аммо модели танҳо пешакӣ омӯзонидашуда ҳанӯз ёд нагирифтааст, ки мушовири хуб бошад ва ба саволҳои шумо ҷавоб диҳад. Масалан, вақте мепурсед: «Номат чист?», мехоҳед ҷавоб диҳад: «ChatGPT». Модели пешакӣ омӯзонидашуда бошад метавонад матнро танҳо идома диҳад — масалан, саволи навбатиро илова кунад.
Ба истилоҳ, дар ин марҳила модел ҳанӯз бо ҳадафҳои инсон ҳамоҳанг нест. Хушбахтона, моделҳои пешакӣ омӯзонидашударо метавон роҳнамоӣ кард: гарчанде онҳо дар оғоз ба дастурҳо хуб ҷавоб намедиҳанд, метавон ба онҳо ин корро омӯзонд. Ин кор тавассути танзими дақиқ (Fine-tuning) дар боби 7 ва ҳамоҳангсозӣ (Alignment) дар боби 8 баррасӣ мешавад.
Додаҳо ва ҳадафи омӯзиш: пешгӯии токени навбатӣ
Бисёр алгоритмҳои пешинаи омӯзиши мошинӣ ба додаҳое ниёз доштанд, ки инсон онҳоро нишонагузорӣ карда бошад. Масалан, барои омӯзонидани шинохти гурба ва саг бояд ба ҳар акс нишонаи «гурба» ё «саг» дода мешуд. Нишонагузории чунин маҷмӯаҳои бузург гарон ва вақтталаб буд.
Яке аз хусусиятҳои муҳими омӯзиши пешакии моделҳои забонӣ он аст, ки матн худаш ҷавоби омӯзиширо фароҳам мекунад. Модел қисми матнро мегирад ва кӯшиш мекунад токени навбатиро пешгӯӣ кунад. Токени воқеии навбатӣ дар ҳамон матн мавҷуд аст, бинобар ин барои ҳар намуна ҷавоби дастии инсон лозим намешавад. Чунин равишро омӯзиши худназоратӣ (Self-supervised Learning) меноманд.
Саҳифаҳои Википедия, мақолаҳои хабарӣ, китобҳо ва коди барномаҳо метавонанд барои чунин омӯзиш истифода шаванд. Масалан, модел бо гирифтани ҷумлаи нопурраи зерин метавонад «шакар»-ро пешгӯӣ кунад:
Ман қаҳваамро бо қаймоқ ва … менӯшам.
Сифат ва гуногунии ин додаҳо барои натиҷаи ниҳоӣ ҳалкунанда аст. Дар бахши «Дарсҳо аз бозсозии GPT-3» мебинем, ки филтр кардани матнҳои пастсифат, ҳазфи такрорҳо ва гуногунии манбаъҳо чӣ қадар муҳиманд.
Омӯзиш чӣ гуна сурат мегирад?
Моделе, ки нав оғоз шудааст, одатан пешгӯии хуб надорад. Вазнҳои он дар оғоз қиматҳои ибтидоии тасодуфӣ доранд. Бо дидани намунаҳои зиёд вазнҳо тадриҷан тағйир меёбанд ва пешгӯӣ беҳтар мешавад.
Ташбеҳи шири об
Тасаввур кунед, ки мехоҳед бо оби ширгарм душ гиред. Шири обро пештар истифода накардаед ва рӯи он нишона нест.
Дастаро ба як тараф мегардонед ва ҳарорати обро месанҷед. Агар об хеле гарм бошад, танзимро тағйир медиҳед. Агар хеле сард бошад, ба самти дигар мегардонед. Ҳар қадар ба ҳарорати муносиб наздик шавед, тағйиротро хурдтар мекунед.
Омӯзиши модел низ ба ҳамин ғоя монанд аст: натиҷаро мегирем, хатогиро месанҷем ва параметрҳоро тағйир медиҳем.
Акнун тасаввур кунед, ки ба ҷойи як шири об 50 257 баромадгоҳ дорем (ин андозаи луғати токенҳои GPT-2 ва GPT-3 аст). Ҳар баромадгоҳ ба токени муайян алоқаманд аст. Ҳадаф ин аст, ки ҷараёни асосии об ба баромадгоҳи токени дуруст равона шавад.
Дар паси баромадгоҳҳо шабакаи мураккаби қубурҳо ва клапанҳо ҷойгир аст. Агар об ба ҷойи нодуруст равад, танҳо тағйир додани як дастак кофӣ нест — бояд фаҳмид, ки кадом клапанҳо ба натиҷа таъсир расондаанд. Тасаввур кунед, ки гурӯҳи санҷобҳои ҳушманд қубурҳоро аз охир ба аввал пайгирӣ мекунанд ва ҳар клапанро каме танзим менамоянд. Дар шабакаи нейронӣ ҳамин кор тавассути ҳисобҳои риёзӣ анҷом мешавад.
Гузариши мустақим ва паҳншавии баръакси хато
Бахшҳои модел — аз сарҳои таваҷҷуҳ то шабакаҳои пешрав (ниг. боби 4) — аз амалҳои риёзӣ, аз ҷумла зарби матритсаҳо, иборатанд. Рафтори онҳо ба параметрҳои вазнӣ вобаста аст.
Ҳар қадами омӯзиш ду марҳилаи асосӣ дорад:
- Гузариши мустақим (Forward Pass): модел вурудро коркард мекунад ва пешгӯӣ медиҳад. Сипас хатои пешгӯӣ (функсияи хато) ҳисоб мешавад.
- Паҳншавии баръакси хато (Backpropagation): таъсири ҳар параметр ба хатогӣ ҳисоб карда мешавад, то муайян гардад, ки вазнҳо барои беҳтар кардани натиҷа чӣ гуна навсозӣ шаванд.
Дар ташбеҳи мо гузариши мустақим ба кушодани об ва дидани натиҷа монанд аст. Паҳншавии баръакси хато ба пайгирии қубурҳо барои муайян кардани клапанҳои таъсиргузор монанд мебошад.
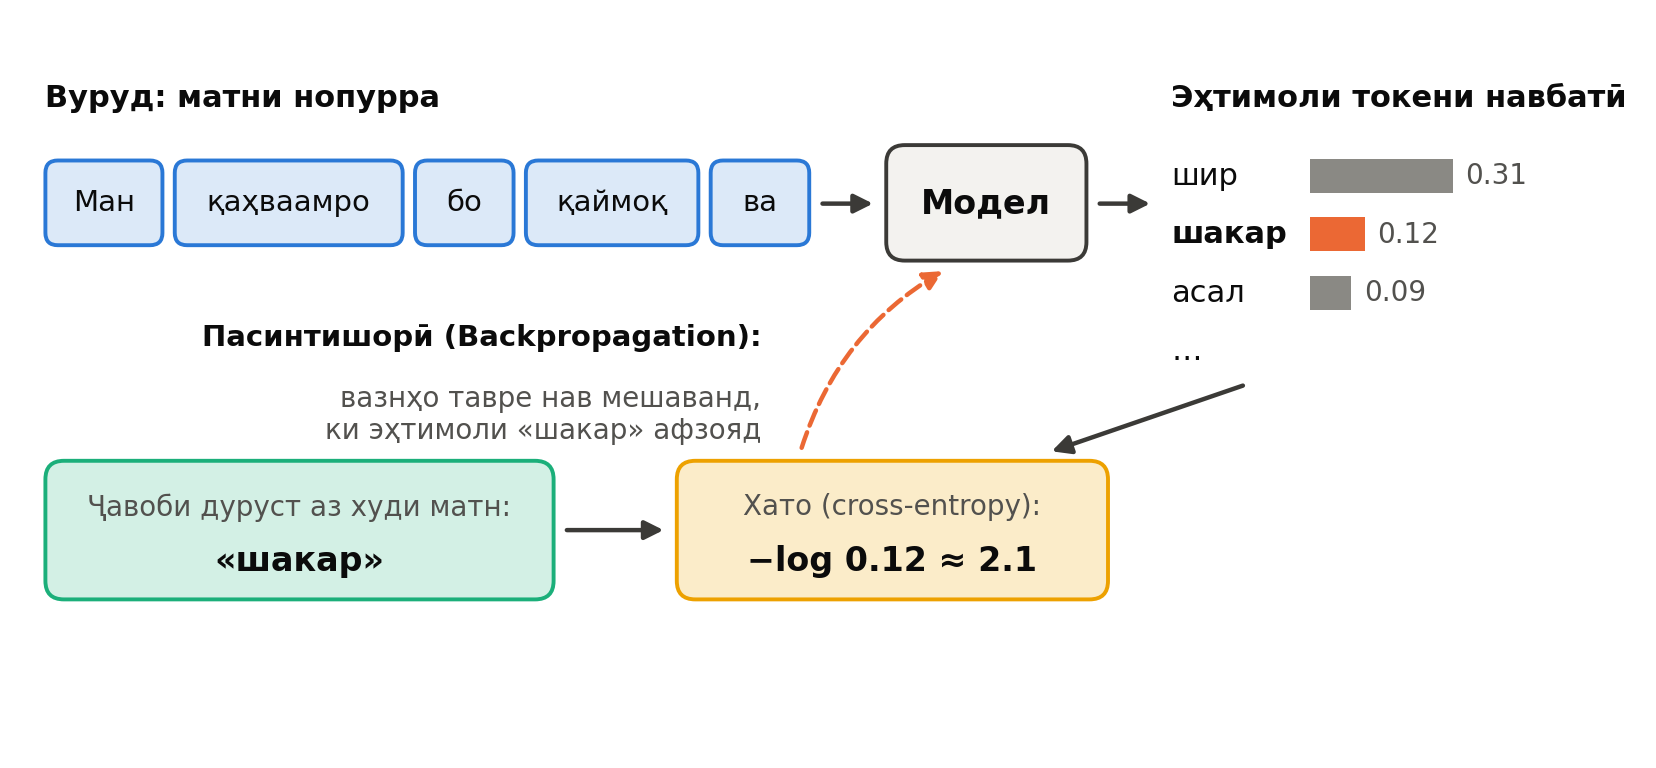
Расми 6.1. Як қадами омӯзиш дар мисоли «Ман қаҳваамро бо қаймоқ ва … менӯшам»: модел ба токени дуруст («шакар») эҳтимоли пастро медиҳад, хато ҳисоб мешавад ва паҳншавии баръакси хато вазнҳоро тағйир медиҳад. Рақамҳо тасвирӣ мебошанд.
Барои модели бузург иҷрои чунин ҳисобҳо хеле гарон аст. Омӯзиш ҳамчунин такрори ин равандро дар шумораи азими намунаҳо — садҳо миллиард ва ҳатто триллионҳо токен — талаб мекунад.
Миқёс: параметрҳо, ҳисоббарорӣ ва додаҳо
Бо афзоиши андозаи модел, ҳаҷми додаҳои муносиб ва захираҳои ҳисоббарорӣ иҷрои бисёр вазифаҳои забонӣ беҳтар шудааст. Мисолҳо аз оилаи GPT:
- GPT-1 (2018): 12 қабат, векторҳои 768-ченака, тақрибан 117 миллион параметр.
- GPT-3 (2020): дар версияи бузургтарин 96 қабат, векторҳои 12 288-ченака ва 175 миллиард параметр.
- GPT-4 (2023): андозаи он ошкор нашудааст, аммо дар бисёр вазифаҳо, аз ҷумла вазифаҳои ниёзманд ба муҳокимаронии абстрактӣ, натиҷаҳои хеле беҳтар нишон дод.
Тасаввур кардани шумораи намунаҳое, ки модел мебинад, душвор аст. GPT-3 бо тақрибан 300 миллиард токен аз корпуси тақрибан 500-миллиардтокенӣ омӯзиш гирифт. Барои муқоиса, кӯдак то 10-солагӣ бо шумораи хеле камтари калимаҳо — тахминан даҳҳо миллион — рӯ ба рӯ мешавад.
Қонунҳои миқёспазирӣ
Пешрафти моделҳо тасодуфӣ нест. Муҳаққиқон дарёфтанд, ки сифати модели забонӣ ба се омил бо қонуниятҳои хеле устувор вобаста аст:
- (N) — шумораи параметрҳои модел;
- (D) — шумораи токенҳои омӯзишӣ;
- (C) — ҳаҷми ҳисоббарорӣ (дар FLOP), ки барои трансформер тахминан (C \approx 6ND) аст.
Ин вобастагиҳоро қонунҳои миқёспазирӣ (Scaling Laws) меноманд.
Kaplan ва ҳамкорон (OpenAI, 2020) нишон доданд, ки талафоти модел (Loss) ҳангоми зиёд кардани (N), (D) ё (C) мувофиқи қонуни дараҷагӣ (Power Law) кам мешавад: ҳар маротиба афзун кардани захираҳо беҳбудии пешгӯишаванда медиҳад, гарчанде ин беҳбудӣ тадриҷан суст мешавад. Аз хулосаҳои онҳо чунин бармеомад, ки ҳангоми зиёд шудани буҷети ҳисоббарорӣ андозаи моделро нисбат ба ҳаҷми додаҳо тезтар бояд зиёд кард. Аз ҳамин сабаб моделҳои он давра (GPT-3, Gopher ва ғайра) хеле калон буданд, вале бо додаҳои нисбатан кам омӯзонда мешуданд.
Hoffmann ва ҳамкорон (DeepMind, 2022) ин хулосаро ислоҳ карданд. Дар таҳқиқоти маъруф ба Chinchilla онҳо нишон доданд, ки барои буҷети муайяни ҳисоббарорӣ шумораи параметрҳо ва шумораи токенҳоро бояд тақрибан ба як андоза зиёд кард. Қоидаи амалии ҳосилшуда: барои омӯзиши аз ҷиҳати ҳисоббарорӣ беҳин (Compute-optimal) тақрибан 20 токен ба ҳар параметр лозим аст. Модели Chinchilla бо 70 миллиард параметр ва тақрибан 1,4 триллион токен аз модели Gopher бо 280 миллиард параметр, ки бо ҳамон буҷети ҳисоббарорӣ омӯзонда шуда буд, беҳтар баромад.
Шакли маъмули қонуни Chinchilla чунин аст:
[
L(N, D) = E + \frac{A}{N^{\alpha}} + \frac{B}{D^{\beta}}
]
Дар ин ҷо (E) — талафоти ногузир (энтропияи худи забон), (A, B, \alpha, \beta) — коэффитсиентҳое, ки аз таҷриба ҳосил мешаванд. Ду ҷузъи охир нишон медиҳанд, ки норасоии параметрҳо ва норасоии додаҳо ҳар кадом ба таври алоҳида сифатро маҳдуд мекунанд.
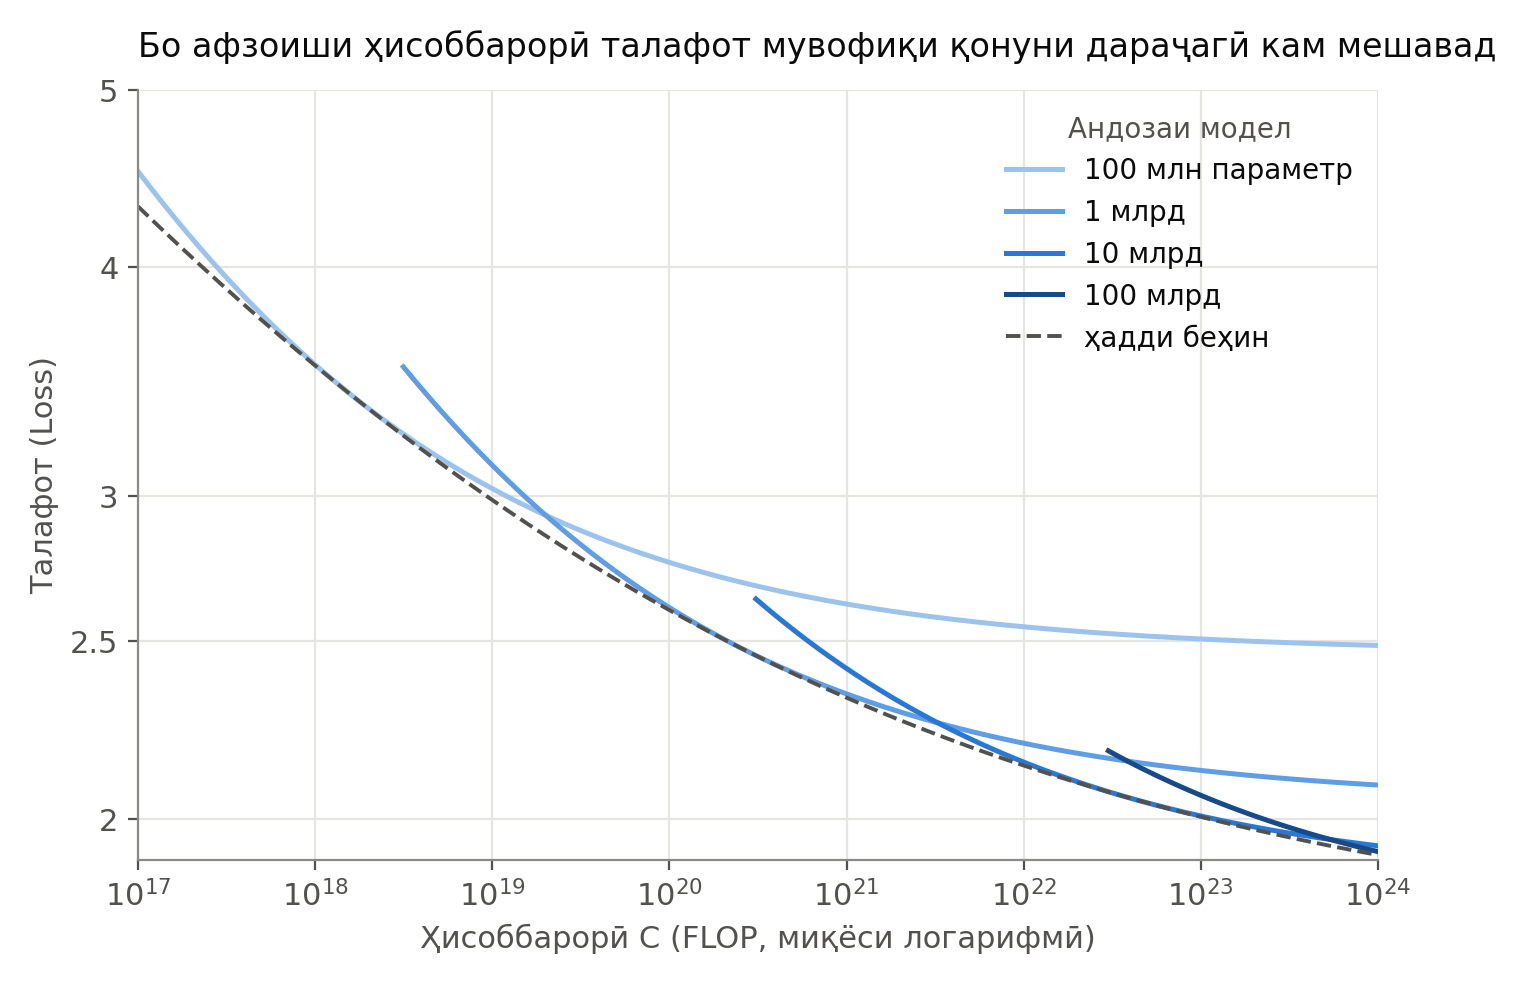
Расми 6.2. Талафоти моделҳои андозаҳои гуногун вобаста ба ҳисоббарорӣ, ки бо формулаи Chinchilla ва коэффитсиентҳои мақолаи Hoffmann ва ҳамкорон (2022) ҳисоб шудааст. Талафоти ҳар модели андозаи собит дар ниҳоят қариб кам шуданро бас мекунад; хати рахдор ҳадди беҳинро барои ҳар буҷет нишон медиҳад. Расм тасвирӣ аст, на натиҷаи таҷрибаи воқеӣ.
Эзоҳ: Қоидаи «20 токен ба параметр» танҳо хароҷоти омӯзиш-ро беҳин мекунад. Дар амал модел пас аз омӯзиш миллионҳо маротиба истифода мешавад ва модели хурдтар дар истифода арзонтар аст. Аз ин рӯ, бисёр моделҳои кушодаи муосир (масалан, оилаҳои Llama ва Qwen) бо токенҳои хеле бештар аз ҳадди Chinchilla — баъзан садҳо токен ба ҳар параметр — омӯзонда мешаванд.
Қобилиятҳои зуҳуркунанда
Қонунҳои миқёспазирӣ коҳиши ҳамвори талафотро тавсиф мекунанд. Аммо дар баъзе вазифаҳои мушаххас манзара дигар аст: модели хурд вазифаро умуман иҷро карда наметавонад, вале пас аз гузаштан аз андозаи муайян ногаҳон қобилияти нав пайдо мешавад. Чунин қобилиятҳоро қобилиятҳои зуҳуркунанда (Emergent Abilities) меноманд.
Мисоли маъруф модели PaLM-и Google аст:
- Ҳангоми гузариш аз модели 8-миллиардпараметрӣ ба 62-миллиардпараметрӣ ва сипас ба 540-миллиардпараметрӣ, дар вазифаҳои BIG-Bench беҳбудиҳои ғайрипайваста ба вуҷуд омаданд, ки аз пешгӯиҳои одии қонуни миқёспазирӣ зиёдтар буданд.
- PaLM-540B бо панҷ намуна дар промпт дар 44 вазифа аз 58 вазифаи умумии BIG-Bench аз натиҷаҳои беҳтарини қаблии few-shot пеш гузашт ва натиҷаи ҷамъбастии он аз натиҷаи миёнаи инсон баландтар буд.
- Дар ҳафт вазифаи андешаронии чандқадамӣ, аз ҷумла ҳисоб ва андешаронӣ бар асоси дониши рӯзмарра, промпти занҷираи андешаронӣ (Chain-of-Thought, CoT) бо ҳашт намуна дар чор вазифа аз моделҳои беҳтарини танзимшуда пеш гузашт ва дар се вазифаи дигар қариб ба онҳо баробар шуд. Ин муваффақият ҳам аз андозаи модел ва ҳам аз худи CoT (ниг. боби 10) бармеояд.
Эзоҳ: Табиати қобилиятҳои зуҳуркунанда баҳсбарангез аст. Баъзе таҳқиқот (масалан, Schaeffer ва ҳамкорон, 2023) нишон доданд, ки қисми ин «ҷаҳишҳо» аз интихоби меъёри арзёбӣ вобаста аст: агар ба ҷойи меъёри «дуруст/нодуруст» меъёри ҳамвортар истифода шавад, беҳбудӣ аксар вақт тадриҷӣ менамояд. Бо вуҷуди ин, аз нуқтаи назари амалӣ модели калонтар воқеан вазифаҳоеро иҷро мекунад, ки модели хурд аз уҳдааш намебарояд.
Чаро моделҳои бузурги забонӣ ин қадар хуб кор мекунанд?
Шояд пурсед: чӣ гуна пешгӯии токени навбатӣ метавонад ба навиштани мақола, барномасозӣ ва ҳалли масъала оварда расонад? Яке аз сабабҳои асосӣ — ҳаҷм ва гуногунии додаҳо ва андозаи модел, ки дар боло дидем. Аммо мисолҳои зерин нишон медиҳанд, ки натиҷаи ин миқёс то чӣ андоза ғайричашмдошт буда метавонад.
Мисоли «назарияи зеҳн»
Ба ин қисса диққат диҳед:
Як халта пур аз ҷуворимаккаи бодкардашуда аст ва дар он шоколад нест. Аммо рӯи халта «Шоколад» навишта шудааст. Сара халтаро меёбад. Ӯ пештар онро надидааст ва намедонад, ки дарунаш чист. Сара навиштаҷоти рӯи халтаро мехонад.
Мо эҳтимол мегӯем, ки Сара гумон мекунад дар халта шоколад аст. Вақте дарунашро бинад, ҳайрон мешавад.
Қобилияти муҳокимаронӣ дар бораи бовар, дониш ва ҳолати равонии дигаронро равоншиносон назарияи зеҳн (Theory of Mind) меноманд.
Равоншиноси Донишгоҳи Стэнфорд Михал Косински қобилияти моделҳои забониро дар чунин масъалаҳо таҳқиқ кард. Ӯ ба моделҳо қиссаҳои монанд дода, хоҳиш кард ҷумлаи зеринро пур кунанд:
Ӯ фикр мекунад, ки халта пур аз … аст.
Ҷавоби мувофиқ «шоколад» аст. Аммо модели заифтар метавонад «ҷуворимаккаи бодкардашуда»-ро интихоб кунад, зеро ин муҳтавои воқеии халта мебошад.
Дар озмоишҳои Косински GPT-1 ва GPT-2 натиҷаи хуб надоштанд. Версияи аввали GPT-3 тақрибан 40 дарсади саволҳоро дуруст ҷавоб дод, версияи баъдии он ба тақрибан 90 дарсад ва GPT-4 ба тақрибан 95 дарсад расид.
Косински пешниҳод кард, ки чунин натиҷаҳо шояд ҳамчун паёмади беҳтар шудани қобилиятҳои забонӣ пайдо шудаанд, на аз он сабаб, ки муҳаққиқон назарияи зеҳнро бевосита ба модел ворид карда бошанд.
Аммо ҳамаи муҳаққиқон ин тафсирро қабул намекунанд. Баъзе тағйироти хурд дар матни масъалаҳо натиҷаҳои моделро хеле бадтар мекунанд. Аз ин рӯ, муваффақият дар як маҷмӯаи саволҳо ҳанӯз далели қатъии доштани қобилияти инсонмонанди фаҳмиши зеҳни дигарон нест. Баъзеҳо ин ҳолатро ба қиссаи «Ҳанси ҳушманд» монанд мекунанд: аспе, ки зоҳиран масъалаҳои ҳисобиро ҳал мекард, аммо дар асл аз ишораҳои ноогоҳонаи одамон истифода мебурд.
Бо вуҷуди ин, чунин натиҷаҳо нишон медиҳанд, ки моделҳо метавонанд вазифаҳоеро иҷро кунанд, ки чанд сол пеш барои онҳо дастнорас менамуданд.
Расмкашӣ тавассути код
Муҳаққиқони Microsoft дар таҳқиқоте оид ба GPT-4 намунаҳои гуногуни қобилиятҳои онро баррасӣ карданд. Дар яке аз озмоишҳо аз модел хоҳиш карданд, ки бо забони тасвирсозии TikZ як аспи якшохро тасвир кунад. Модел чанд сатри код навишт ва ҳангоми иҷрои код тасвири сода, вале шинохташавандаи аспи якшох ба даст омад.
Муҳаққиқон эҳтимол доданд, ки модел коди тайёреро аз додаҳои омӯзишӣ ба хотир овардааст. Барои санҷиш онҳо кодро тағйир доданд: шохро бардоштанд ва ҷойи баъзе қисмҳои баданро дигар карданд. Сипас аз модел хоҳиш карданд шохро дубора илова кунад. Модел онро дар мавқеи мувофиқ ҷойгир кард.
Версияи дар ин озмоиш истифодашуда танҳо аз додаҳои матнӣ омӯзиш гирифта буд. Аз ин рӯ, мисол барои муҳаққиқон ҷолиб буд: модел тавассути матн ва код баъзе робитаҳои фазоии шаклҳоро азхуд карда буд.
Фаҳмиши воқеӣ ё такрори қолабҳо?
Дар бораи маънои чунин қобилиятҳо баҳс идома дорад. Баъзе муҳаққиқон мегӯянд, ки моделҳо тасвирҳои дохилии муфиде аз маъно ва робитаҳои ҷаҳон месозанд. Дигарон онҳоро «тӯтиҳои эҳтимолӣ» (Stochastic Parrots) меноманд ва таъкид мекунанд, ки модел метавонад пайдарпайии мураккаби калимаҳоро бе фаҳмиши инсонмонанд тавлид кунад.
Ин баҳс ҷанбаи фалсафӣ ҳам дорад. Аммо аз нуқтаи назари амалӣ муҳим аст, ки натиҷаҳои моделро бо озмоишҳои дуруст арзёбӣ кунем (ниг. боби 14). Агар модел ба як навъи савол пайваста ҷавоби дуруст диҳад ва мутмаин бошем, ки ҳамон саволҳоро дар омӯзиш надидааст, ин дастоварди муҳим мебошад.
Пешгӯии забон ва омӯхтани робитаҳои ҷаҳон
Яке аз сабабҳои эҳтимолии самаранокии пешгӯии токени навбатӣ он аст, ки забон дорои қонуниятҳо мебошад. Қонуниятҳои забон аксар вақт, ҳарчанд на ҳамеша, ба қонуниятҳои ҷаҳони воқеӣ алоқаманданд. Аз ин рӯ, вақте модел робитаи калимаҳоро меомӯзад, метавонад баъзе робитаҳои байни ашё, ҳодисаҳо ва амалҳоро низ азхуд кунад.
Ғояи пешгӯӣ танҳо ба зеҳни сунъӣ маҳдуд нест. Файласуфоне мисли Энди Кларк пешниҳод мекунанд, ки мағзи инсонро низ метавон ҳамчун «мошини пешгӯӣ» баррасӣ кард: низоме, ки муҳити атрофро пешгӯӣ намуда, барои амал кардан аз ин пешгӯиҳо истифода мебарад.
Барои пешгӯии хуб тасвири дохилии муносиб лозим аст — масалан, бо харитаи дақиқ роҳро осонтар меёбед, на бо харитаи нодуруст.
Дар сохтани моделҳои забонӣ яке аз мушкилоти асосӣ ин буд, ки калимаҳоро чӣ гуна ифода кунем, махсусан вақте маънои онҳо ба матни атроф вобаста аст (ниг. боби 2). Омӯзиш тавассути пешгӯии токени навбатӣ ба муҳаққиқон имкон дод, ки ин масъалаи назариявиро ба вазифаи таҷрибавӣ табдил диҳанд. Модел бо дидани додаҳои зиёд ва навсозии параметрҳо ифодаҳоеро меомӯзад, ки барои пешгӯӣ муфиданд, ва дар ҳамин раванд қолабҳо ва робитаҳои зиёди забони инсонро азхуд мекунад.
Дарсҳо аз бозсозии GPT-3
Қонунҳои миқёспазирӣ мегӯянд, ки «бузургтар — беҳтар». Аммо таҷрибаи солҳои 2022–2023 нишон дод, ки танҳо андоза кофӣ нест. Дар он давра чанд кӯшиши оммавӣ барои бозсозии GPT-3 анҷом дода шуд ва аксари онҳо ба натиҷаи дилхоҳ нарасиданд. Таҳлили ин «нокомиҳо» дарсҳои муҳиме дар бораи омӯзиши пешакӣ медиҳад.
Кадом кӯшишҳо «ноком» ҳисоб мешуданд?
Дар ин ҷо «нокомӣ» маънои онро дорад, ки модел, бо вуҷуди доштани андозаи монанд ё ҳатто бузургтар, ба натиҷаҳои дар мақолаи аслии GPT-3 гузоришшуда намерасид.
- Аз рӯи ин меъёр, GPT-3 ва PaLM-и 540-миллиардпараметрӣ муваффақ буданд, аммо ҳар ду модел дастраси умум набуданд.
- Моделҳои оммавии он давра, масалан OPT-175B (Meta) ва BLOOM-176B (BigScience), то андозае «ноком» ҳисоб мешуданд.
- Мақолаҳои OPT-175B ва GLM-130B иддао мекарданд, ки дар баъзе вазифаҳо ба GPT-3 баробар шудаанд ё аз он пеш гузаштаанд, аммо ин иддао барои маҷмӯи васеътари вазифаҳо баҳсбарангез буд. Тибқи таҷрибаи аксари корбарон ва натиҷаҳои арзёбии HELM, API-и GPT-3 аз чунин моделҳои кушода хеле беҳтар кор мекард.
- Версияҳои бо дастурҳо танзимшудаи OPT ва BLOOM — OPT-IML ва BLOOMZ — низ аз InstructGPT ва FLAN-PaLM (PaLM-и бо дастурҳо танзимшуда) хеле ақиб мемонданд.
Агар ҷомеаи кушода борҳо танзимоти гуногунро месанҷид, эҳтимол дар ниҳоят GPT-3-ро бозсозӣ мекард. Аммо хароҷот хеле баланд буд: як даври омӯзиши чунин модел истифодаи тақрибан 1 000 GPU-и A100 бо хотираи 80 ГБ-ро барои ҳадди ақал ду моҳ талаб мекард.
Сабабҳои эҳтимолии натиҷаи заифтари OPT-175B ва BLOOM-176B-ро метавон ба ду гурӯҳ ҷудо кард: маълумоти пешомӯзиш ва стратегияи омӯзиш.
Маълумоти пешомӯзиш
GPT-3 бо 300 миллиард токен омӯзиш гирифт. Тақрибан 60 фоизи он аз Common Crawl-и филтршуда буд; қисмҳои дигар WebText2 (корпуси омӯзиши GPT-2), Books1, Books2 ва Википедияро дар бар мегирифтанд. Версияҳои баъдии GPT-3 бо маълумоти код, масалан аз GitHub, низ омӯзиш гирифтанд. Ҳиссаи ҳар манбаъ ба андозаи аслии он мутаносиб набуд: маълумоти босифат бештар интихоб мешуд.
Се нукта ҷамъоварии маълумоти монандро барои ҷомеаи кушода душвор мегардонд.
Филтр кардани маълумоти пастсифат
Ҳангоми сохтани корпусҳои GPT-3 ва PaLM гурӯҳбандии махсус (Classifier) барои ҷудо ва хориҷ кардани маълумоти пастсифат истифода шуд, аммо OPT ва BLOOM ин корро накарданд. Баъзе таҳқиқот нишон доданд, ки пешомӯзиш бо миқдори камтари маълумоти босифат метавонад аз омӯзиш бо миқдори хеле бештари маълумоти дорои сифати омехта натиҷаи беҳтар диҳад. Аммо гуногунӣ низ муҳим аст, бинобар ин тавозуни байни сифат ва гуногуниро бояд бодиққат интихоб кард.
Ҳазфи такрорҳо
Такрорзудоӣ (Deduplication) пешгирӣ мекунад, ки модел як намунаро борҳо бинад ва онро аз ёд кунад ё ба он аз ҳад зиёд мутобиқ шавад. Ин қобилияти умумисозиро беҳтар мекунад.
GPT-3, PaLM ва OPT такрорҳоро дар сатҳи ҳуҷҷат ҳазф карданд. Аммо, тавре дар мақолаи OPT зикр шудааст, дар корпуси The Pile, ки OPT истифода мекард, ҳатто баъд аз ин қадам такрорҳои зиёде боқӣ монданд. Ҷолиб аст, ки баъзе таҳқиқоти он давра нишон доданд: шояд ҳазфи такрорҳо барои пешгирии мутобиқшавии аз ҳад зиёд он қадар муҳим набошад, ки қаблан гумон мекарданд.
Гуногунии маълумот
Гуногунӣ соҳаҳои гуногун, шаклҳои гуногуни маълумот (матн, код, ҷадвал) ва забонҳои гуногунро дар бар мегирад.
- Муаллифони корпуси The Pile (OPT) иддао мекарданд, ки он гуногунии бештар дорад.
- Корпуси ROOTS (BLOOM) маҷмӯаҳои илмии аз ҳад зиёд дошт ва аз маълумоти гуногуни Common Crawl камтар баҳра мебурд. Ин метавонад ба натиҷаи заифтари BLOOM оварда расонда бошад.
- GPT-3 ҳиссаи хеле бештари маълумоти гуногун ва умумимавзӯии Common Crawl дошт. Эҳтимол ин ҳам яке аз сабабҳоест, ки GPT-3 ба заминаи ChatGPT табдил ёфт.
Тақсимоти мушаххаси маълумот ба натиҷаи модел дар вазифаҳои мушаххас таъсири калон мерасонад:
- BLOOM ва PaLM ҳиссаи бештари маълумоти чандзабона доранд, ки ба натиҷаи беҳтари онҳо дар вазифаҳои чандзабона ва тарҷумаи мошинӣ мусоидат мекунад.
- OPT маълумоти зиёди гуфтугӯӣ (масалан, аз Reddit) дорад, ки метавонад сабаби натиҷаи хуби он дар муколама бошад.
- PaLM ҳиссаи зиёди гуфтугӯҳои шабакаҳои иҷтимоӣ дорад, ки метавонад ба натиҷаи беҳтари он дар саволу ҷавоб мусоидат кунад.
- PaLM ва версияҳои баъдии GPT-3 маълумоти зиёди код доранд. Ин қобилияти барномасозиро зиёд мекунад ва эҳтимол қобилияти занҷираи андешарониро низ беҳтар месозад.
Аммо BLOOM, бо вуҷуди доштани маълумоти код, дар барномасозӣ ва CoT заиф буд. Яъне танҳо мавҷудияти код дар корпус ин қобилиятҳоро кафолат намедиҳад.
Хулоса, се омили калидии маълумот инҳоянд: ҳазфи такрорҳо барои пешгирии азёдкунӣ, филтр барои сифат ва гуногунӣ барои умумисозӣ. Мутаассифона, ҷузъиёти пешкоркард ва худи маълумоти PaLM ва GPT-3 ошкор нашуд, ки бозсозии онҳоро душвор мекард.
Стратегияи омӯзиш
Стратегияи омӯзиш чаҳорчӯбаи омӯзишӣ, давомнокӣ, меъмории модел, танзимоти омӯзиш ва тағйирот дар ҷараёни омӯзишро дар бар мегирад. Ҳадаф — устуворӣ ва расидан ба ҳамгароӣ ҳангоми омӯзиши моделҳои хеле бузург.
Дар пешомӯзиши моделҳои бузург ҷаҳишҳои ногаҳонии функсияи хато (Loss Spikes) ва дуршавӣ аз ҳамгароӣ бисёр мушоҳида мешаванд, ва сабабҳои онҳо аксар вақт норӯшананд. Барои кам кардани ин мушкилот тағйироти зиёде пешниҳод шудаанд. Мақолаи GPT-3 ошкоро нагуфтааст, ки ин мушкил чӣ гуна ҳал шуд, аммо роҳҳои дар OPT ва BLOOM истифодашуда беҳтарин набуданд.
Чаҳорчӯбаи омӯзиш ва дақиқияти ададҳо
Модели дорои беш аз 175 миллиард параметр одатан ба параллелизми маълумот бо усули ZeRO (беҳинасози тақсимшуда) ва параллелизми модел ниёз дорад. Параллелизми модел параллелизми тензорӣ, қубурӣ ва баъзан пайдарпайиро дар бар мегирад.
- OPT аз ZeRO дар FSDP ва параллелизми модели Megatron-LM истифода кард.
- BLOOM аз ZeRO дар DeepSpeed ва параллелизми модели Megatron-LM истифода кард.
- PaLM аз Pathways — низоми параллелизми модел ва маълумот бар асоси TPU — истифода кард.
- Ҷузъиёти низоми омӯзиши GPT-3 маълум нест; танҳо маълум аст, ки ягон шакли параллелизми модел истифода шудааст (баъзеҳо гуфтаанд, ки аз Ray).
Таҷҳизот ва низомҳои гуногун метавонанд падидаҳои гуногун ба вуҷуд оранд; танзимоте, ки барои TPU дар PaLM кор кард, шояд барои GPU мувофиқ набошад.
Масъалаи хеле муҳим — истифодаи формати bfloat16 барои вазнҳо ва фаъолсозиҳо. bfloat16 доираи васеътари ададҳоро ифода мекунад ва ҳангоми ҷаҳишҳои талафот қиматҳои калонро беҳтар идора менамояд.
- Дар TPU bfloat16 интихоби пешфарз аст — шояд яке аз сабабҳои муваффақияти PaLM.
- Дар GPU қаблан бештар аз float16 истифода мешуд; дар V100 он ягона интихоб барои омӯзиши дақиқияти омехта буд. OPT аз float16 истифода кард, ки метавонад яке аз омилҳои ноустувории он бошад.
- BLOOM дар ниҳоят дар GPU-ҳои A100 ба bfloat16 гузашт, аммо меъёрсозии қабатии иловагиро пас аз қабати аввали эмбеддинг, ки дар таҷрибаҳои float16 барои устуворӣ гузошта шуда буд, нигоҳ дошт. Нишон дода шудааст, ки ин меъёрсозӣ умумисозиро дар ҳолати бе намуна (Zero-shot) бадтар мекунад.
Тағйирот дар ҷараёни омӯзиш
OPT дар миёнаи омӯзиш танзимоти зиёдеро тағйир дод ва омӯзишро аз нуқтаҳои назоратии охирин аз нав оғоз кард:
- меъёри маҳдудкунии градиент ва суръати омӯзиш тағйир дода шуд;
- аз Adam ба SGD-и одӣ ва сипас боз ба Adam гузаштанд;
- омили динамикии миқёсбандии талафот аз нав танзим шуд;
- ба версияи навтари Megatron гузаштанд.
Чунин тағйирот эҳтимол яке аз сабабҳои нокомии OPT буданд. Дар муқоиса, PaLM қариб ягон тағйироти миёнаи омӯзиш накард. Он танҳо омӯзишро аз нуқтаи назоратие, ки тақрибан 100 қадам пеш аз ҷаҳиши талафот буд, аз нав оғоз мекард ва тақрибан 200–500 бастаи маълумотро мегузаронд. Ин оғози дубораи сода муваффақ мешуд, эҳтимол бо сабаби такрорпазирии дақиқ дар сатҳи битҳо (Bitwise Determinism), тартиби муайяни интихоби намунаҳо ва тағйироти меъморие, ки дар поён оварда шудаанд.
Меъмории модел ва танзимоти омӯзиш
Барои устувортар кардани омӯзиш PaLM чанд тағйирот ворид кард:
- версияи тағйирёфтаи Adafactor ҳамчун беҳинасоз;
- миқёсбандии логитҳои баромад пеш аз softmax;
- функсияи ёрирасони талафот барои наздик нигоҳ доштани меъёркунандаи softmax ба сифр;
- усулҳои гуногуни қиматгузории ибтидоӣ барои вазнҳо ва эмбеддингҳо;
- истифода накардани bias дар қабатҳои зич ва меъёрсозии қабатӣ;
- истифода накардани dropout дар пешомӯзиш.
GLM-130B низ дарсҳои арзишманд дошт, масалан истифодаи Post-LN бар асоси DeepNorm ба ҷойи Pre-LN ва кам кардани градиенти қабати эмбеддинг. Аксари ин тағйирот дар OPT ва BLOOM истифода нашуданд.
Давомнокии омӯзиш
Шумораи токенҳое, ки GPT-3 ҳангоми пешомӯзиш дид, ба OPT ва BLOOM монанд буд, аммо PaLM токенҳои хеле бештар дид. Корпусҳои PaLM ва GPT-3 низ аз корпусҳои BLOOM ва OPT калонтар буданд.
| Модел | Токенҳои корпуси пешомӯзиш | Токенҳои дидашуда ҳангоми пешомӯзиш |
|---|---|---|
| PaLM | 780 миллиард | 770 миллиард |
| GPT-3 | 500 миллиард | 300 миллиард |
| OPT | 180 миллиард | 300 миллиард |
| BLOOM | 341 миллиард | 366 миллиард |
Омӯзиш бо токенҳои бештар аз корпуси калонтару босифат метавонад омили муҳими муваффақияти GPT-3 ва PaLM бошад. Ин бо хулосаи Chinchilla низ мувофиқ аст: ҳамаи моделҳои ҷадвал аз нуқтаи назари қонунҳои миқёспазирӣ бо додаҳои хеле кам (тақрибан 1–2 токен ба параметр, ба ҷойи ~20) омӯзонда шуда буданд.
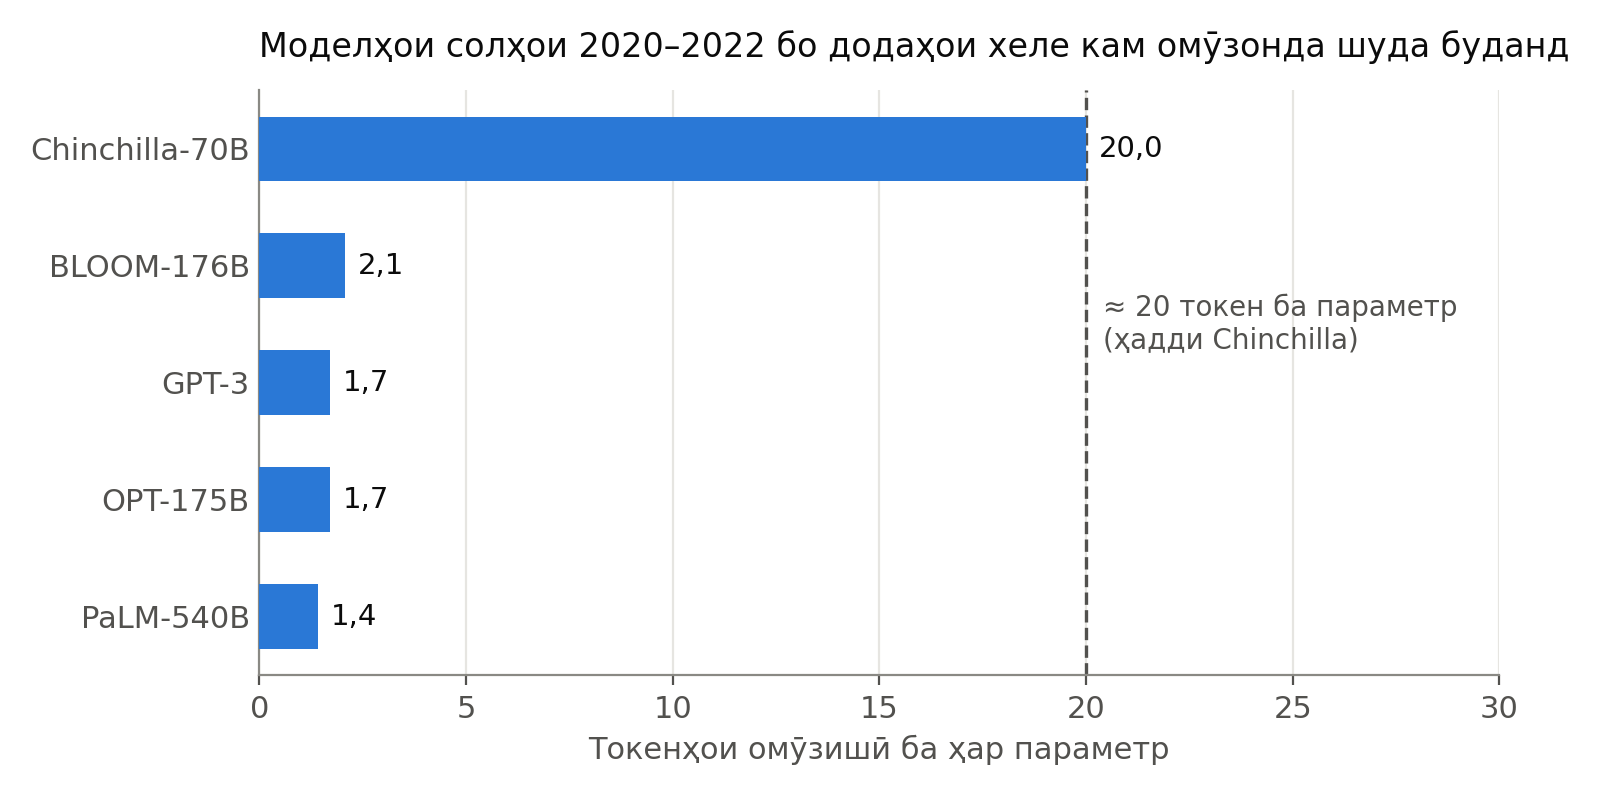
Расми 6.3. Шумораи токенҳои омӯзишӣ ба ҳар параметр: моделҳои ҷадвали боло ва Chinchilla (70 миллиард параметр, тақрибан 1,4 триллион токен). Хати рахдор — қоидаи «20 токен ба параметр».
Омилҳои дигар
- PaLM ва GPT-3 андозаи бастаҳоро (Batch Size) дар ҷараёни омӯзиш тадриҷан аз хурд ба калон зиёд мекарданд, ки муфид будани он нишон дода шудааст; OPT ва BLOOM андозаи собит доштанд.
- OPT аз функсияи фаъолсозии ReLU, PaLM аз SwiGLU, GPT-3 ва BLOOM аз GELU истифода мекарданд. Ду функсияи охир одатан натиҷаи беҳтар медиҳанд.
- Барои пайдарпайиҳои дароз PaLM аз RoPE ва BLOOM аз ALiBi истифода мекарданд, аммо GPT-3 ва OPT эмбеддингҳои мавқеии омӯзишпазир доштанд.
Эзоҳ: Аксари ин дарсҳо имрӯз ба таҷрибаи стандартӣ табдил ёфтаанд: bfloat16, RoPE, SwiGLU, филтр ва ҳазфи бодиққати такрорҳо дар моделҳои кушодаи муосир маъмуланд. Пас аз соли 2023 моделҳои кушода (Llama, Qwen, Gemma, DeepSeek ва дигарон) на танҳо ба сатҳи GPT-3, балки дар бисёр вазифаҳо ба сатҳи моделҳои пӯшидаи пешсаф наздик шуданд.
Кай модели бузург ва кай модели хурди танзимшуда?
Модели пешакӣ омӯзонидашударо бо ду роҳи асосӣ барои вазифаи мушаххас истифода бурдан мумкин аст:
- промптдиҳӣ ба модели бузург (дар он давра GPT-3, GPT-3.5, InstructGPT, PaLM ё FLAN-PaLM; ниг. боби 10);
- танзими дақиқи модели хурдтар, баъзан бо меъмории махсус (масалан, T5 ё FLAN-T5; ниг. боби 7).
Аз нуқтаи назари илмӣ муқоисаи танзими дақиқи модели бузург бо промптдиҳӣ ба ҳамон модел одилонатар аст. Аммо барои корбар муқоисаи модели хурди танзимшуда бо промптдиҳӣ ба модели бузург аҳамияти бештар дорад. Ҷолиб аст, ки танзими дақиқи худи PaLM-540B дар баъзе вазифаҳо танҳо беҳбудии маҳдуд медод, ки саволро ба миён меовард: оё танзими модели хеле бузург меарзад?
Таҳлили зер бо муқоисаи беҳтарин натиҷаҳои моделҳои хурди танзимшуда бо беҳтарин натиҷаҳои моделҳои бузург дар солҳои 2022–2023 сохта шудааст. Меъёри асосӣ дақиқӣ аст, аммо ҳангоми қабули қарор ҷанбаҳои дигар — заҳрнокии муҳтаво, одилона будани натиҷаҳо ва ғайра (ниг. арзёбии HELM ва боби 14) — низ бояд ба назар гирифта шаванд.
Чанд эзоҳи муҳим:
- ChatGPT ҳамчун чатбот хуб кор мекунад, зеро махсус барои муколама мутобиқ шудааст. Барои доираи васеътари вазифаҳо одатан моделҳои заминавии он — GPT-3, InstructGPT/GPT-3.5 ва Codex — истифода мешуданд.
- Бо зиёд шудани маълумоти пешомӯзиши монанд ба вазифаи мақсад, танзими дастурӣ ё омӯзиши тақвиятӣ бо бозхӯрди инсон (RLHF, ниг. боби 8) моделҳо дар вазифаҳои мақсад беҳтар мешаванд. Аммо баъзан ин беҳбудӣ бо коҳиши қобилият дар вазифаҳои дигар ҳамроҳ аст — «хароҷоти ҳамоҳангсозӣ» (Alignment Tax), ки дар InstructGPT мушоҳида шуд.
- Муайян кардан душвор аст, ки модел воқеан умумисозӣ мекунад ё намунаҳои санҷиширо ҳангоми пешомӯзиш дидааст. То чӣ андоза ин азёдкунӣ мушкили ҷиддӣ аст, баҳсбарангез мебошад. Корбарон, бар хилофи муҳаққиқон, одатан ба ин аҳамият намедиҳанд, агар модел дар маълумоти онҳо хуб кор кунад.
Эзоҳ: Хулосаҳои ин бахш ба версияҳои моделҳои солҳои 2022–2023 асос ёфтаанд. Моделҳои муосир дар бисёр вазифаҳое, ки дар поён ҳамчун «заиф» қайд шудаанд (масалан, NLU, андешаронӣ ва тарҷума), хеле беҳтар шудаанд. Аммо мантиқи умумии интихоб — арзиш, таъхир, махфият ва мувофиқати вазифа — то имрӯз эътибор дорад.
Ҳолатҳое, ки модели бузург мувофиқтар аст
Бисёре аз ин ҳолатҳо аз аввал ҳадафҳои мақолаи GPT-3 буданд.
Вазифаҳои эҷодӣ ва мураккаби тавлидӣ
- барномасозӣ: пурра кардани код, табдили дастурҳои забони табиӣ ба код, тарҷумаи код ва ислоҳи хатоҳо;
- хулосасозӣ;
- тарҷума;
- навиштани эҷодӣ: ҳикоя, мақола, почтаи электронӣ, гузориш ва беҳтар кардани матн.
GPT-3 барои вазифаҳое тарҳрезӣ шуда буд, ки тамғагузории онҳо душвор ё ғайриимкон аст. Баъзе аз ин вазифаҳо бо моделҳои қаблии танзимшуда амалан дастнорас буданд. Масалан, таҳқиқот нишон доданд, ки хулосаҳои моделҳои бузург метавонанд аз хулосаҳои омодакардаи инсон беҳтар бошанд. Промптдиҳӣ ба PaLM-540B дар баъзе вазифаҳои тарҷума, махсусан аз забонҳои камманбаъ ё миёнаманбаъ ба англисӣ, аз моделҳои танзимшуда пеш гузашт; дар BLOOM-176B низ ҳамин равиш дида шуд. Сабаб он аст, ки маълумоти англисӣ қисми калони корпусро ташкил медиҳад ва модел дар тавлиди ҷумлаҳои англисӣ хуб аст.
Дар барномасозӣ, бо вуҷуди натиҷаҳои хеле беҳтари Codex ва PaLM нисбат ба моделҳои пешина, барои натиҷаи хуб бояд ба модел иҷозат дод, ки (k) маротиба ҷавоб тавлид кунад. Меъёри мувофиқ pass@k аст: оё ҳадди ақал яке аз (k) натиҷа аз санҷишҳо мегузарад?
Вазифаҳое, ки намунаҳои тамғагузоришуда каманд ё нестанд
Дар чунин ҳолат танзими дақиқи модели хурд одатан наметавонад ба натиҷаҳои модели бузург дар ҳолатҳои бе намуна (Zero-shot), бо як намуна (One-shot) ё бо чанд намуна (Few-shot) баробар шавад.
Умумисозӣ берун аз тақсимоти омӯзишӣ (OOD)
Танзими дақиқи анъанавӣ метавонад моделро ба маҷмӯи омӯзишӣ аз ҳад зиёд мутобиқ кунад ва умумисозиро ба маълумоти берун аз тақсимот (Out-of-Distribution, OOD) заиф созад. Омӯзиш дар дохили контекст бо чанд намуна (Few-shot In-context Learning) дар ин ҷиҳат беҳтар буда метавонад.
- Промптдиҳӣ ба PaLM дар вазифаи ANLI (Adversarial Natural Language Inference) аз моделҳои беҳтарини танзимшуда натиҷаи беҳтар дод, гарчанде дар NLI-и маъмулӣ (масалан, RTE) ақиб монд.
- Промптдиҳӣ ба моделҳои бузург барои таркибҳои нави берун аз тақсимот умумисозии беҳтар нишон дод.
Ду сабаби эҳтимолӣ: ҳангоми омӯзиш дар дохили контекст параметрҳо нав намешаванд, ки мутобиқшавии аз ҳад зиёдро кам мекунад; ва намунаҳое, ки барои моделҳои пешина OOD буданд, барои модели бузург аллакай ба доираи маълумоти дидааш дохил мешаванд.
Мақолаи GPT-3 низ таъкид мекард, ки натиҷаи моделҳои танзимшуда дар санҷишҳои мушаххас, ҳатто агар расман ба сатҳи инсон баробар бошад, метавонад қобилияти воқеии онҳоро аз ҳад зиёд нишон диҳад — бо сабаби робитаҳои тасодуфӣ дар маълумоти омӯзишӣ ва мутобиқшавӣ ба тақсимоти маҳдуд.
Иҷрои доираи васеи вазифаҳо
Баъзан муҳимтар аст, ки модел вазифаҳои гуногунро иҷро кунад, на ин ки дар як вазифа беҳтарин бошад. Чатбот мисоли равшан аст: корбарон интизоранд, ки он ба дархостҳои гуногун дуруст ҷавоб диҳад. Эҳтимол аз ҳамин сабаб ChatGPT муваффақтарин истифодаи GPT-3 гардид.
Вазифаҳои доништалаб, ки ҷустуҷӯ дар онҳо имконпазир нест
Донише, ки дар параметрҳои модел нигоҳ дошта шудааст, метавонад иҷрои вазифаҳои доништалабро хеле беҳтар кунад. Масалан:
- саволу ҷавоб бе муроҷиат ба манбаъҳои беруна (Closed-book Question Answering);
- санҷиши MMLU, ки саволҳои чандинтихобӣ аз 57 фанро — илм, технология, муҳандисӣ, математика, илмҳои гуманитарӣ ва иҷтимоӣ — дар бар мегирад ва дониши умумӣ ва қобилияти ҳалли масъаларо месанҷад.
Аммо агар қадами ҷустуҷӯ илова шавад — яъне тавлиди тақвиятёфта бо ҷустуҷӯ (RAG, ниг. боби 11) — модели хурдтари танзимшуда, масалан Atlas, метавонад натиҷаи беҳтар диҳад: Atlas дар маҷмӯаҳои NaturalQuestions ва TriviaQA аз PaLM ва InstructGPT-и онвақта пеш гузашт. Ҷустуҷӯ дақиқиро зиёд мекунад ва бо нишон додани манбаъҳо эътимоднокиро боло мебарад.
Дар баъзе ҳолатҳо ҷустуҷӯ иҷозат дода намешавад ё осон нест. Масалан, дар имтиҳони иҷозатномаи тиббии ИМА (USMLE) усули бар асоси FLAN-PaLM натиҷаи хеле хуб нишон дод. Дар MMLU модели PaLM-540B аз ҳамаи моделҳои танзимшуда, ҳатто бо ҷустуҷӯ, беҳтар буд, гарчанде InstructGPT-и онвақта аз модели беҳтарини танзимшудаи дорои ҷустуҷӯ ақиб мемонд. Ҳамчунин, FLAN-T5 нишон дод, ки танзими дастурии модели хурдтар метавонад таъсире монанд ба калон кардани модел дошта бошад.
Вазифаҳое, ки қобилиятҳои зуҳуркунандаро талаб мекунанд
Андешаронӣ бо CoT ва вазифаҳои мураккаби BIG-Bench — мантиқ, тарҷума, саволу ҷавоб ва математика. Натиҷаҳои PaLM дар ин вазифаҳо дар бахши «Қобилиятҳои зуҳуркунанда» оварда шудаанд.
Тақлиди инсон ё расидан ба сатҳи инсонии зеҳн
Баъзе ҳолатҳо тақлиди рафтори инсонро талаб мекунанд ё ҳадафашон сохтани зеҳни сунъии умумӣ (AGI) мебошад. ChatGPT муоширатро ба инсон монанд кард, ки ба муваффақияти бузурги он мусоидат намуд. Мақолаи GPT-3 низ қайд мекард, ки инсонҳо барои омӯхтани аксари вазифаҳои забонӣ ба маҷмӯаҳои бузурги маълумоти назоратшаванда ниёз надоранд: онҳо бо чанд намуна малакаҳои гуногунро якҷоя мекунанд ё байни онҳо мегузаранд. Аз ин рӯ, танзими дақиқи анъанавӣ, бо вуҷуди иддаои расидан ба сатҳи инсон дар санҷишҳо, муқоисаи одилона бо инсонро таъмин намекунад.
Баъзе вазифаҳои анъанавии NLP, ки ба моделсозии забон монанданд
PaLM-540B бо чанд намуна дар чунин вазифаҳо ба моделҳои беҳтарини танзимшуда тақрибан баробар шуд ё аз онҳо пеш гузашт:
- пурра кардани охири ҷумла;
- пур кардани ҷойи холии калима;
- ҳалли анафора — муайян кардани он ки ҷонишин ба кадом унсури қаблии матн дахл дорад.
Дар чунин ҳолатҳо истифодаи бе намуна низ кофӣ буда метавонад; чанд намуна одатан ёрии зиёд намедиҳад.
Ҳолатҳое, ки модели бузург зарур нест
Хароҷот аз буҷет зиёд аст
Масалан, барои стартапҳое, ки маблағи зиёд надоранд, истифодаи API-и моделҳои бузург метавонад гарон бошад.
Истифодаи API масъалаҳои амниятӣ ба вуҷуд меорад
Фиристодани маълумот ба провайдери беруна метавонад хатари ифшои маълумотро ба миён орад; ғайр аз ин, модел метавонад муҳтавои зараровар тавлид кунад (ниг. боби 14).
Захираҳои муҳандисӣ ё таҷҳизотӣ кофӣ нестанд
Ҷойгир кардани модели ҳамандозаи GPT-3 ва кам кардани таъхири ҷавоб душвор аст. Масалан, бе GPU-ҳои A100 бо хотираи 80 ГБ ва бе беҳинасозии суръат, ҷойгир кардани чунин модел бо Alpa дар 16 GPU-и A100 бо хотираи 40 ГБ метавонад барои як дархост тақрибан 10 сония вақт гирад — барои аксари барномаҳои онлайн ғайриқобили қабул. Усулҳои самаранокӣ дар боби 13 баррасӣ мешаванд.
Иваз кардани модели хуби танзимшуда на ҳамеша меарзад
Агар модули танзимшудаи дақиқ аллакай мавҷуд бошад, ё модели фаҳмиш ё тавлиди забони табиӣ барои вазифаи мушаххас лозим бошад, арзиши ивазкуниро бояд бодиққат санҷид. Дар солҳои 2022–2023 модели хурди танзимшуда дар гурӯҳҳои зерини вазифаҳо беҳтар буд.
Вазифаҳои анъанавии фаҳмиши забони табиӣ (NLU). Барои вазифаҳое мисли гурӯҳбандӣ тавсия дода мешуд, ки аввал модели хурдтари кушодаро танзими дақиқ кунед. Масалан, SuperGLUE санҷиши душвори NLU аст, ки инҳоро дар бар мегирад:
- дарки матни хондашуда;
- муайян кардани баромадани як ҳукм аз ҳукми дигар;
- муайян кардани маънои калима дар контекст;
- муайян кардани ишораҳои ҳаммарҷаъ;
- андешаронии сабабӣ.
Дар ҳамаи ин вазифаҳо PaLM-540B бо чанд намуна аз T5-11B-и танзимшуда заифтар буд, аксар вақт бо фарқи назаррас; дар GPT-3-и аслӣ фарқ боз ҳам калонтар буд. Ҳатто PaLM-и танзимшуда нисбат ба T5-11B танҳо беҳбудии маҳдуд дод ва аз модели 32-миллиардпараметрии рамзгузор–рамзкушо бо меъмории омехтаи коршиносон (Mixture of Experts, MoE) заифтар буд. Яъне модели хурдтари дорои меъмории мувофиқ (масалан, рамзгузор–рамзкушо; ниг. боби 5) метавонад аз модели хеле бузурги танҳо рамзкушо беҳтар бошад. Ҳатто дар таҳлили эҳсосот ChatGPT аз моделҳои хурди танзимшуда заифтар буд.
Вазифаҳои душворе, ки ба маълумоти воқеии ҷаҳон такя намекунанд. Натиҷаи миёнаи инсон дар 35 фоизи вазифаҳои BIG-Bench аз PaLM-540B баландтар буд. Дар баъзе вазифаҳо, масалан пайгирии ҳаракат дар фазо ва индуксияи математикӣ, калон кардани модел ёрӣ намедиҳад. Дар индуксияи математикӣ PaLM ҳангоми нодуруст будани фарзияи промпт (масалан, «2 адади тоқ аст») хатоҳои зиёд мекард. Ҳамин равиш дар масъалаҳои қонуни миқёспазирии баръакс (Inverse Scaling) дида мешавад: масалан, дар вазифаи redefine-math промпт мегӯяд «Қимати π-ро аз нав 462 муайян кунед». Дониши пешакии модели бузург дар бораи ҷаҳони воқеӣ хеле қавӣ аст ва промпт онро осон иваз карда наметавонад, дар ҳоле ки модели хурди танзимшуда ба дониши хилофи воқеият беҳтар мутобиқ мешавад.
Бисёр вазифаҳои чандзабона ва тарҷумаи мошинӣ. Сабаби асосӣ — ҳиссаи ками маълумоти ғайрианглисӣ дар пешомӯзиш:
- PaLM ва ChatGPT ҳангоми тарҷума аз англисӣ ба забонҳои дигар ва аз забонҳои серманбаъ ба англисӣ аз моделҳои хурди махсуси тарҷума ақиб мемонданд;
- дар саволу ҷавоби чандзабона ва тавлиди матни чандзабона (хулосасозӣ, табдили маълумот ба матн) фарқ калон буд;
- ҳатто PaLM-540B-и танзимшуда нисбат ба T5-11B-и танзимшуда беҳбудии маҳдуд медод.
Ин масъала барои забонҳои камманбаъ, аз ҷумла тоҷикӣ, махсусан муҳим аст (ниг. боби 16).
Андешаронӣ бар асоси дониши рӯзмарра. Дар OpenBookQA, ARC (ҳам Easy ва ҳам Challenge) ва CommonsenseQA, ҳатто бо промптҳои CoT, фарқи калон боқӣ мемонд — дар ҳоле ки дар андешаронии математикӣ натиҷаҳо хеле беҳтар буданд.
Дарки мошинии матни хондашуда. Дар аксари маҷмӯаҳо фарқ хеле бузург буд. Эҳтимол сабаб он аст, ки тамоми дониши зарурӣ аллакай дар порчаи матн мавҷуд аст ва дониши иловагии модели бузург лозим нест.
Гурӯҳбандии умумии вазифаҳое, ки дар онҳо модели бузург бартарӣ надорад
Вазифаҳои зикршуда ба як ё чанд гурӯҳи зерин дохил мешаванд:
- Вазифаҳои NLU, ки на дониши иловагӣ ва на тавлиди матнро талаб мекунанд. Намунаҳои санҷишӣ ба ҳамон тақсимоте тааллуқ доранд, ки дар маълумоти омӯзишӣ мавҷуд аст, ва моделҳои танзимшуда онҳоро аллакай хуб иҷро мекунанд.
- Вазифаҳое, ки дониши иловагии модел лозим нест, зеро ҳар намуна дар контексти худ маълумоти кофӣ дорад. Мисол: дарки мошинии матни хондашуда.
- Вазифаҳое, ки дониш талаб мекунанд, аммо модел ин донишро кам дорад ё маълумоти монандро ҳангоми пешомӯзиш кам дидааст. Мисол: вазифаҳо ба забонҳои камманбаъ.
- Вазифаҳое, ки донишашон бо дониши модел мувофиқ нест ё ба маълумоти забонии ҷаҳони воқеӣ такя намекунанд. Ғайр аз redefine-math, мисоли дигар такрори иқтибоси тағйирёфта (Modified Quote Repetition) аст: аз модел хоҳиш мешавад версияи тағйирёфтаи иқтибоси машҳурро такрор кунад, аммо модел майл дорад иқтибоси аслиро такрор кунад.
- Вазифаҳое, ки ҳам дониш ва ҳам коркарди мураккаби онро талаб мекунанд. Модел бояд донишро таҳлил, тағйир ё якҷоя кунад, ки бо ҳадафи одии пешгӯии токени навбатӣ на ҳамеша осон аст. CoT ва промптдиҳӣ аз содатарин ба мураккабтарин (Least-to-Most Prompting) эҳтимол аз он сабаб ёрӣ медиҳанд, ки матнҳои пешомӯзиширо, ки раванди банақшагирӣ ва ҷудо ё якҷоя кардани донишро тақлид мекунанд, беҳтар «фаъол» мекунанд. Аз ин рӯ, онҳо дар математика, барномасозӣ ва андешаронии содаи забонӣ хуб кор мекунанд, аммо дар андешаронии дедуктивӣ ва вазифаҳои ғайриодии рамзӣ, ки дониши дар қисмҳои гуногун пароканда коркард мекунанд, душворӣ мекашанд.
- Вазифаҳое, ки ба робитаҳои тасодуфӣ осебпазиранд — дар намунаҳои промпт ё дар маълумоти воқеӣ. Мисол: саволу ҷавоб бо инкор (Negation Question Answering). Агар ба модел ҷумлаи «Агар ҳарорати бадани гурба аз миёна паст бошад, он дар … нест» дода шавад, модел майл дорад «хатар» тавлид кунад, на «ҳудуди бехатар». Робитаи «ҳарорати паст — хатар» бартарӣ мегирад ва инкор нодида гирифта мешавад.
- Вазифаҳое, ки ҳадафашон аз моделсозии забон хеле фарқ мекунад, масалан регрессия. Вазифаҳои мултимодалӣ низ бо моделҳои танҳо забонӣ иҷро намешаванд, аммо метавонанд аз моделҳои бузурги мултимодалӣ баҳра баранд.
- Вазифаҳое, ки қобилиятҳои зуҳуркунандаро талаб намекунанд. Барои дақиқ муайян кардани онҳо бояд беҳтар фаҳмем, ки ин қобилиятҳо дар ҷараёни омӯзиш аз куҷо пайдо мешаванд.
Истифодаи модели бузург барои омода кардани маълумот
Ҳатто агар модели бузургро бо сабаби таъхир ё арзиш онлайн истифода бурда натавонем, онро метавон офлайн барои тавлид ё тамғагузории маълумот истифода кард:
- маълумоти омодашударо ҳангоми дархости онлайн ҷустуҷӯ карда, ба корбар пешниҳод кардан мумкин аст;
- онро барои танзими дақиқи модели хурдтар истифода бурдан мумкин аст, ки ниёз ба тамғагузории инсонро кам мекунад;
- бо ин роҳ баъзе қобилиятҳои модели бузург, масалан занҷираи андешаронӣ, ба модели хурд интиқол дода мешаванд. Ин равиш ба интиқоли дониш (Knowledge Distillation) наздик аст, ки бо он, масалан, DistilBERT сохта шудааст (ниг. боби 5).
Эзоҳи таърихӣ
Дар соли 2023 тавсияи маъмул ин буд, ки дар сурати доштани маълумоти тамғагузоришудаи кофӣ ва буҷети маҳдуд, аввал модели кушодаи FLAN-T5-ро танзими дақиқ кунед. Ҳамчунин пешгӯӣ мешуд, ки Google, ки модели пурқуввати FLAN-PaLM-ро дошт, ба зудӣ чатботи рақиби ChatGPT пешниҳод мекунад. Ин пешгӯӣ дуруст баромад: Google соли 2023 Bard-ро муаррифӣ кард, ки баъдтар ба Gemini табдил ёфт. Имрӯз барои танзими дақиқ ва ҷойгиркунии мустақил одатан моделҳои кушода, масалан Llama, Qwen, Gemma ва DeepSeek, интихоб мешаванд.
Хулоса
- Омӯзиши пешакӣ ба модел дониши васеи забон ва ҷаҳонро медиҳад, аммо модели пешакӣ омӯзонидашуда ҳанӯз ёвари ҳамоҳангшуда нест — барои ин танзими дақиқ (боби 7) ва ҳамоҳангсозӣ (боби 8) лозиманд.
- Ҳадафи асосии омӯзиш — пешгӯии токени навбатӣ — худназоратӣ аст: матн худаш ҷавобро медиҳад ва нишонагузории дастӣ лозим нест.
- Омӯзиш аз такрори миллиардҳо маротибаи гузариши мустақим ва паҳншавии баръакси хато иборат аст, ки вазнҳоро тадриҷан ислоҳ мекунад.
- Қонунҳои миқёспазирӣ нишон медиҳанд, ки сифат бо афзоиши параметрҳо, додаҳо ва ҳисоббарорӣ пешгӯишаванда беҳтар мешавад. Тибқи Chinchilla, барои омӯзиши беҳин тақрибан 20 токен ба ҳар параметр лозим аст, гарчанде моделҳои муосир барои арзонии истифода аксар вақт бо додаҳои бештар омӯзонда мешаванд.
- Бо афзоиши миқёс қобилиятҳои зуҳуркунанда, масалан андешаронии чандқадамӣ, пайдо мешаванд, гарчанде табиати онҳо баҳсбарангез аст.
- Таҷрибаи бозсозии GPT-3 нишон дод, ки сифат, гуногунӣ ва тозагии маълумот, инчунин устувории омӯзиш (bfloat16, меъмории мувофиқ, тағйир надодани танзимот дар миёнаи омӯзиш) на камтар аз андоза муҳиманд.
- Модели бузург на ҳамеша беҳтарин интихоб аст: барои вазифаҳои тангу мушаххас, бо маълумоти кофӣ, маҳдудияти арзиш, таъхир ё махфият, модели хурди танзимшуда аксар вақт оқилонатар аст.
Манбаъҳо
Ин боб қисман дар асоси манбаъҳои зерин таҳия шудааст:
- Lee, T. B., Trott, S. (2023). Large language models, explained with a minimum of math and jargon. Understanding AI. https://www.understandingai.org/p/large-language-models-explained-with — ташбеҳи шири об, мисоли «назарияи зеҳн» ва қисми «Чаро моделҳои бузурги забонӣ ин қадар хуб кор мекунанд?».
- Yang, J. (2023). Why did all of the public reproduction of GPT-3 fail? In which tasks should we use GPT-3.5/ChatGPT? (мақолаи блог) — қисмҳои «Дарсҳо аз бозсозии GPT-3» ва «Кай модели бузург ва кай модели хурди танзимшуда?».
Мақолаҳои илмие, ки дар боб зикр шудаанд:
- Bubeck, S. ва ҳамкорон (2023). Sparks of Artificial General Intelligence: Early experiments with GPT-4. https://arxiv.org/abs/2303.12712
- Brown, T. ва ҳамкорон (2020). Language Models are Few-Shot Learners (GPT-3). https://arxiv.org/abs/2005.14165
- Kaplan, J. ва ҳамкорон (2020). Scaling Laws for Neural Language Models. https://arxiv.org/abs/2001.08361
- Rae, J. ва ҳамкорон (2021). Scaling Language Models: Methods, Analysis & Insights from Training Gopher. https://arxiv.org/abs/2112.11446
- Hoffmann, J. ва ҳамкорон (2022). Training Compute-Optimal Large Language Models (Chinchilla). https://arxiv.org/abs/2203.15556
- Chowdhery, A. ва ҳамкорон (2022). PaLM: Scaling Language Modeling with Pathways. https://arxiv.org/abs/2204.02311
- Srivastava, A. ва ҳамкорон (2022). Beyond the Imitation Game (BIG-Bench). https://arxiv.org/abs/2206.04615
- Wei, J. ва ҳамкорон (2022). Emergent Abilities of Large Language Models. https://arxiv.org/abs/2206.07682
- Wei, J. ва ҳамкорон (2022). Chain-of-Thought Prompting Elicits Reasoning in Large Language Models. https://arxiv.org/abs/2201.11903
- Liang, P. ва ҳамкорон (2022). Holistic Evaluation of Language Models (HELM). https://arxiv.org/abs/2211.09110
- Chung, H. W. ва ҳамкорон (2022). Scaling Instruction-Finetuned Language Models (FLAN). https://arxiv.org/abs/2210.11416
- Zhang, S. ва ҳамкорон (2022). OPT: Open Pre-trained Transformer Language Models. https://arxiv.org/abs/2205.01068
- BigScience Workshop (2022). BLOOM: A 176B-Parameter Open-Access Multilingual Language Model. https://arxiv.org/abs/2211.05100
- Kosinski, M. (2023). Theory of Mind May Have Spontaneously Emerged in Large Language Models. https://arxiv.org/abs/2302.02083
- Schaeffer, R. ва ҳамкорон (2023). Are Emergent Abilities of Large Language Models a Mirage? https://arxiv.org/abs/2304.15004
- McKenzie, I. ва ҳамкорон (2023). Inverse Scaling: When Bigger Isn't Better. https://arxiv.org/abs/2306.09479
 Барномасозӣ
 Олами Афсонаҳо
 Ахбор
 Саломатӣ
 Дунё