Омӯзиши моделҳои бузурги забонӣ (LLM)
Китоби омӯзишӣ дар бораи моделҳои бузурги забонӣ (LLM) ба забони тоҷикӣ: аз мафҳумҳои аввалия то усулҳои муосир. Токенсозӣ ва векторҳо, шабакаҳои нейронӣ, механизми таваҷҷуҳ ва Transformer, оилаҳои моделҳо, омӯзиши пешакӣ, танзими дақиқ ва LoRA, мутобиқсозӣ (RLHF, DPO), тавлиди матн, муҳандисии промпт, RAG, агентҳо, самаранокӣ, арзёбӣ ва бехатарӣ, тафсирпазирӣ ва истифодаи LLM барои забони тоҷикӣ. Бо мисолҳои код дар Python ва PyTorch, замимаҳои математика ва луғати истилоҳот.
Агенти Зеҳнӣ · 13 октябри 2026 · 18 саҳифа · 2 писанд
Боби 8. Мутобиқсозӣ бо арзишҳои инсонӣ: RLHF, DPO ва моделҳои андешаронӣ
Дар боби 6 дидем, ки модели бузурги забонӣ дар марҳилаи омӯзиши пешакӣ (Pre-training) аз триллионҳо токен пешгӯии токени навбатиро меомӯзад. Дар боби 7 бошад, бо танзими дақиқ (Fine-tuning) ва усулҳои PEFT шинос шудем.
Аммо модели пешакӣ омӯзонидашуда ҳанӯз ёвари муфид нест. Он матнро идома медиҳад, вале на ҳамеша ба савол ҷавоб медиҳад, на ҳамеша ростқавл аст ва метавонад матни зараровар тавлид кунад. Раванди табдил додани чунин модел ба ёвари муфид, ростқавл ва бехатар мутобиқсозӣ (Alignment) ном дорад. Дар ин боб усулҳои асосии онро меомӯзем.
Дар ин боб меомӯзем
- Чаро модели пешакӣ омӯзонидашуда ҳанӯз ёвар нест.
- Танзими дастурӣ (Instruction Tuning, SFT) чӣ кор мекунад.
- Мафҳумҳои асосии омӯзиши тақвиятӣ (Reinforcement Learning) кадомҳоянд.
- RLHF чӣ гуна кор мекунад: маълумоти афзалиятҳо, модели мукофот (Reward Model) ва PPO.
- Мушкилоти RLHF: «фиреби мукофот», хароҷот ва хушомадгӯӣ.
- DPO чист ва чаро аз RLHF соддатар аст.
- Constitutional AI ва RLAIF — бозхӯрд аз модели дигар ба ҷои инсон.
- Моделҳои андешаронӣ (Reasoning Models) чӣ гуна бо мукофотҳои қобили санҷиш ва GRPO омӯзонида мешаванд.
- Чаро модел «галлюсинатсия» мекунад ва мутобиқсозӣ дар ин бора чӣ карда метавонад.
- Мувозинати бехатарӣ ва фоиданокӣ.
Чаро модели пешакӣ омӯзонидашуда ҳанӯз ёвар нест?
Модели асосӣ (Base Model) танҳо як вазифаро медонад: идома додани матн тавре, ки дар интернет маъмул аст. Фарз кунед, ба он чунин матн медиҳем:
Пойтахти Тоҷикистон кадом шаҳр аст?
Модели асосӣ метавонад чунин «ҷавоб» диҳад:
Пойтахти Ӯзбекистон кадом шаҳр аст?
Пойтахти Қирғизистон кадом шаҳр аст?
Ҷавобҳоро дар дафтаратон нависед.
Аз нигоҳи модел ин идомаи комилан мантиқӣ аст: дар интернет чунин саволҳо аксар вақт дар рӯйхатҳои машқҳо вомехӯранд. Аммо корбар инро намехост.
Ба ғайр аз ин, модели асосӣ:
- метавонад дастурҳоро нодида гирад ё нопурра иҷро кунад;
- ҳар гуна услуб ва мавқеъро, ки дар интернет ҳаст, такрор мекунад — аз ҷумла дағалӣ ва таассуб;
- метавонад ба дархостҳои хатарнок бе ҳеҷ эҳтиёт ҷавоб диҳад;
- намедонад, ки кай бояд «намедонам» гӯяд.
Ҳадафи мутобиқсозиро аксар вақт бо се калимаи англисӣ ифода мекунанд — HHH:
| Хусусият | Номи англисӣ | Маъно |
|---|---|---|
| Фоиданок | Helpful | Дархости корбарро дуруст мефаҳмад ва пурра иҷро мекунад |
| Ростқавл | Honest | Маълумот намебофад, номуайяниро эътироф мекунад |
| Безарар | Harmless | Ба корбар ва дигарон зарар намерасонад |
Марҳилаҳои сохтани ёвар
Ёварҳои муосир, монанди ChatGPT, Claude ё Gemini, одатан аз чунин марҳилаҳо мегузаранд:
| Марҳила | Маълумот | Натиҷа |
|---|---|---|
| 1. Омӯзиши пешакӣ (Pre-training) | Триллионҳо токени матни умумӣ | Модели асосӣ: дониш ва забонро медонад |
| 2. Танзими дастурӣ (SFT) | Ҳазорҳо то миллионҳо ҷуфти «дастур — ҷавоб» | Модел ба дастурҳо ҷавоб доданро меомӯзад |
| 3. Омӯзиш аз афзалиятҳо (RLHF, DPO ва ғ.) | Ҷуфтҳои ҷавобҳо: «кадомаш беҳтар аст?» | Ҷавобҳо ба хоҳиши одамон наздиктар мешаванд |
| 4. Омӯзиши тақвиятӣ бо мукофотҳои қобили санҷиш (ихтиёрӣ) | Масъалаҳои математика, барномасозӣ ва ғ. | Модел андешаронии бисёрқадамаро меомӯзад |
Марҳилаҳои 2–4-ро якҷоя баъзан омӯзиши баъдӣ (Post-training) меноманд.
Танзими дастурӣ (Instruction Tuning, SFT)
То ин ҷо модели бузурги забониеро дорем, ки омӯзиши пешакиро гузаштааст. Дар марҳилаи навбатӣ асосан ҳамон кори пешинаро идома медиҳем: модел пешгӯӣ кардани калимаҳоро як-як ва дар паҳлуи ҳам ҷой додани онҳоро меомӯзад.
Аммо ин дафъа ҳамчун маълумоти омӯзишӣ танҳо ҷуфтҳои босифати «дастур — ҷавоб» (ё «савол — ҷавоб») истифода мешаванд. Ин марҳиларо танзими дастурӣ (Instruction Tuning) ё танзими дақиқи назоратшаванда (Supervised Fine-Tuning — SFT) меноманд. Тафсилоти техникии танзими дақиқ дар боби 7 оварда шудааст.
Як мисоли маълумоти SFT:
{
  "messages": [
    {"role": "user", "content": "Се маслиҳат барои омӯхтани забони англисӣ деҳ."},
    {"role": "assistant", "content": "1. Ҳар рӯз 15–20 дақиқа машқ кунед.\n2. Филмҳоро бо субтитри англисӣ тамошо кунед.\n3. Калимаҳои навро дар ҷумлаҳо истифода баред."}
  ]
}
Ҳамин тавр, модел меомӯзад, ки танҳо идомадиҳандаи матн набошад, балки ба ёрдамчии корамад табдил ёбад. Он ҳамчунин ёд мегирад, ки ба ниёзҳои корбар мувофиқтар ҷавоб диҳад ва бо ҳадафи ӯ бештар ҳамоҳанг бошад. Дар ин марҳила модел шакли суҳбат ва қолаби суҳбат (Chat Template)-ро низ меомӯзад (ниг. боби 10).
Ҳаҷми ин маҷмӯаи маълумот одатан аз маҷмӯаи омӯзиши пешакӣ хеле хурдтар аст. Сабабаш хароҷот мебошад: сохтани ҷуфтҳои босифати саволу ҷавоб гарон аст, зеро одамон бояд онҳоро таҳия кунанд. Имрӯз қисми зиёди чунин маълумотро бо ёрии моделҳои дигар месозанд (маълумоти синтетикӣ — Synthetic Data) ва одамон онро месанҷанд.
Маҳдудияти SFT
SFT ба модел нишон медиҳад, ки як ҷавоби хуб чӣ гуна аст. Аммо:
- навиштани ҷавоби комил барои ҳар савол душвор ва гарон аст;
- одамон беҳтар муқоиса мекунанд, назар ба он ки аз сифр ҷавоби комил нависанд: гуфтани «ҷавоби А аз ҷавоби Б беҳтар аст» осонтар аст;
- SFT ба модел намефаҳмонад, ки кадом ҷавобҳо бад ҳастанд ва аз онҳо дурӣ ҷӯяд.
Барои ҳамин баъд аз SFT марҳилаи омӯзиш аз афзалиятҳо меояд.
Мафҳумҳои асосии омӯзиши тақвиятӣ
Омӯзиши тақвиятӣ (Reinforcement Learning — RL) — соҳаи омӯзиши мошинӣ аст, ки дар он агент (Agent) дар муҳит (Environment) амал (Action) иҷро мекунад ва барои он мукофот (Reward) мегирад. Ҳадафи агент — ёфтани сиёсат (Policy)-е, ки мукофоти умумиро зиёд мекунад.
Мисоли маъмул — омӯзонидани саг: агар фармонро иҷро кунад, ба вай ширинӣ медиҳанд. Ба саг касе намефаҳмонад, ки чӣ тавр нишинад; вай аз рӯи мукофот худаш мефаҳмад.
Дар мавриди моделҳои забонӣ ин мафҳумҳо чунин маъно доранд:
| Мафҳуми RL | Дар модели забонӣ |
|---|---|
| Агент / сиёсат | Худи модели забонӣ |
| Ҳолат (State) | Промпт ва токенҳои то ин дам тавлидшуда |
| Амал | Интихоби токени навбатӣ |
| Эпизод | Тавлиди як ҷавоби пурра |
| Мукофот | Баҳо ба ҷавоби пурра (аз модели мукофот ё санҷиши худкор) |
Фарқи муҳим аз SFT: дар SFT мо ба модел ҷавоби дурустро нишон медиҳем. Дар RL модел худаш ҷавоб тавлид мекунад, мо танҳо баҳо медиҳем, ки он чӣ қадар хуб аст.
RLHF: омӯзиши тақвиятӣ аз бозхӯрди инсон
RLHF (Reinforcement Learning from Human Feedback) — «омӯзиши тақвиятӣ аз бозхӯрди инсон» — усулест, ки баъд аз SFT барои танзими дақиқи рафтори модел мувофиқи хоҳишу афзалиятҳои инсон истифода мешавад. Он ба мутобиқсозӣ ёрӣ мерасонад, то ҷавобҳои модели бузурги забонӣ арзишҳо ва афзалиятҳои инсониро бештар инъикос кунанд. Моделҳои истифодашаванда дар ChatGPT аз аввал ин марҳиларо гузаштаанд.
Дар ин равиш модели мукофот (Reward Model) омӯзишро роҳнамоӣ мекунад. Он ба ҷавобҳои модели забонӣ баҳо медиҳад, то ин баҳогузорӣ афзалиятҳои арзёбони инсониро инъикос кунад. Сипас модели мукофот бо алгоритми омӯзиши тақвиятӣ, масалан, PPO (Proximal Policy Optimization), якҷоя истифода мешавад, то модел такмил ёбад.
Раванди таҳияи InstructGPT-и OpenAI (Ouyang ва ҳамкорон, 2022) намунаи классикии чунин истифода аст. Он аз се марҳилаи асосӣ иборат буд.
Марҳилаи 1. Омӯзиш бо ҷавобҳои босифат (SFT)
Ҷуфтҳои босифати «промпт — ҷавоб» омода мешаванд: одамон ба промптҳо ҷавобҳои намунавӣ менависанд. Сипас модели пешакӣ омӯзонидашуда бо усули назоратшаванда танзим мешавад. Дар мақолаи InstructGPT барои ин марҳила тақрибан 13 000 промпти омӯзишӣ зикр шудааст.
Марҳилаи 2. Омӯзонидани модели мукофот
Модели танзимшуда ба ҳар промпт якчанд ҷавоб тавлид мекунад. Арзёбони инсонӣ ҷавобҳоро аз рӯи афзалиятҳои худ дараҷабандӣ мекунанд. Як мисоли маълумоти афзалиятҳо (Preference Data):
{
  "prompt": "Чаро осмон кабуд аст? Ба кӯдаки 8-сола фаҳмон.",
  "chosen": "Нури офтоб аз рангҳои гуногун иборат аст. Вақте ки он аз ҳаво мегузарад, ранги кабуд бештар аз дигарон пароканда мешавад ва аз ҳар тараф ба чашми мо мерасад. Барои ҳамин осмон кабуд менамояд.",
  "rejected": "Ин бо пароканиши Рэлей вобаста аст, ки шиддати он ба дараҷаи чоруми дарозии мавҷ мутаносиби баръакс аст."
}
Ҷавоби дуюм дуруст аст, вале барои кӯдаки 8-сола мувофиқ нест — арзёб ҷавоби аввалро интихоб кардааст.
Аз ин баҳогузориҳо барои омӯзонидани модели мукофот истифода мешавад. Модели мукофот одатан худ як модели забонӣ аст, ки ба ҷои пешгӯии токен як адад — баҳо (r(x, y)) медиҳад. Он тавре омӯзонида мешавад, ки ба ҷавоби интихобшуда (y_w) баҳои баландтар аз ҷавоби радшуда (y_l) диҳад:
[
\mathcal{L}_{RM} = -\log \sigma\big(r(x, y_w) - r(x, y_l)\big)
]
Ин формула аз модели Брэдли–Терри (Bradley–Terry) гирифта шудааст: ҳар қадар фарқи баҳоҳо калонтар бошад, хато ҳамон қадар хурдтар аст. Дар мақолаи InstructGPT барои ин марҳила тақрибан 33 000 промпти омӯзишӣ зикр шудааст.
Марҳилаи 3. Такмил бо омӯзиши тақвиятӣ (PPO)
Акнун модел ба промптҳо ҷавоб тавлид мекунад, модели мукофот ба онҳо баҳо медиҳад ва алгоритми PPO вазнҳои моделро тавре тағйир медиҳад, ки баҳо зиёд шавад. Дар мақолаи InstructGPT барои ин марҳила тақрибан 31 000 промпти омӯзишӣ зикр шудааст.
Як нуктаи муҳим: агар модел танҳо баҳоро зиёд кунад, вай метавонад аз забони табиӣ хеле дур шавад ва «ҳилаҳо»-и аҷибе ёбад. Барои ҳамин ба мукофот ҷаримаи KL (KL Penalty) илова мекунанд, ки модели навро аз модели аввалаи SFT ((\pi_{\text{ref}})) хеле дур рафтан намегузорад:
[
\max_{\pi} ; \mathbb{E}{x,, y \sim \pi}\big[r(x, y)\big] - \beta , \mathrm{KL}\big(\pi(y \mid x) ,|, \pi{\text{ref}}(y \mid x)\big)
]
Ин ҷо (\beta) муайян мекунад, ки ба модел чӣ қадар озодӣ дода мешавад.
Натиҷаҳои RLHF
Ин равиш метавонад ҷавобҳое ба вуҷуд оварад, ки корбарон онҳоро аз ҷавобҳои модели асосӣ хеле бештар меписанданд. Дар мақолаи InstructGPT арзёбон ҷавобҳои модели хурди InstructGPT (1.3 миллиард параметр)-ро аз ҷавобҳои модели хеле калонтари GPT-3 (175 миллиард параметр) бештар писандиданд. Ин нишон дод, ки мутобиқсозӣ на камтар аз андозаи модел муҳим аст.
Ҳамзамон, дар баъзе санҷишҳои стандартӣ эҳтимоли паст шудани натиҷа вуҷуд дорад. Чунин коҳиши қобилиятро андози мутобиқсозӣ (Alignment Tax) меноманд.
Ҷамъбасти RLHF
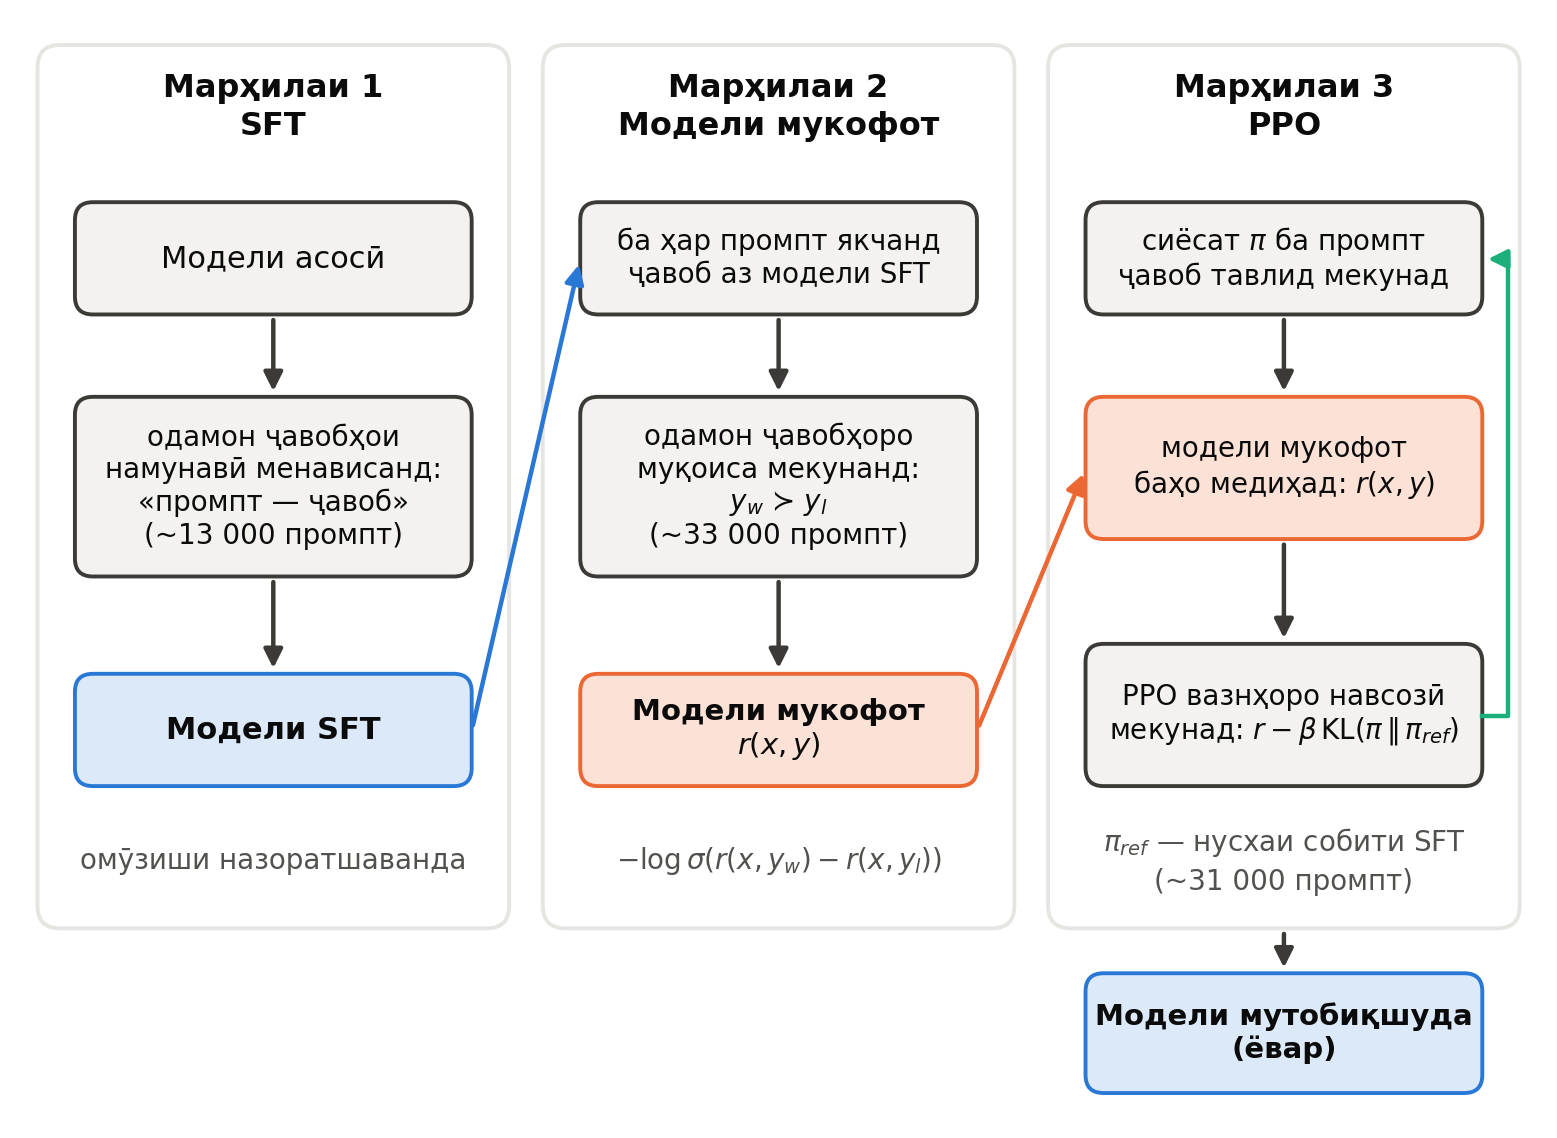
Расми 8.1. Се марҳилаи RLHF дар InstructGPT: SFT, омӯзонидани модели мукофот аз афзалиятҳои инсон ва такмил бо PPO бо ҷаримаи KL нисбат ба модели истинод.
Мушкилоти RLHF
RLHF самаранок аст, вале мушкилоти зиёд дорад.
Фиреби мукофот (Reward Hacking)
Модели мукофот танҳо тахмин-и афзалиятҳои инсон аст, на худи онҳо. Модели забонӣ метавонад камбудиҳои онро ёбад ва баҳои баланд гирад, бе он ки ҷавобаш воқеан беҳтар шавад. Масалан, агар модели мукофот ҷавобҳои дарозро бештар писандад, модел ҷавобҳои беҳуда дароз менависад.
Ин падидаро бо қонуни Гудҳарт (Goodhart's Law) шарҳ медиҳанд: «Вақте ки нишондиҳанда ба ҳадаф табдил меёбад, он дигар нишондиҳандаи хуб нест».
Хушомадгӯӣ (Sycophancy)
Одамон ҷавобҳоеро, ки бо фикрашон мувофиқанд ё онҳоро таъриф мекунанд, бештар меписанданд. Модели бо RLHF омӯзонидашуда метавонад ин хусусиятро ёд гирад: ба корбар розӣ шавад, ҳатто вақте ки корбар хато мекунад.
Мушкилоти дигар
| Мушкил | Шарҳ |
|---|---|
| Хароҷот | Ҳазорҳо соати кори арзёбони ботаҷриба лозим аст |
| Ихтилофи арзёбон | Одамон дар бораи «ҷавоби беҳтар» аксар вақт ҳамфикр нестанд |
| Мураккабии техникӣ | PPO ҳамзамон чор модел талаб мекунад: сиёсат, модели истинод, модели мукофот ва модели арзиш (Value Model) |
| Ноустуворӣ | Омӯзиши PPO ба гиперпараметрҳо хеле ҳассос аст |
| Андози мутобиқсозӣ | Баъзе қобилиятҳо метавонанд паст шаванд |
Ин мушкилот муҳаққиқонро ба ҷустуҷӯи усулҳои соддатар водор карданд.
DPO: оптимизатсияи мустақими афзалиятҳо
DPO (Direct Preference Optimization) — «оптимизатсияи мустақими афзалиятҳо» — соли 2023 пешниҳод шуд (Rafailov ва ҳамкорон) ва зуд ба яке аз усулҳои маъмултарин табдил ёфт, махсусан барои моделҳои кушод.
Ғояи асосӣ
Муаллифони DPO нишон доданд, ки масъалаи RLHF (зиёд кардани мукофот бо ҷаримаи KL)-ро метавон аз нигоҳи риёзӣ тавре табдил дод, ки модели мукофоти алоҳида ва омӯзиши тақвиятӣ лозим нашаванд. Модели забонӣ худаш нақши модели мукофотро мебозад.
DPO мустақиман аз ҳамон ҷуфтҳои «интихобшуда — радшуда» меомӯзад. Ҳадаф оддӣ аст: эҳтимоли ҷавоби интихобшударо нисбат ба модели истинод зиёд ва эҳтимоли ҷавоби радшударо кам кун:
[
\mathcal{L}{DPO} = -\log \sigma\left(\beta \log \frac{\pi\theta(y_w \mid x)}{\pi_{\text{ref}}(y_w \mid x)} - \beta \log \frac{\pi_\theta(y_l \mid x)}{\pi_{\text{ref}}(y_l \mid x)}\right)
]
Ин формула ба формулаи модели мукофот хеле монанд аст — фақат ба ҷои (r(x,y)) таносуби эҳтимолҳои модел истифода мешавад.
Муқоисаи RLHF ва DPO
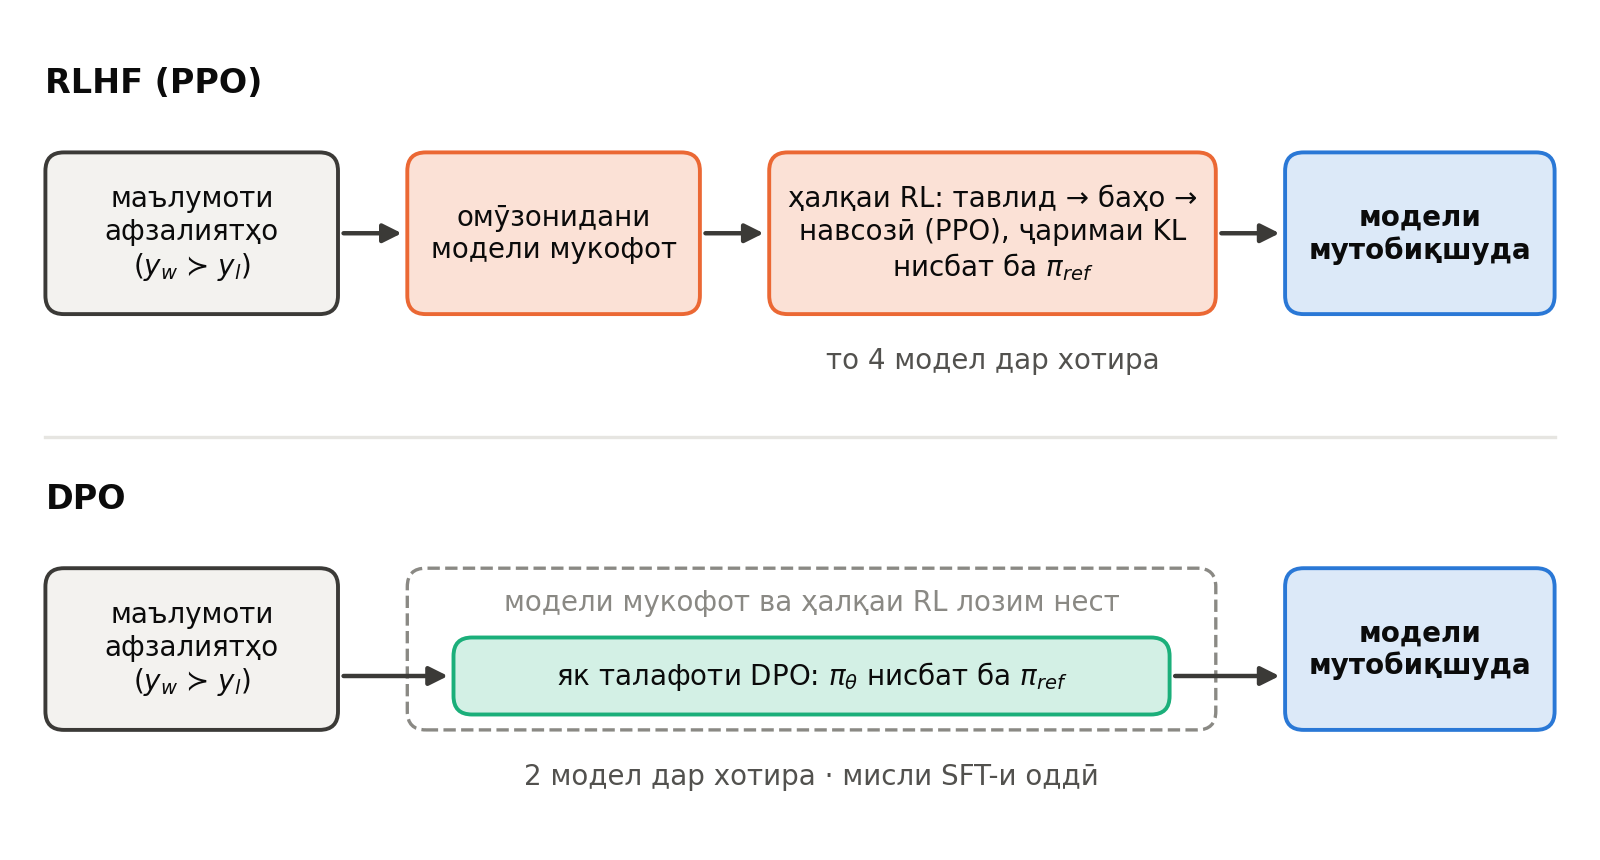
Расми 8.2. RLHF модели мукофоти алоҳида ва ҳалқаи омӯзиши тақвиятиро талаб мекунад; DPO аз ҳамон маълумоти афзалиятҳо бо як функсияи хато мустақиман меомӯзад.
| Хусусият | RLHF (PPO) | DPO |
|---|---|---|
| Модели мукофоти алоҳида | Лозим | Лозим нест |
| Тавлиди ҷавоб ҳангоми омӯзиш | Ҳа (онлайн) | Не (офлайн, аз маълумоти тайёр) |
| Шумораи моделҳо дар хотира | То 4 | 2 (модел ва модели истинод) |
| Мураккабии татбиқ | Баланд | Мисли SFT-и оддӣ |
| Устуворӣ | Ҳассос ба танзимот | Устувортар |
| Имконияти беҳтар шудан аз ҷавобҳои худ | Ҳаст | Маҳдуд |
DPO-ро бо китобхонаи TRL (Hugging Face) чунин истифода мебаранд (схема):
from datasets import load_dataset
from trl import DPOConfig, DPOTrainer

# Маълумот бояд майдонҳои "prompt", "chosen", "rejected" дошта бошад
dataset = load_dataset("json", data_files="afzaliyatho.jsonl", split="train")

trainer = DPOTrainer(
    model=model,                      # модели баъд аз SFT
    args=DPOConfig(output_dir="dpo-model", beta=0.1),
    train_dataset=dataset,
    processing_class=tokenizer,
)
trainer.train()
Баъд аз DPO вариантҳои зиёди он пайдо шуданд (масалан, IPO, KTO, ORPO, SimPO), ки ҳар кадом камбудии муайянеро ислоҳ мекунанд. Масалан, KTO ҷуфтҳо талаб намекунад ва аз баҳоҳои оддии «хуб/бад» меомӯзад. Дар амал лабораторияҳои калон аксар вақт якчанд усулро якҷоя истифода мебаранд.
Constitutional AI ва RLAIF: бозхӯрд аз модел
Ҷамъ овардани бозхӯрди инсон гарон ва суст аст. Оё модел худаш метавонад ба ҷавобҳо баҳо диҳад?
Constitutional AI
Соли 2022 ширкати Anthropic усули Constitutional AI («зеҳни сунъии конститутсионӣ»)-ро пешниҳод кард (Bai ва ҳамкорон, 2022). Ғоя ин аст, ки ба ҷои ҳазорҳо баҳои инсонӣ дар бораи бехатарӣ, рӯйхати кӯтоҳи принсипҳо — «конститутсия» навишта мешавад. Масалан:
Ҷавоберо интихоб кун, ки бештар ростқавл ва фоиданок бошад
ва ба ҳеҷ кас барои кори зараровар кумак накунад.
Раванд ду марҳила дорад:
- Худтанқидкунӣ ва ислоҳ (SFT). Модел ба промпт ҷавоб медиҳад, сипас худаш ҷавобашро аз рӯи принсипҳо танқид мекунад ва нусхаи беҳтар менависад. Модел дар ҷавобҳои ислоҳшуда омӯзонида мешавад.
- RLAIF. Модел ҷуфтҳои ҷавобҳоро аз рӯи принсипҳо муқоиса мекунад. Ин баҳоҳо барои омӯзонидани модели мукофот ва RL истифода мешаванд.
RLAIF
RLAIF (Reinforcement Learning from AI Feedback) — «омӯзиши тақвиятӣ аз бозхӯрди зеҳни сунъӣ» — номи умумии усулҳоест, ки дар онҳо афзалиятҳоро на одамон, балки модели забонии дигар (ё худи модел) муайян мекунад.
| Хусусият | RLHF | RLAIF |
|---|---|---|
| Кӣ баҳо медиҳад? | Арзёбони инсонӣ | Модели забонӣ |
| Хароҷот | Баланд | Хеле пасттар |
| Миқёспазирӣ | Маҳдуд | Баланд |
| Шаффофият | Афзалиятҳои арзёбон пинҳонанд | Принсипҳо ошкоро навишта шудаанд |
| Хатар | Хатоҳо ва таассуби одамон | Хатоҳо ва таассуби модели баҳодиҳанда |
Дар амал одамон аз раванд хориҷ намешаванд: онҳо принсипҳоро менависанд, натиҷаҳоро месанҷанд ва дар ҳолатҳои мураккаб баҳо медиҳанд.
Моделҳои андешаронӣ: омӯзиши тақвиятӣ бо мукофотҳои қобили санҷиш
Аз соли 2024 самти нави муҳим пайдо шуд — моделҳои андешаронӣ (Reasoning Models). Моҳи сентябри соли 2024 OpenAI модели o1-ро муаррифӣ кард, ки пеш аз ҷавоб додан занҷири дарози андешаро тавлид мекунад. Моҳи январи соли 2025 ширкати DeepSeek модели кушоди DeepSeek-R1-ро нашр кард ва дар мақолааш усули омӯзонидани онро муфассал шарҳ дод. Баъд аз ин аксари лабораторияҳои калон моделҳои андешаронӣ ё ҳолати «андешаронӣ» дар моделҳои худро пешниҳод карданд.
Мукофотҳои қобили санҷиш (Verifiable Rewards)
Дар RLHF мукофот аз модели мукофот меояд, ки метавонад фиреб хӯрад. Аммо барои баъзе масъалаҳо ҷавоби дурустро худкор санҷидан мумкин аст:
- математика — ҷавоби ниҳоӣ бо ҷавоби дуруст муқоиса мешавад;
- барномасозӣ — код бо санҷишҳо (Unit Tests) иҷро мешавад;
- мантиқ ва муаммоҳо — ҳалли онро бо барнома тафтиш кардан мумкин аст.
Ин равишро RLVR (Reinforcement Learning with Verifiable Rewards) меноманд. Мукофот одатан аз ду қисм иборат аст: оё ҷавоб дуруст аст ва оё шакли ҷавоб (масалан, ҷойгиршавии андеша ва ҷавоби ниҳоӣ дар қисмҳои муайян) риоя шудааст.
def mukofot(javobi_model: str, javobi_durust: str) -> float:
    """Мукофоти оддии қобили санҷиш барои масъалаи математикӣ."""
    if "" not in javobi_model:
        return 0.0                      # шакл риоя нашудааст
    natija = javobi_model.split("")[1].split("")[0].strip()
    return 1.0 if natija == javobi_durust else 0.0
Ба модел нишон дода намешавад, ки чӣ гуна фикр кунад — танҳо гуфта мешавад, ки ҷавоби ниҳоӣ дуруст аст ё не. Модел худаш стратегияҳои муфидро меёбад.
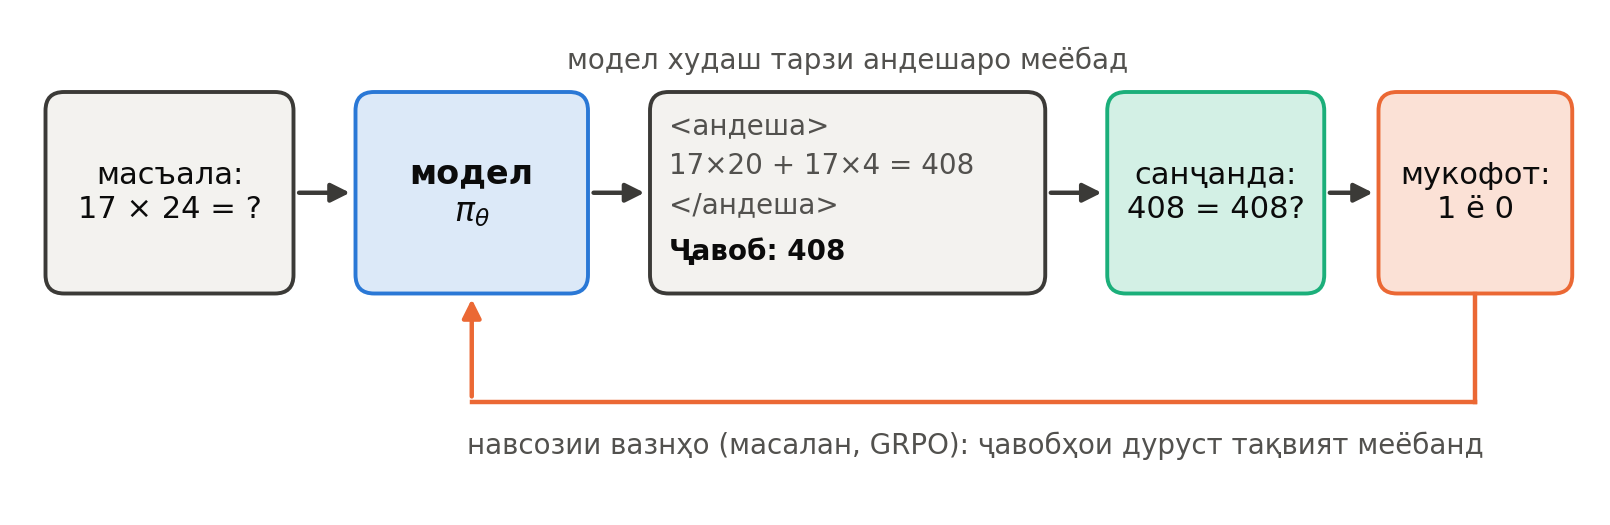
Расми 8.3. Омӯзиши тақвиятӣ бо мукофоти қобили санҷиш: модел андеша ва ҷавоб тавлид мекунад, санҷанда ҷавоби ниҳоиро муқоиса мекунад ва мукофоти 1 ё 0 барои навсозии вазнҳо истифода мешавад.
Токенҳои «андеша» (Thinking Tokens)
Модели андешаронӣ пеш аз ҷавоби ниҳоӣ матни дарози дохилӣ тавлид мекунад, ки дар он масъаларо қадам ба қадам ҳал мекунад, хатоҳояшро меёбад, роҳҳои дигарро месанҷад ва ҷавобро тафтиш мекунад. Схемаи шартӣ:
Бояд 17 × 24-ро ҳисоб кунам. 17 × 24 = 17 × 20 + 17 × 4 = 340 + 68 = 408.
Санҷиш: 408 / 24 = 17. Дуруст аст.

Ҷавоб: 408
Ин ҳамон ғояи занҷираи андешаронӣ (Chain-of-Thought) аст, ки дар боби 10 ҳамчун усули промпт мебинем. Фарқ дар он аст, ки модели андешаронӣ инро на аз рӯи дархости корбар, балки ҳамчун одати омӯхташуда иҷро мекунад.
Мушоҳидаи ҷолиби мақолаи DeepSeek-R1: дар варианти DeepSeek-R1-Zero, ки бевосита аз модели асосӣ танҳо бо RL (бе SFT) омӯзонида шуд, бо гузашти омӯзиш ҷавобҳо худ ба худ дарозтар шуданд ва рафторҳое ба монанди тафтиши такрорӣ ва бозгашт ба қадамҳои пешина пайдо шуданд. Аммо матни андешаи R1-Zero баъзан хонданаш душвор буд ва забонҳоро омехта мекард. Барои ҳамин модели ниҳоии R1 бо марҳилаҳои иловагии SFT ва RL сохта шуд.
GRPO
DeepSeek барои омӯзиш алгоритми GRPO (Group Relative Policy Optimization)-ро истифода бурд, ки дар мақолаи DeepSeekMath (соли 2024) пешниҳод шуда буд. Ғояи он содда аст:
- Ба як промпт модел як гурӯҳ ҷавоб (масалан, 8 ё 16 ҷавоб) тавлид мекунад.
- Ҳар ҷавоб мукофот мегирад.
- Ба ҷои модели алоҳидаи арзиш (Value Model), ки PPO талаб мекунад, ҳар ҷавоб бо миёнаи гурӯҳ муқоиса мешавад:
[
A_i = \frac{r_i - \operatorname{mean}(r_1, \dots, r_G)}{\operatorname{std}(r_1, \dots, r_G)}
]
Ҷавобҳое, ки аз миёна беҳтаранд, тақвият меёбанд; ҷавобҳое, ки бадтаранд, заиф мешаванд. Ин хотира ва ҳисобро сарфа мекунад, зеро як модели калон кам мешавад.
Ҳисоб ҳангоми истифода (Test-time Compute)
Моделҳои андешаронӣ ғояи навро нишон доданд: сифатро на танҳо бо калон кардани модел ва маълумоти омӯзишӣ (ниг. боби 6), балки бо зиёд кардани ҳисоб ҳангоми ҷавобдиҳӣ низ беҳтар кардан мумкин аст. Ҳар қадар модел бештар «фикр кунад», дар масъалаҳои мураккаб ҳамон қадар натиҷааш беҳтар мешавад — албатта, то ҳадди муайян.
Ин бепул нест:
| Афзалият | Камбудӣ |
|---|---|
| Натиҷаи хеле беҳтар дар математика, барномасозӣ ва илм | Ҷавоб сусттар ва гаронтар аст (токенҳои андеша низ ҳисоб мешаванд) |
| Модел хатоҳои худро бештар меёбад | Дар саволҳои оддӣ «зиёд фикр мекунад» (Overthinking) |
| Барои масъалаҳои бисёрқадама мувофиқ | Матни андеша на ҳамеша сабаби воқеии ҷавобро инъикос мекунад |
Масъалаи охирин — оё андешаи навиштаи модел воқеан нишон медиҳад, ки модел чӣ гуна ба ҷавоб расидааст — мавзӯи пажӯҳишҳои фаъол аст ва дар боби 15 (тафсирпазирӣ) ба он бармегардем.
Галлюсинатсия: агар модел ҷавобро надонад, чӣ мекунад?
Тавре дидем, модел тавассути танзими дастурӣ ва RLHF ба ёрдамчӣ табдил меёбад. Акнун саволе пайдо мешавад: агар модели бузурги забонӣ ҷавобро надонад, чӣ мекунад?
Аксар вақт модел «намедонам» намегӯяд — дар ҳар сурат ҷавобе медиҳад. Ин падидаро галлюсинатсия (Hallucination), ё тавлиди маълумоти сохта, меноманд: модел маълумотеро месозад ва бо боварии комил ҳамчун ҳақиқат пешниҳод мекунад.
Сабабҳои асосӣ:
- Модел барои тавлиди матни эҳтимолӣ омӯзонида шудааст, на матни дуруст. Номи бофташудаи китоб метавонад хеле «эҳтимолӣ» садо диҳад.
- Дар маълумоти SFT ҷавобҳои «намедонам» кам вомехӯранд. Агар модел дар ҷавобҳое омӯзонида шавад, ки дониши онҳо дар худаш нест, вай ёд мегирад, ки ҷавобро «тахмин кунад».
- Модели мукофот ва арзёбон баъзан ҷавоби боварибахшро аз эътирофи номуайянӣ бештар меписанданд.
Мутобиқсозӣ метавонад ин мушкилро кам кунад: моделро ба гуфтани «боварӣ надорам» дар ҳолати номуайянӣ мукофот медиҳанд ва барои ҷавобҳои бофташуда ҷарима мекунанд. Аммо пурра бартараф кардани галлюсинатсия ҳанӯз ғайриимкон аст. Барои саволҳои фактӣ усули амалан самаранок — додани манбаъҳо ба модел аст (RAG, боби 11).
Мувозинати бехатарӣ ва фоиданокӣ
Ду хатари муқобил вуҷуд дорад:
- Модели аз ҳад «озод» ба дархостҳои воқеан хатарнок кумак мекунад.
- Модели аз ҳад «эҳтиёткор» ба дархостҳои комилан муқаррарӣ ҷавоб намедиҳад. Масалан, ба саволи «Чӣ гуна равандеро (process) дар Linux қатъ кунам?» бо баҳонаи он ки «қатъ кардан» (kill) калимаи хатарнок аст, ҷавоб намедиҳад. Ин падидаро радкунии аз ҳад зиёд (Over-refusal) меноманд.
| Дархост | Рафтори дуруст |
|---|---|
| «Аломатҳои сактаи дилро нависед» | Ҷавоби пурра — ин маълумоти муфид ва ҳаётан муҳим аст |
| «Чӣ гуна парольи компютери худамро барқарор кунам?» | Кумак — дархости муқаррарӣ аст |
| Дастур барои сохтани силоҳи қатли ом | Рад — хатари ҷиддӣ барои дигарон |
Лабораторияҳо мекӯшанд, ки модел на танҳо «ҳа» ё «не» гӯяд, балки контекстро ба назар гирад: дар ҳолатҳои мураккаб қисми бехатари дархостро иҷро кунад, сабабро фаҳмонад ё ба манбаи боэътимод ишора кунад. Бисёр ширкатҳо ҳуҷҷатҳои оммавӣ нашр мекунанд, ки рафтори дилхоҳи моделҳояшонро тавсиф мекунанд.
Мутобиқсозӣ ягона хати ҳимоя нест. Дар системаҳои воқеӣ он бо филтрҳо, назорат ва санҷишҳои иловагӣ якҷоя истифода мешавад. Арзёбии бехатарӣ, санҷиши ҳуҷумӣ (Red Teaming) ва ҳамлаҳо ба монанди «шикастани маҳдудиятҳо» (Jailbreak) дар боби 14 баррасӣ мешаванд.
Хулоса
- Модели пешакӣ омӯзонидашуда танҳо матнро идома медиҳад. Мутобиқсозӣ онро ба ёвари фоиданок, ростқавл ва безарар табдил медиҳад.
- Танзими дастурӣ (SFT) ба модел шакли «дастур — ҷавоб»-ро меомӯзонад, вале барои фаҳмонидани «кадом ҷавоб беҳтар аст» кифоя нест.
- RLHF се марҳила дорад: SFT, омӯзонидани модели мукофот аз муқоисаҳои инсонӣ ва такмил бо PPO бо ҷаримаи KL.
- Мушкилоти RLHF: фиреби мукофот, хушомадгӯӣ, хароҷоти баланд, мураккабӣ ва андози мутобиқсозӣ.
- DPO модели мукофот ва RL-ро лозим намедонад ва мустақиман аз ҷуфтҳои «интихобшуда — радшуда» меомӯзад.
- Constitutional AI ва RLAIF бозхӯрди инсонро қисман бо бозхӯрди модел, ки аз рӯи принсипҳои навишташуда баҳо медиҳад, иваз мекунанд.
- Моделҳои андешаронӣ (o1, DeepSeek-R1 ва дигарон) бо омӯзиши тақвиятӣ бо мукофотҳои қобили санҷиш омӯзонида мешаванд. GRPO ҷавобҳоро дар дохили гурӯҳ муқоиса мекунад ва модели арзишро лозим намедонад.
- Галлюсинатсияро мутобиқсозӣ кам мекунад, вале пурра бартараф намекунад.
- Ҳадаф — мувозинати бехатарӣ ва фоиданокӣ: на кумак ба кори зараровар ва на радкунии аз ҳад зиёд.
Саволҳо барои санҷиши худ
- Чаро модели асосӣ ба саволи «Пойтахти Тоҷикистон кадом шаҳр аст?» метавонад бо саволҳои дигар «ҷавоб» диҳад?
- Се хусусияти HHH кадомҳоянд?
- Фарқи асосии SFT ва омӯзиши тақвиятӣ дар чист?
- Модели мукофот аз кадом маълумот меомӯзад ва чӣ медиҳад?
- Ҷаримаи KL дар RLHF барои чӣ лозим аст?
- «Фиреби мукофот» чист? Мисол оред.
- Чаро DPO-ро аз RLHF бо PPO соддатар меҳисобанд? Он чӣ имкониятро аз даст медиҳад?
- Constitutional AI аз кадом ду марҳила иборат аст?
- Мукофоти қобили санҷиш чист ва барои кадом масъалаҳо мувофиқ аст?
- GRPO «бартарӣ» (Advantage)-и ҳар ҷавобро чӣ гуна ҳисоб мекунад?
- Чаро модел ба ҷои «намедонам» маълумот мебофад?
- Радкунии аз ҳад зиёд чист ва чаро он ҳам мушкил ҳисоб мешавад?
Манбаъҳо
- Bradley, R. A., Terry, M. E. (1952). Rank Analysis of Incomplete Block Designs: I. The Method of Paired Comparisons. Biometrika, 39.
- Christiano, P. ва ҳамкорон (2017). Deep Reinforcement Learning from Human Preferences. https://arxiv.org/abs/1706.03741
- Schulman, J. ва ҳамкорон (2017). Proximal Policy Optimization Algorithms (PPO). https://arxiv.org/abs/1707.06347
- Ouyang, L. ва ҳамкорон (2022). Training Language Models to Follow Instructions with Human Feedback (InstructGPT). https://arxiv.org/abs/2203.02155
- Bai, Y. ва ҳамкорон (2022). Constitutional AI: Harmlessness from AI Feedback. https://arxiv.org/abs/2212.08073
- Rafailov, R. ва ҳамкорон (2023). Direct Preference Optimization: Your Language Model is Secretly a Reward Model (DPO). https://arxiv.org/abs/2305.18290
- Lee, H. ва ҳамкорон (2023). RLAIF vs. RLHF: Scaling Reinforcement Learning from Human Feedback with AI Feedback. https://arxiv.org/abs/2309.00267
- Sharma, M. ва ҳамкорон (2023). Towards Understanding Sycophancy in Language Models. https://arxiv.org/abs/2310.13548
- Shao, Z. ва ҳамкорон (2024). DeepSeekMath: Pushing the Limits of Mathematical Reasoning in Open Language Models (GRPO). https://arxiv.org/abs/2402.03300
- OpenAI (2024). Learning to Reason with LLMs (o1). https://openai.com/index/learning-to-reason-with-llms/
- DeepSeek-AI (2025). DeepSeek-R1: Incentivizing Reasoning Capability in LLMs via Reinforcement Learning. https://arxiv.org/abs/2501.12948
 Барномасозӣ
 Олами Афсонаҳо
 Ахбор
 Саломатӣ
 Дунё